- @qq_53129597


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
摘要:在使用Unsloth微调模型时,从HuggingFace下载模型遇到IP限制问题(Error 429)。主要原因是匿名用户频繁请求导致IP被限流。解决方法包括:1)获取HuggingFace的Read权限Token,添加到代码中(设置HF_TOKEN环境变量);2)临时方案如更换IP或等待1小时自动解除限制。推荐使用Token方法,可避免后续下载被限流。关键代码修改顺序:先设置镜像源HF_E
import resr=input('请输入一段英文:')print(re.sub('i ','I ',sr))
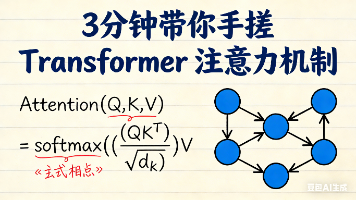
本文通过"查字典"的比喻解析Transformer的注意力机制。Query(Q)代表查询条件,Key(K)是索引标签,Value(V)对应具体内容。注意力机制通过计算Q与K的相似度,对V进行加权融合。数值演练展示了处理"fruit"时,模型会重点关注"apple"(权重0.79),少量关注"banana"(权重0.17
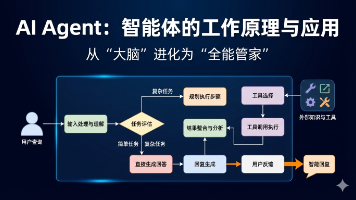
文章摘要: AIAgent(智能体)实现了从"缸中之脑"到"全能管家"的进化,为LLM配备了感知、工具和规划能力。其核心采用"双轨制"逻辑:先评估任务复杂度,再分流执行简单对话或复杂任务。对于复杂任务,Agent能自主拆解目标、调用工具并整合结果,具备自我纠错能力。这种架构如同操作系统,将LLM的推理能力转化为实际执行力,突破了数字与物理
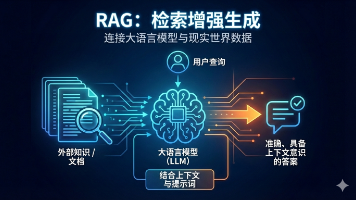
摘要:RAG(检索增强生成)技术通过"开卷考试"模式解决大模型的时效性和幻觉问题。其核心流程分为三阶段:1)索引阶段将文档切片并向量化存储;2)检索阶段计算用户问题与文档片段的相似度;3)生成阶段结合检索结果输出答案。RAG具有四大优势:避免幻觉、保持时效性、保护数据隐私、确保答案可溯源。该技术作为用户与大模型间的中间层,通过检索外部知识库增强提示词,约束模型仅基于最新资料作答
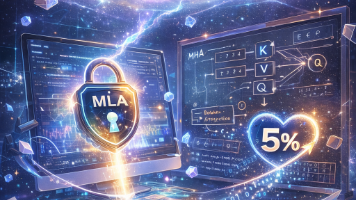
DeepSeek的MLA(多头潜在注意力)机制通过创新性的压缩存储方式大幅降低显存占用。与传统MHA(多头注意力)需要存储完整的K/V值不同,MLA将输入压缩为2个数的"压缩包"存储,利用矩阵结合律实现计算时无需还原原始数据。这种设计将显存占用降至MHA的1/4,同时保持相近性能表现。在初始化方面,预训练阶段采用标准初始化保证模型学习能力,而微调阶段则采用LoRA的特殊初始化策
摘要:DeepSeek的MLA和LoRA技术通过低秩分解实现高效参数压缩,将高维特征向量压缩为少量"精华数字"存储,使用时再还原。这一过程利用压缩器和生成器矩阵:前者提取核心特征(如从4维压至2维),后者恢复完整维度。该技术基于"低秩假设",在节省50%显存的同时保持计算效率,使大模型兼具轻量化和高性能特性。典型场景下,输入向量经过降维-升维处理后,能完整保

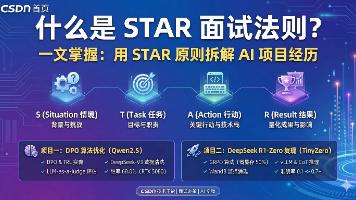
摘要:本文介绍如何运用STAR面试法则有效展示大模型项目经验。通过两个具体案例:1)基于DPO算法优化Qwen2.5模型,在单卡RTX5080上实现68%胜率;2)复现DeepSeek R1-Zero推理能力,采用GRPO算法节省50%显存。文章详细拆解了从项目背景、任务目标到具体行动和量化结果的完整叙述框架,并给出面试官可能关注的KL散度约束、GRPO优势等技术细节问题,帮助候选人将复杂技术项目
深度学习大模型训练中,学习率、训练轮数和批次大小是最关键的三个超参数。学习率建议:全量微调1e-5到5e-5,LoRA微调1e-4到3e-4;训练轮数根据数据量调整,通常3轮最佳;批次大小取决于显存容量,可使用梯度累积技术优化。合理设置这三个参数能显著提升模型训练效果和稳定性。
ToC与ToB业务的核心差异解析 摘要:ToC和ToB是两种截然不同的商业模式。ToC直接面向个人消费者,注重用户体验和情感驱动,典型如微信、抖音等,特点是决策快、用户量大、体验至上。ToB则服务于企业机构,强调理性价值和投资回报,如企业微信、阿里云等,具有决策链长、客户价值高、产品功能优先等特点。两者在用户角色、决策方式、产品设计、营销策略等方面存在本质差异:ToC追求爆款和流量转化,ToB看重