


- @qq_51399582


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本文详细介绍了多智能体路径规划(MAPF)中的经典算法CBS(Conflict-Based Search)。CBS采用两层搜索结构:高层在约束树上检测冲突并添加约束(禁止某智能体在特定时间占据特定位置/边),低层则对受影响智能体重新运行A*算法规划路径。文章通过伪代码和Python实例演示了CBS的实现,并重点澄清了"为何不能简单用等待动作解决冲突"的常见误区——等待可能导致连
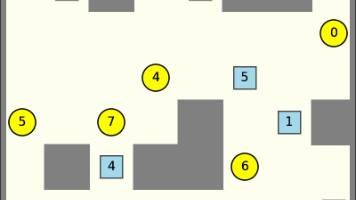
MAPPO 是一种多智能体强化学习算法,基于单智能体的 PPO (Proximal Policy Optimization) 算法进行了扩展,专门设计用于解决多智能体协作和竞争环境中的决策问题。要想更好的理解MAPPO算法的原理机制,得先从On-Policy 和 Off-Policy 两种算法类型出发。在强化学习中,on-policy 和 off-policy 算法根据策略更新时是否依赖当前策略的

Displayx检测显示屏:在购买电脑显示屏,对显示屏的显示效果还是十分关注的,毕竟直接影响了我们的使用体验。了解最多的可能也就是鲁大师的测试显示屏功能,但是鲁大师这个软件怎么说呢!有点小流氓,所以呢,就想着找一个绿色无广告的软件。个人认为DisplayX是一个十分不错的软件,主要有以下优点:1).全中文界面,用法也十分简单;2).绿色软件,没有什么捆绑软件;3).功能相对齐全,对液晶显示屏简单测

智能方法求解-圆环内传感器节点最大最小距离分布。采用了一种基于凸优化的方法来调整传感器节点在圆环区域内的位置分布,以最大化邻近节点之间的距离,从而减轻电磁互扰。智能方法采用了两种方式:1)一是采用模拟退火算法的优化思路不断调整节点位置,逐步优化最小距离;通过将模拟退火算法与序列二次规划(SLSQP)结合,首先使用模拟退火进行全局搜索,然后使用SLSQP进行精细化局部优化。2)二是结合遗传算法(Ge

今天是国庆节,祝祖国繁荣富强。正好也学习不下去,就想着写写博客,总结一下自己在参加2023年第20届中国研究生数学建模比赛的一些感受。1.基本介绍1. 竞赛时间:竞赛定于2023年9月22日8:00至2023年9月26日12:00举行。(五天四夜)
强化学习中的深度Q网络(DQN)是一种将深度学习与Q学习结合的算法,它通过神经网络逼近Q函数以解决复杂的高维状态问题。然而,DQN存在过估计问题(Overestimation Bias),即在更新Q值时,由于同时使用同一个网络选择动作和计算目标Q值,可能导致Q值的估计偏高。Double DQN(DDQN)引入了“双网络”机制来缓解这个问题,从而提高了算法的稳定性和收敛性。

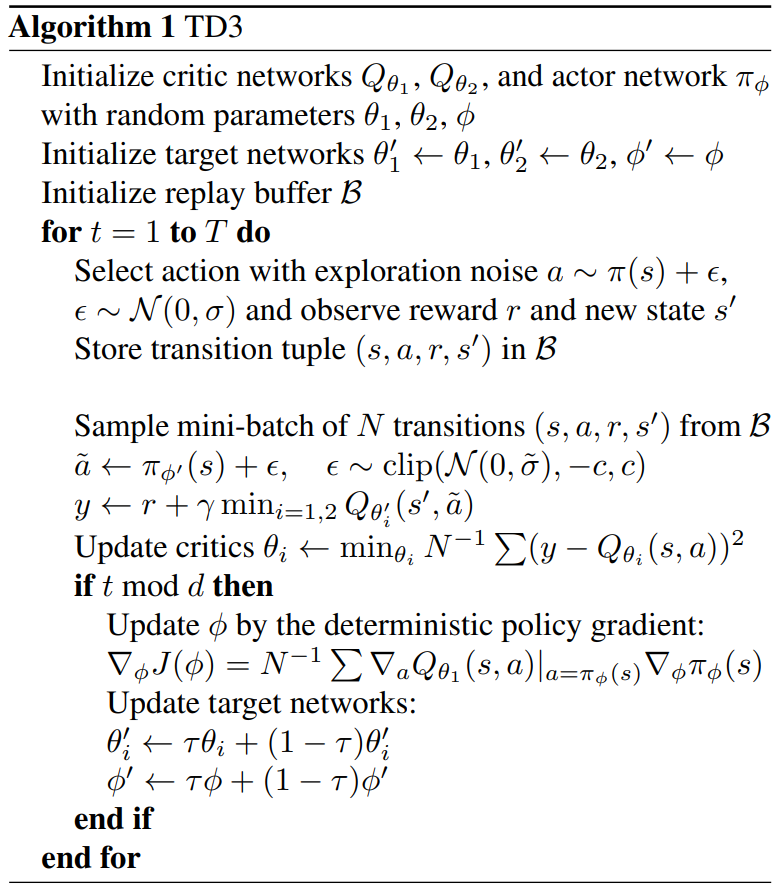
双延迟深度确定性策略梯度算法,TD3(Twin Delayed Deep Deterministic Policy Gradient)是强化学习中专为解决连续动作空间问题设计的一种算法。TD3算法的提出是在深度确定性策略梯度(DDPG)算法的基础上改进而来,用于解决强化学习训练中存在的一些关键挑战。
演员评论家,Actor-Critic算法是强化学习领域的一种重要方法,结合了“演员”(Actor)和“评论家”(Critic)两个部分,它结合了值函数估计和策略优化的优点。在理解其背景时,需要从强化学习的演化历史、策略梯度方法的局限性以及如何通过值函数辅助优化策略展开。文章用一个生活中的比喻来说明它的原理。

常说的发论文,一般所指为发表期刊论文,那么“期刊论文”是怎么定义的?并且我们经常听说“SCI一区二区三区四区”又是怎么区别的呢?了解一下JCR分区和中科院分区
独立Q学习 ---- IQL(Independent Q-Learning)是多智能体强化学习(Multi-Agent Reinforcement Learning, MARL)中一种经典且简单的算法,主要思想是将每个智能体视为独立的学习者,各自执行单智能体的 Q-learning 算法。尽管 IQL 是一个早期的方法,但它在处理多智能体任务时具有一定的应用价值。[Python] IQL实现(可移
