- @qq_44681809


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本研究提出了一种无须微调的视觉信号理解方法,即 视觉到语言分词器,它将图像转换为 LLM 词汇表中的离散标记,从而使冻结的 LLM 能够直接理解视觉信号,实现图像识别、视觉问答、图像恢复(去噪、修复等)等任务。

PMC-LLaMA 是针对医学领域的开源语言模型。研究贡献包括:医学知识注入:整合 480 万篇生物医学论文和 3 万本医学教材,以增强医学专业知识的理解能力。医学指令微调:构建了一个包含 202M tokens 的医学指令数据集,涵盖医学问答、推理和对话。
本文引入更强大的LLM扩展了LLaVA-NeXT,使多模态模型能够更好地展示来自 LLM 继承的视觉世界知识和逻辑推理能力。本文收集并开发了LLaVA-Bench (Wilder),聚焦日常生活中的视觉对话,并扩大数据规模以进行更全面的评估

本文改进现有的噪音采样技术,用于训练整流流模型,使其偏向感知上相关的尺度。还提出了一种基于 DiT 的 T2I 结构,它为两种模态使用独立权重,并实现了图像和文本 token 之间的双向信息流。

本文将计算密集型的流水线(SAM 3 + DINOv3)压缩到边缘设备可部署的程度,同时最大程度保留其在个体牲畜监控中的高精度。核心是对 SAM 3 的 backbone 蒸馏,并直接采用 DINOv3 的预蒸馏版本,同时辅以专门设计的损失函数和内存管理策略。

本研究提出一种 “即时脑-语音” 神经假体系统,通过实时解码肌萎缩性侧索硬化症患者大脑中的神经活动,实现语音合成和音频反馈,恢复交流能力。不同于此前仅将神经信号转译为文字的方式,该系统可直接合成语音,包含语调、重音、旋律等副语言特征,即便缺乏训练用的真实语音数据,仍可实现较高质量的合成结果

Dolphins 是一个新型的视觉语言模型(VLM),它能够处理多模态输入(视频、图像、文本指令和历史控制信号),并结合情境指令微调和接地链式推理,提高对驾驶场景的理解和适应能力
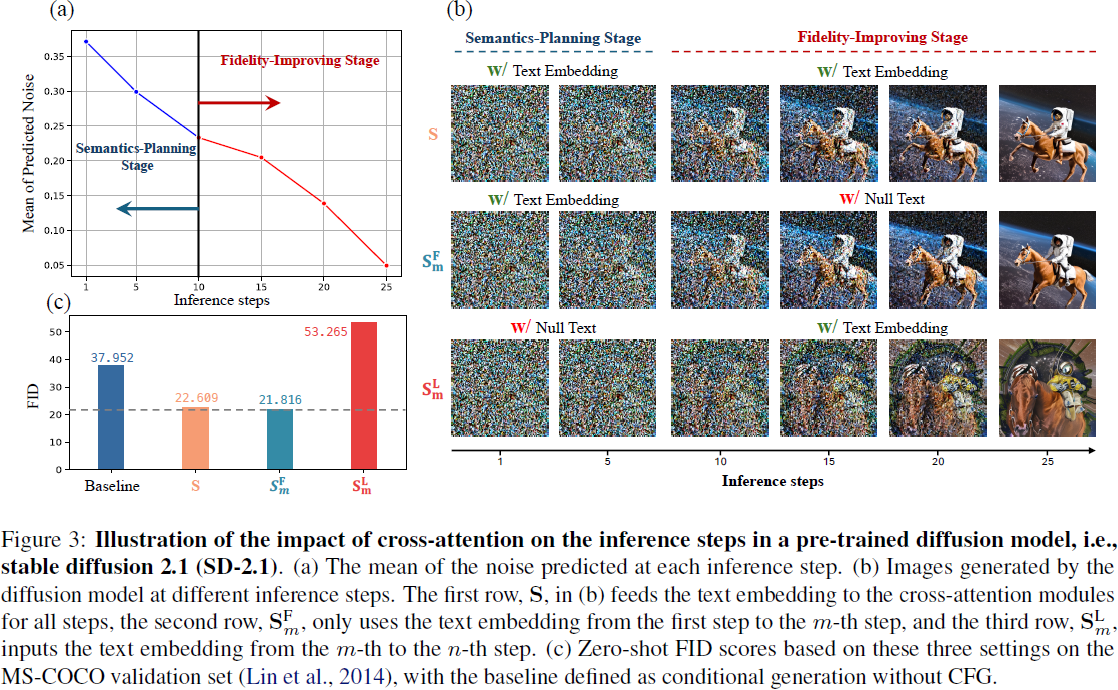
T-GATE 发现推断过程可分为依赖交叉注意力来使用文本引导的语义生成阶段和增强保真度阶段。在后一阶段忽略文本,可在保持模型性能的同时降低计算复杂度。基于此,T-GATE 在交叉注意力输出收敛后将其缓存,并在剩余的推理步骤中保持不变。
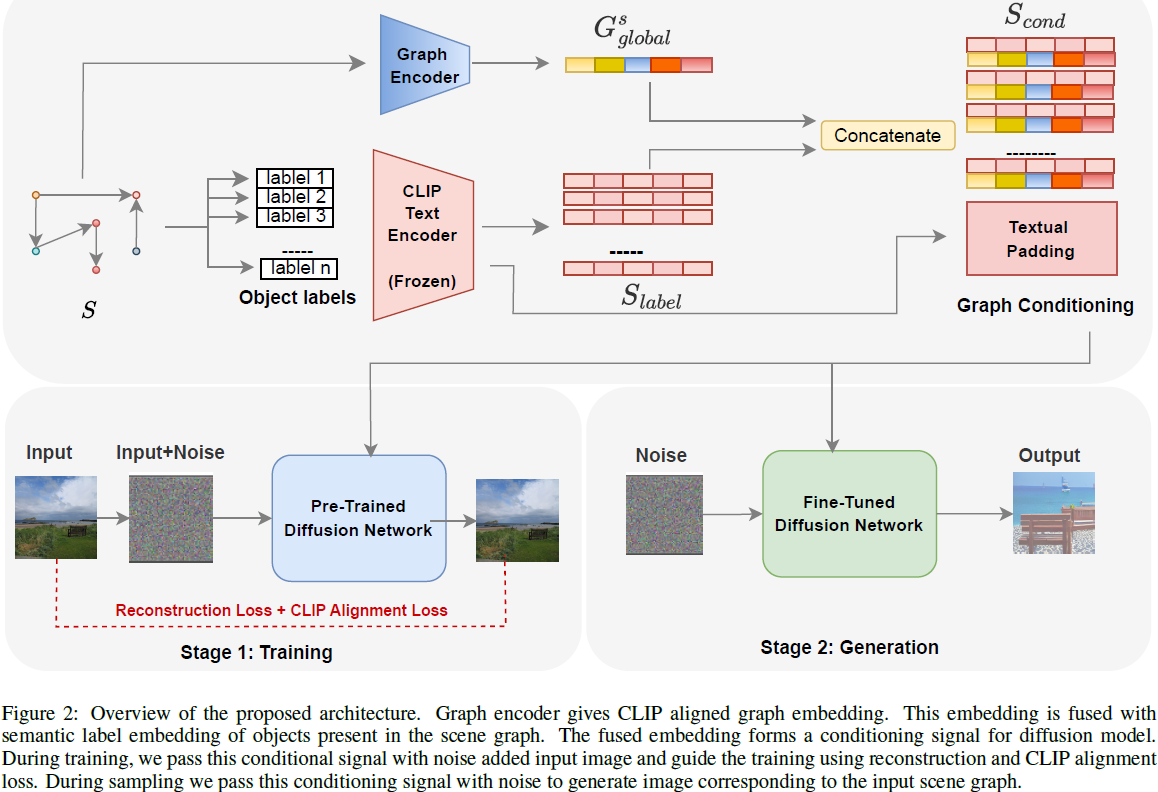
本文提出无需预测布局的场景图生成图像。首先预训练场景图编码器,然后使用基于对象嵌入和关系嵌入创建 CLIP 引导的调节信号来微调预训练的扩散模型。
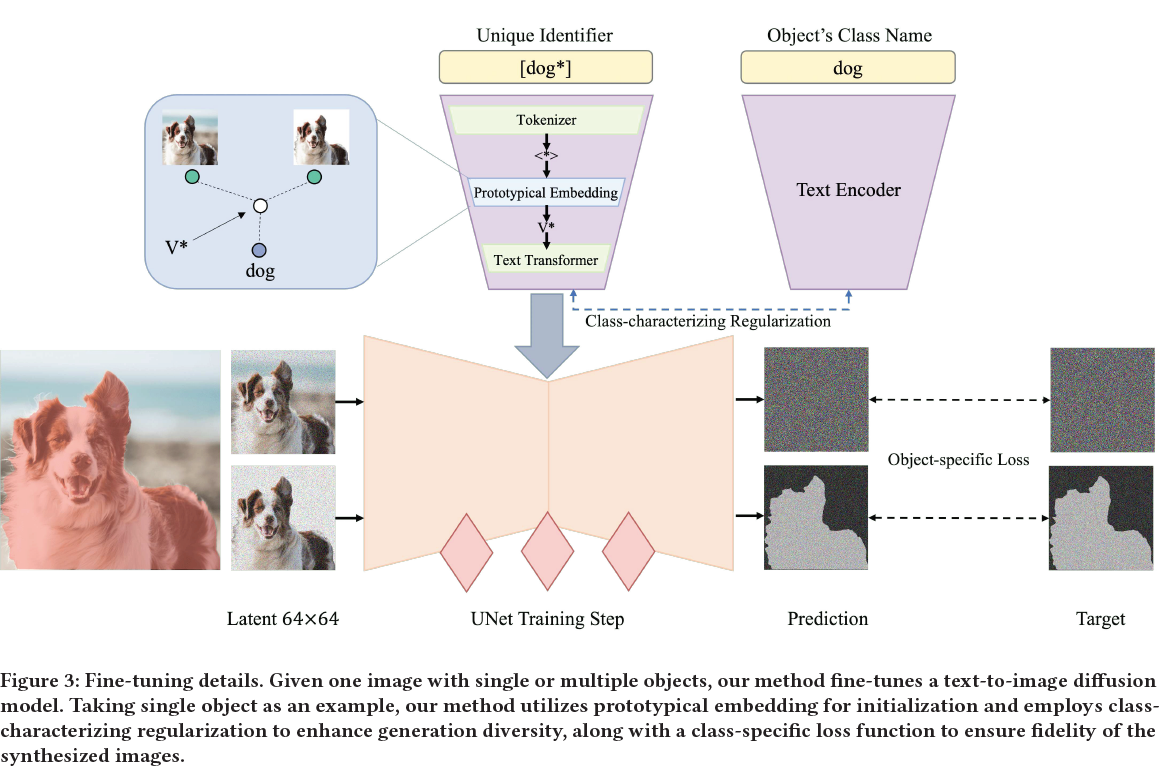
本文基于对象的外观和其类别初始化一个原型嵌入,然后对扩散模型进行微调。微调时使用类别特征正则化保留对对象类别的先验知识,并引入对象特定的损失来进一步提高保真度。这也可以用于植入多个对象。