- @qq_43854103


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本文提出了一种名为“Diffusion Reward”的新框架,利用视频扩散模型从专家演示视频中学习奖励函数,从而指导强化学习智能体解决复杂的视觉操作任务。
研究者提出名为MiVLA的视觉-语言-动作(VLA)模型,通过“人机相互模仿预训练”机制,融合易获取的模拟机器人数据(提供机器人操作先验)和人类日常视频数据(提供真实场景行为知识),解决真实机器人数据稀缺的问题,最终提升模型在模拟和真实机器人平台上的泛化能力。
本文提出了一种名为StableWorld的方法,通过智能地“扔掉”那些开始变模糊或变形的历史画面,只保留清晰的画面作为参考,从而让AI生成的长视频在长时间互动中保持稳定,不再“崩坏”。
本文发布了一个名为 EmbodiedScan 的超大规模室内3D场景数据集,并基于此提出了一个名为 Embodied Perceptron 的基准模型,旨在解决具身智能体在第一人称视角下对3D环境进行全方位感知和理解的问题。

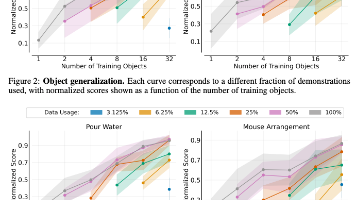
作者通过收集海量机器人操作数据,发现并验证了数据 scaling law,证明了只要收集足够多样的环境和物体数据,简单的模仿学习就能让机器人学会零样本泛化。
本文开发了一套能让AI游戏角色在玩《宝可梦》时“自己教自己”怎么玩得更好的系统,不用每次失败后重头开始,而是像人一样从经验中积累技能和记忆,持续变强。
腾讯团队研发了一套专为机器人设计的视觉语言模型(VLM),通过独特的架构和训练方法,让机器人能更精准地看懂世界、进行空间推理并规划行动。

只用了很少的真机训练数据(7.5k条),通过“P图”扩充数据和“预测动作片段”而非单步动作,训练出了一个能听懂人话、在没见过的厨房场景里也能完成多种复杂任务的通用机器人。
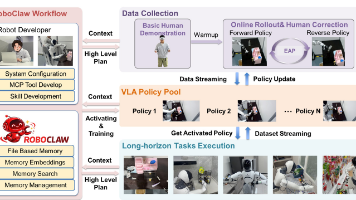
本文提出了一种名为 RoboClaw 的机器人框架,通过让机器人自己“收集数据、学习技能、执行复杂任务”,解决了长程任务中依赖人工重置环境和技能衔接脆弱的难题。
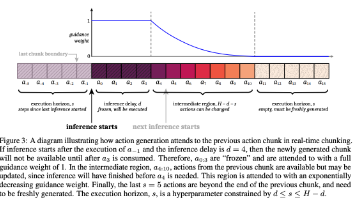
在模拟实验中,当推理延迟较高时,其性能甚至优于推理时RTC。RTC在模拟和真实世界的灵巧操作任务中(如点燃火柴)都表现出极强的延迟鲁棒性,显著提升了任务完成速度和成功率。这篇论文提出了一种名为“实时分块”(RTC)的推理算法,让机器人能在不等待模型计算完成的情况下,平滑地执行下一个动作序列,从而解决了大型模型推理延迟高导致的动作卡顿问题。这篇论文提出了一种名为“训练时RTC”(Training-t