


- @qq_41996852


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
最新安可测评新增时序数据库品类,系行业标志性突破。DolphinDB 依托全自研技术与丰富行业落地经验成功入选,也印证了国产时序数据库技术实力与应用价值全面提升。
非技术读者:知道时序数据库能帮企业 “降本提效”,比如设备少停机、系统少故障,是数字化转型的关键工具。特别是 DolphinDB,以其国产化优势和强大功能,为企业在数字化浪潮中提供了可靠的数据管理和分析手段,助力企业实现自主可控的数字化转型。企业决策者:通过选型速查表,30 秒确定适合自己的产品,避免踩 “高价低效” 的坑。对于大中型国产企业,在复杂业务场景下,DolphinDB 凭借其国产可控、
在钢铁行业数智化转型的浪潮中,球团生产线作为钢铁冶炼的关键环节,正面临着海量工控数据爆发式增长与复杂工艺实时管控的双重挑战。某头部钢铁集团(下称“ A 公司”)通过引入 DolphinDB 多模引擎与流计算框架,成功破解带式焙烧机场景下的数据存储、实时计算与高效分析难题,为国产时序数据库在重工业领域的应用树立了标杆。
工业试验平台的数据存储与处理面临多方面的挑战,来看看时序数据库 DolphinDB 为其提供了什么样的解决方案吧~
Kafka 是一个高吞吐量的分布式消息中间件,可用于海量消息的发布和订阅。当面对大量的数据写入时,以消息中间件接收数据,然后再批量写入到时序数据库中,这样可以将消息中间件的高并发能力和时序数据库的高吞吐量联合起来,更好地解决海量数据的实时处理和存储问题。本篇教程,我们会向大家详细介绍 DolphinDB Kafka 插件的使用方式,并以一个“DolphinDB + Kafka 实时计算k线”的案例
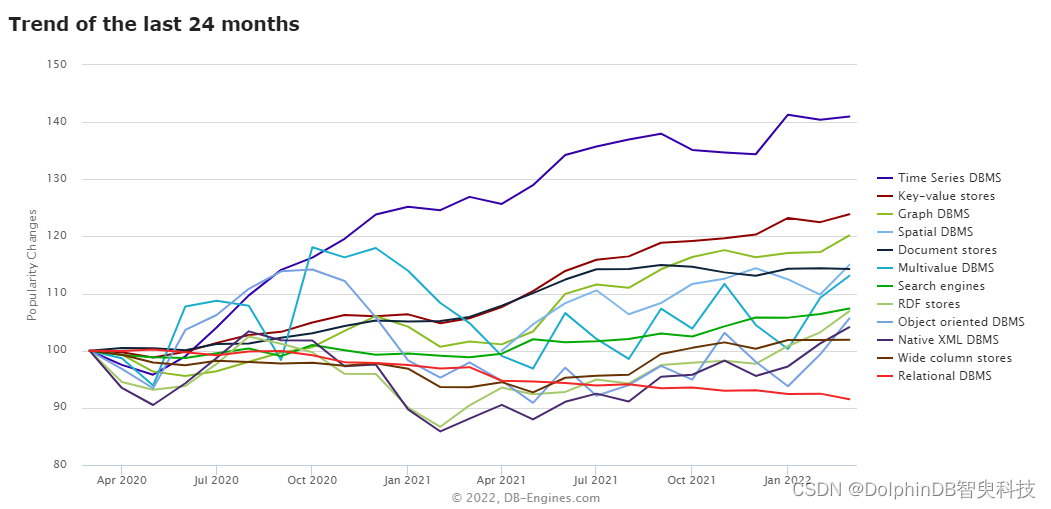
DB-Engines最新发布的2022年3月时序数据库排名榜单中,国产时序数据库DolphinDB继2月荣登该榜单前10后,又前进至第9名,也是目前唯一排名前10的国产时序数据库。自2019年参与DB-Engines排名以来,DolphinDB凭借广大用户的支持与产品优异的性能,排名一路飙升。
DolphinDB和Druid都是分布式的分析型时序数据库。尽管前者使用c++开发,后者使用java开发,两者在架构、功能、应用场景等方面有很多共同点。本报告在SQL查询、数据导入、磁盘占用空间等方面对两者进行性能的对比测试。测试数据集使用约300GB的美国股票市场交易与报价数据。通过测试我们发现:DolphinDB的数据写入速度大约是Druid的30倍。DolphinDB的查询速度是Druid的
永丰金证券是一家在台湾经济业务市占率排行第四的大型券商,外部用户和内部员工都是通过各类电子平台接入到系统来提交服务需求,例如 Web、手机 App、Windows Application 以及 B2B、B2C API 等等。目前,永丰金证券各个电子平台的服务需求处理与回应都是由资讯部门来完成的,据了解平台最高同时在线人数可以达到 12000 人,其中行情数据资料的查询、处理、落地和再应用是最繁重的
DolphinDB提供了多种灵活的数据导入方法,来帮助用户方便的把海量数据从多个数据源导入。具体有如下4种途径:通过文本文件导入通过二进制文件导入通过HDF5接口导入通过ODBC接口导入1. DolphinDB数据库基本概念和特点本章中多处使用到DolphinDB的数据库和表的概念,所以这里首先做一个介绍。在DolphinDB database 里数据以结构化数据表的方式保存。数据表按存储介质可以
内存表是DolphinDB数据库的重要组成部分。内存表不仅可以直接用于存储数据,实现高速数据读写,而且可以缓存计算引擎的中间结果,加速计算过程。本教程主要介绍DolphinDB内存表的分类、使用场景以及各种内存表在数据操作以及表结构(schema)操作上的异同。1. 内存表类别根据不同的使用场景以及功能特点,DolphinDB内存表可以分为以下四种:常规内存表键值内存表流数据表MVCC内存表1.1