


- @qq_39308071


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本文延续吴恩达《Generative AI for Everyone》学习,聚焦生成式AI在写作、阅读、聊天中的应用及能力边界。结合金融支付场景,强调大模型擅长语义理解与非结构化文本处理,但受限于幻觉、数据截断与结构化计算短板。提出“自然语言+工具调用”落地路径,通过分段输入、人工核验与角色限定规避风险。基于Transformer自注意力机制,判断其将率先替代合同条款提取、客服诉求归类等纯文本处理
今日转型LLM开发,学习吴恩达《Generative AI for Everyone》前两课,聚焦生成式AI核心逻辑:区分监督学习(需标注数据)与自监督学习(无须人工标注,通过预测下一个token训练);理解LLM本质是“基于上下文的续写预测”,非创造;明确基座模型、微调模型与API服务三者差异。结合金融支付强合规场景,优先选择API模式,降低落地成本,聚焦系统集成与安全合规,实现高效应用。
Nginx 500错误(Internal Server Error),主要指的是服务器内部错误,即服务器遇到意外情况,无法完成请求导致返回出错。②如果是too many open files,修改nginx的worker_rlimit_nofile参数,使用ulimit查看系统打开文件限制,修改/etc/security/limits.conf。如果上面两种情况都不存在,那么500错误可能是由于模

工具推荐和常用事例-typora
thread 'main' panicked at 'called `Result::unwrap()` on an `Err` value: Os { code: 2, kind: NotFound, message: "系统找不到指定的文件。" }', src\main.rs:31:55note: run with `RUST_BACKTRACE=1` environment variable
很多人会想当然用 SELECT '表头' UNION ALL SELECT 数据 INTO OUTFILE,但 TiDB/MySQL 里,INTO OUTFILE 只会捕获最后一条 SELECT 的输出,前面的表头直接被忽略,导出后只有数据,没有表头。这是最常见的错误:先 echo "表头" > 文件,再用 mysql -e "查询" > 文件,第二个 > 会直接清空文件内容,覆盖掉前面的表头,导
摘要:本文深入解析MySQL与TiDB执行计划的本质区别,帮助开发者快速掌握TiDB调优技巧。核心差异在于:MySQL关注单机索引优化,TiDB侧重分布式任务下推。文章提供两种数据库Explain字段映射表,对比常见慢SQL特征(如MySQL的Using filesort对应TiDB的root节点Sort算子),并给出TiDB专属调优方案:优先cop[tikv]下推、及时更新统计信息、减少root
本文深度解析TiDB分布式数据库的三大核心架构组件及其运行原理。PD集群作为"大脑"负责全局元数据管理、时间戳授时(TSO)和数据路由;KV集群采用键值存储引擎,通过Region分片和Raft算法实现数据高可用;无状态TiDBServer提供MySQL协议兼容接口。系统采用本地存储设计,各组件支持横向扩展:PD/KV建议奇数节点保证Raft共识,计算层可弹性扩缩。这种将负载均衡
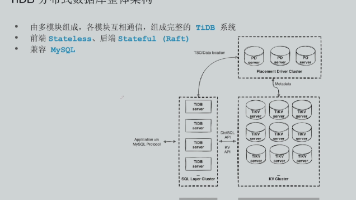
TiDB采用分布式存储架构,以Region为最小分片单元(默认96MB),通过Raft协议实现三副本高可用。底层由RocksDB提供持久化存储,支持MVCC多版本机制(更新追加新版本,旧版本保留),实现快照读与读写并发。分布式SQL通过协处理器下推计算到TiKV节点并行执行,利用Raft多副本实现容错(3副本允许1节点故障)。整体架构实现数据强一致、高并发读写与故障自动恢复,对业务透明。