


- @qq_38915354


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
MaskDecoder类是掩码预测模型的主体,它接收图像特征、点和框的嵌入以及掩码嵌入作为输入,通过Transformer将它们编码为掩码的表示形式。同时,它还有一些后续处理的步骤,如通过超网络预测每个掩码的质量,以及通过卷积转置层将掩码上采样到原图尺寸。它输入每个掩码的表示形式,并输出一个长度等于掩码数量加一的向量,其中第一个元素是无用的预测(即掩码为零的情况)。接着,这个向量将作为加权掩码特征
系列文章目录文章目录系列文章目录前言一、RISC-V汇编语言简介汇编语言的优缺点二、汇编语言语法介绍三、编译工具1.汇编器1.汇编器1.汇编器1.汇编器2.读入数据总结前言之前简单的讲过了RISC-V指令集,接下来我将简单的介绍一下RISC-V的汇编。更直观的去了解,C语言程序如何一步步变成机器语言并让机器执行程序。提示:以下是本篇文章正文内容,下面案例可供参考一、RISC-V汇编语言简介汇编语言

计算机系统基础(三)之通用寄存器本文主要结合上文关于标志寄存器的内容,解释关于通用寄存器相关的知识。文章目录计算机系统基础(三)之通用寄存器前言一、通用寄存器是什么?二、8086CPU的通用寄存器AX,BX,CX,DX 称作为数据寄存器:SP 和 BP 称作为指针寄存器:SI 和 DI 称作为变址寄存器:3.八个通用寄存器介绍3.1 数据寄存器3.1.1 AX 寄存器:3.1.2 BX 寄存器:3
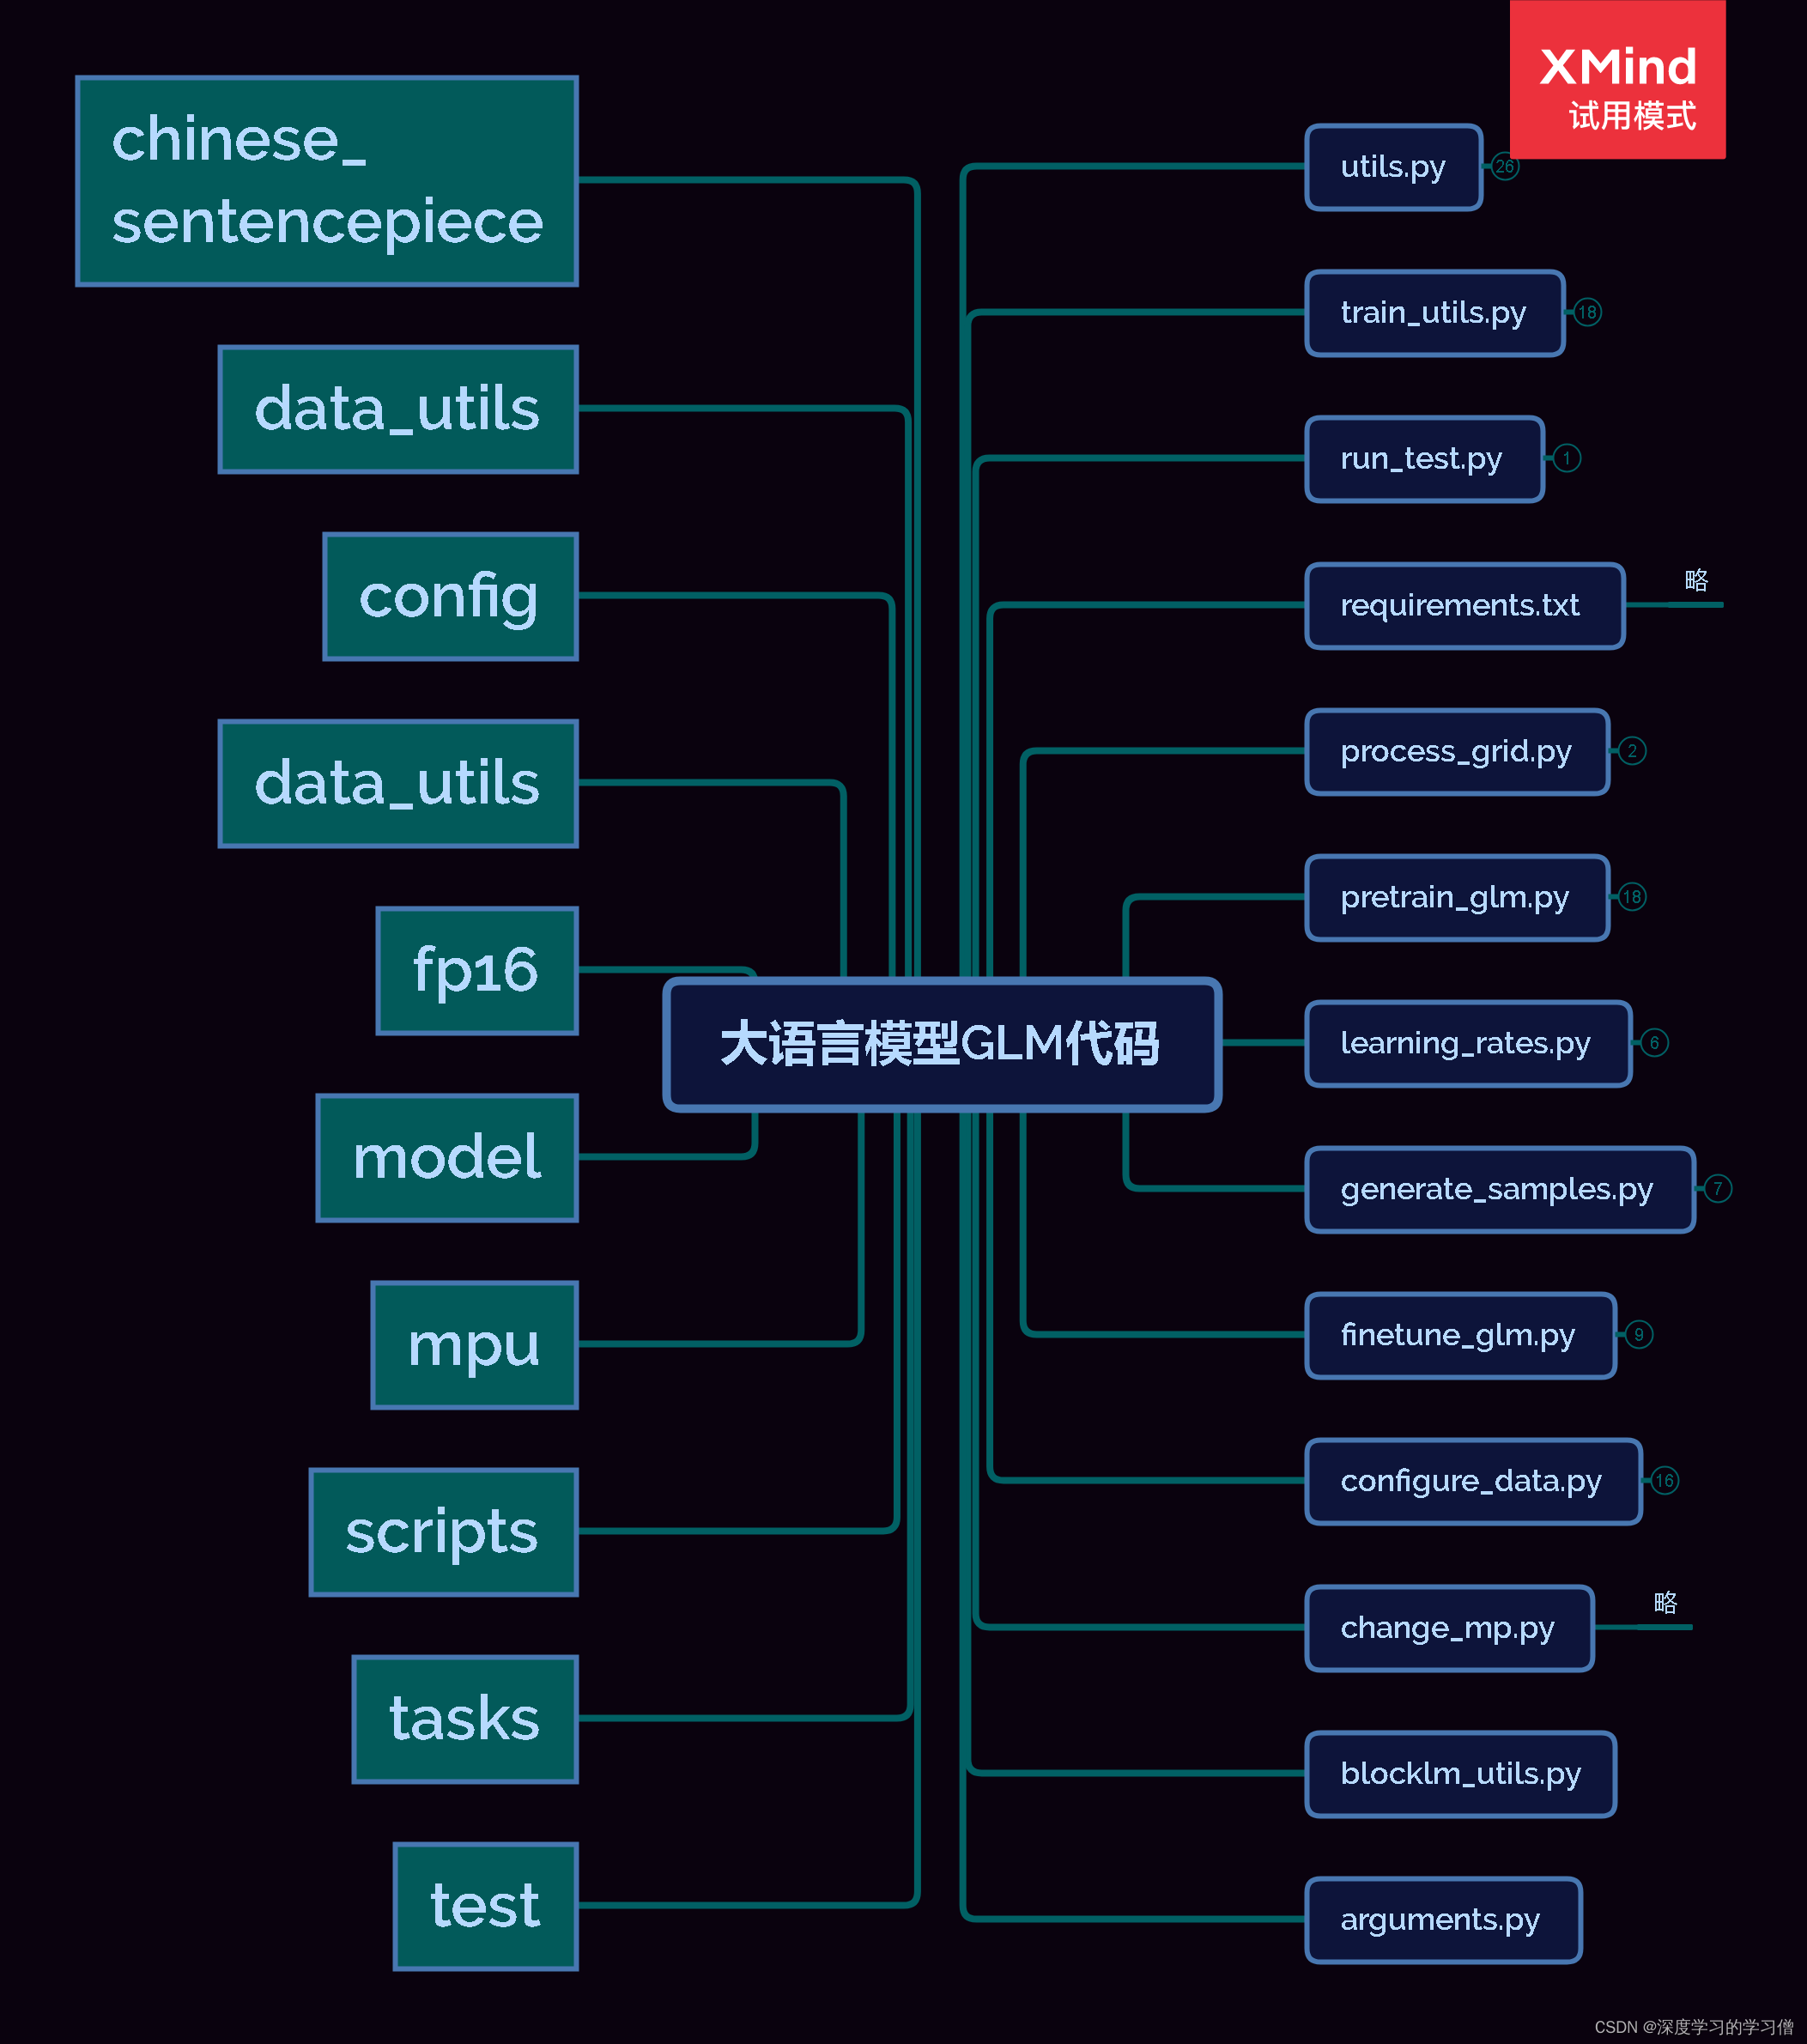
大语言模型GLM
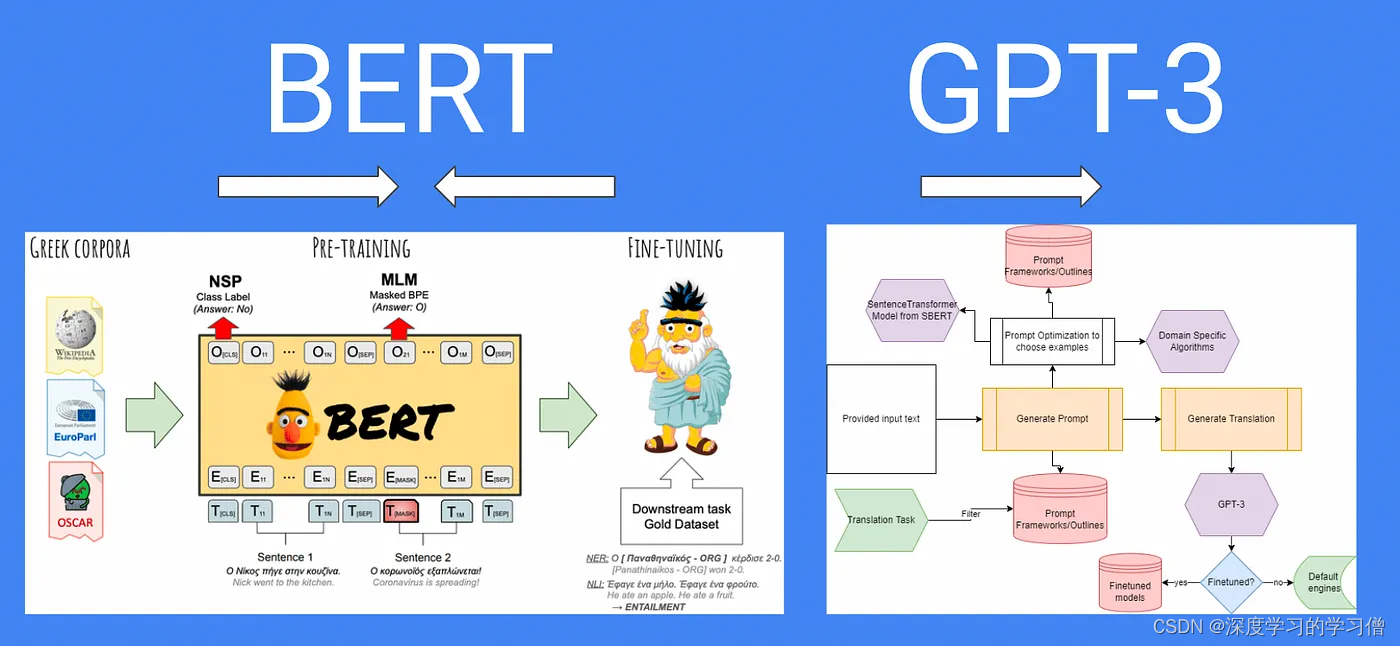
GPT:GPT是一种基于Transformer的生成式预训练模型,其目标是通过自回归语言模型预训练来学习生成连贯文本的能力。BERT:BERT是一种基于Transformer的预训练模型,它的目标是通过双向语言模型预训练来学习上下文相关的词表示。通过大规模的预训练数据和迭代的优化过程,
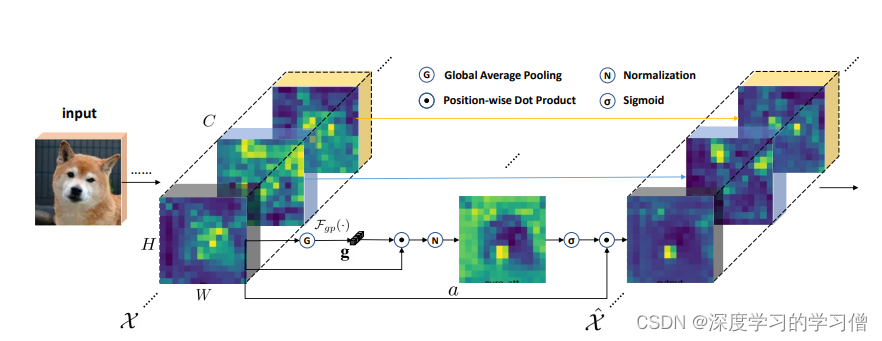
然而,这些子特征的激活往往在空间上受到相似模式和噪声背景的影响,从而导致错误的定位和识别。本文提出了一个空间组增强(SGE)模块,该模块可以通过为每个语义组中的每个空间位置生成一个注意因子来调整每个子特征的重要性,从而每个单独的组可以自主地增强其学习的表达,并抑制可能的噪声。注意因素仅由各组内部的全局和局部特征描述符之间的相似性来引导,因此SGE模块的设计非常轻量级,几乎没有额外的参数和计算。的方
Tokenizer与词向量是NLP中两个核心概念:Tokenizer负责将文本切分成模型可处理的tokens(词/子词/字符),词向量则负责语义表示。传统NLP需要手动处理分词、构建词典、数字映射等步骤,预训练模型通过AutoTokenizer一键完成。主流分词算法包括BPE、WordPiece等,HuggingFace的Tokenizer API支持编码(文本→ID)、解码(ID→文本)双向转换