


- @qq_38662930


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
在这个示例中,我们定义了一个SkipListNode结构来表示跳表的节点,并定义了一个SkipListIterator类来实现迭代器。在SkipList类中,我们提供了begin和end方法来获取迭代器,并在main函数中展示了如何使用这些迭代器来遍历跳表。在C++中,跳表是一种高效的数据结构,用于存储有序数据并支持快速查找、插入和删除操作。为了在C++类中实现跳表迭代器,你需要定义一个迭代器类,
在中定义为单次迭代能处理的最大 token 数:1│ max_num_batched_tokens 对并发的影响 ││ 影响类型 │ 说明 ││ 直接限制 │ ❌ 不直接限制最大并发数上限 ││ 间接影响1 │ ✅ 影响每轮新增请求数 ││ │ 值越大→新请求进入越快 ││ 间接影响2 │ ✅ 影响达到最大并发的速度 ││ │ 值越大→越快达到max_num_seqs ││ 极端情况 │ ⚠️ 小
当KV缓存空间不足时,系统会驱逐部分缓存块,并在需要时重新计算被驱逐的部分,而不是将它们交换到CPU内存。当KV缓存空间不足时,系统会驱逐部分缓存块,并在需要时重新计算被驱逐的部分,而不是将它们交换到CPU内存。当系统遇到KV缓存空间不足时,会自动触发recompute机制,并输出相应的警告信息。当系统遇到KV缓存空间不足时,会自动触发recompute机制,并输出相应的警告信息。重新加入wait
有KV offloading配置:先尝试CPU转移,失败后才抢占运行中请求无KV offloading配置:直接使用RECOMPUTE抢占运行中请求RECOMPUTE始终可用:作为默认的兜底机制,确保系统稳定性这种设计提供了最大的灵活性,充分利用CPU内存扩展GPU容量,同时保证在极端情况下仍能正常运行。
coord_socket.send(b"\x01") 的含义:XSUB socket 用发送一字节 b"\x01" 的方式告诉对面的 XPUB socket"我已经连接好了,请把后续广播消息也发给我"这是 ZMQ XPUB/XSUB 协议规定的订阅握手方式不会阻塞,相当于一个信号/通知让 Coordinator 可以精确知道"所有Engine都准备好了"再安全地广播 READY 启动整个系统这行代
Hybrid Load Balancing = (外部的、粗粒度的 HTTP 流量分发) + (内部的、精细化的本地引擎调度)所以,“Hybrid” 这个词非常贴切,因为它不是单纯的外部模式(因为节点内部有智能调度),也不是单纯的内部模式(因为流量的初次分发是由外部完成的,且调度范围是本地化的)。对比项内部负载均衡 (Internal)外部负载均衡 (External)混合负载均衡 (Hybrid
VBS-based Admission Control 通过。
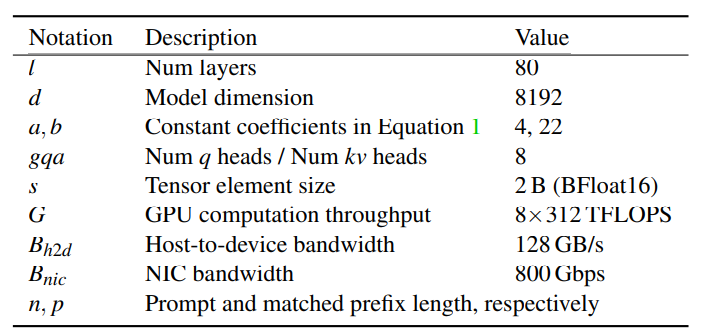
作为模型即服务(MaaS)提供商,Kimi [5] 的核心目标之一是解决一个包含多重复杂约束的优化问题:优化目标是最大化整体有效吞吐量(直接影响收入),而约束条件则体现为不同层级的 SLOs。该平台以 KVCache 为中心,采用分离式架构——不仅将预填充(prefill)和解码(decoding)集群解耦,还通过高效利用 GPU 集群中未被充分利用的 CPU、DRAM、SSD 和网卡(NIC)资
正如你所看到的,整个系统的吞吐量随着GPU的数量线性扩展,经过一定的操作后,添加更多的GPU并不会导致每次迭代的显著放缓。环形allgather与散列归约完全相同(有N-1次发送和接收的迭代),except相反的是,GPU们接收到的值,GPU们简单地覆盖块。在接下来的迭代中,该过程继续进行,到最后,每个GPU都会有一个块,其中包含该块在所有GPU上的所有值的和。系统中有N个GPU,每个GPU都有同

当某请求任务完成后, 系统动态从批次中删除, 并释放对应的显存,当有新请求时, 先单独执行prefill , 这样可以复用已经完成的请求的显存。用户会发送非常多的推理请求, 如果串行处理这些用户的请求, 如果用户的问题的tokens 数量较小, 无法充分利用GPU并行处理能力。使用naive baching.当用户请求到达时, 不立即处理, 而是积累到一定请求后,按批次处理。不申请最大显存,而是动