- @private_void_main


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本文介绍了Transformer模型中位置编码的必要性及两种主要实现方式。首先指出Transformer缺乏序列顺序信息,因此需要位置编码来补充单词位置信息。传统绝对位置编码使用正弦余弦函数生成固定位置向量,但存在长文本位置信息不足的问题。随后重点介绍了旋转位置编码(RoPE),它通过旋转矩阵将相对位置信息融入自注意力计算,使内积结果仅与相对位置相关。RoPE的优势在于能更好学习token间的相对

自注意力机制是Transformer模型的核心组件,它通过查询(Q)、键(K)、值(V)三个向量实现序列元素间的动态关联计算。具体过程包括:将输入嵌入向量与学习得到的权重矩阵相乘生成Q、K、V向量;通过点积计算注意力分数并进行√dk缩放以防止因高维导致的数值不稳定;最后对分数进行Softmax归一化并加权求和得到输出。其中,除以√d是关键技术,它能将点积结果的方差控制在1,避免梯度爆炸问题,确保模
网上关于IIC协议的讲解颇多,但是对于初学者而言,看网上的例程代码总是很模糊,因为总有一两个代码看不懂,而看不到过多的解释,我这里主要是针对自己初学的时候走的许多弯路,将自己的所有所有见解落实到代码上,将每一行代码为什么这么做说清楚,尽量使大家明白,少走弯路IIC协议简介:两线式串行总线,一根数据线SDA和时钟线SCL,下面直接是IIC的时序图,具体每一步的操作和IIC协议的详解我将在代码上给大家
蓝桥杯数码管原理图:数码管内部就是8个LED组成的,LED的阴极全部连接在一起就是共阴极数码管,反之就是共阳极数码管,这个公共端用一个引脚引出用于位选,由于二极管是单向导电,对共阳极数码管而言,我们想要位选这个数码管就要给位选的引脚高电平,二极管一端已经是高电平了,段选就需要给另外一端一个低电平,共阴极数码管分析思路一样.我们看一下原理图,首先我们看一下动态数码管的原理图,首先说明一下我们蓝桥杯的
【代码】AMD CPU下pytorch 多GPU运行卡死和死锁解决。
本文整理了深度学习与数学中常用的希腊字母表,包含大小写、英文/中文注音及其典型含义。重点字母包括:α(学习率)、β(动量参数)、γ(折扣因子)、δ(梯度)、θ(模型参数)、λ(正则化系数)、μ(均值)、σ(标准差/Sigmoid函数)等。使用时需注意:同一字母在不同领域可能含义不同(如σ可表示求和或标准差),书写时需区分易混淆字母(如ν与v)。此外,模型参数的表示在不同学科存在差异(θ与w)。本表

本文深入探讨了旋转位置编码(RoPE)及其扩展方法YaRN。RoPE通过旋转矩阵在query和key向量中注入位置信息,巧妙利用不同频率编码近距离和远距离位置关系。传统上下文窗口扩展方法(如位置内插)存在分辨率下降问题。YaRN基于NTK理论,提出非均匀缩放策略:高频维度保持原样,低频维度进行压缩。该方法通过引入阈值参数区分不同频率区域,实现更精细的扩展控制。相比直接内插,YaRN能在保持模型微观
linux 下安装cuda 11.8 驱动以及开发包教程,以centos 7为例
本文深入探讨了旋转位置编码(RoPE)及其扩展方法YaRN。RoPE通过旋转矩阵在query和key向量中注入位置信息,巧妙利用不同频率编码近距离和远距离位置关系。传统上下文窗口扩展方法(如位置内插)存在分辨率下降问题。YaRN基于NTK理论,提出非均匀缩放策略:高频维度保持原样,低频维度进行压缩。该方法通过引入阈值参数区分不同频率区域,实现更精细的扩展控制。相比直接内插,YaRN能在保持模型微观
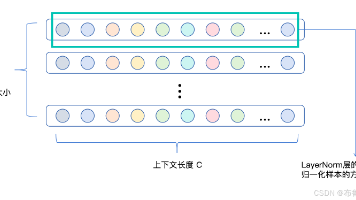
摘要:归一化是训练深层网络的关键技术,用于解决梯度消失或爆炸问题。文本领域采用LayerNorm(LN)而非BatchNorm(BN),因文本长度不固定且含无意义padding。LN对每个样本所有特征归一化,而RMSNorm简化计算仅用均方根。DeepNorm则针对超深层网络设计,结合残差连接优化数据分布。归一化位置分为层前(Pre-Norm)和层后(Post-Norm),前者更易训练但后者能力更