


- @pandamf


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
1.1 原生组件跳转1.2 方法接口跳转。
本文介绍了两种使用Python爬取图书网站数据的方法。第一种方法通过自动检测"下一页"按钮实现翻页,使用requests发送请求、BeautifulSoup解析HTML,提取图书标题、价格、评分等信息,并支持设置最大爬取页数限制。第二种方法先获取总页数再进行循环爬取,同样使用requests和BeautifulSoup,包含异常处理和随机延迟。两种方法都将结果保存为CSV文件。
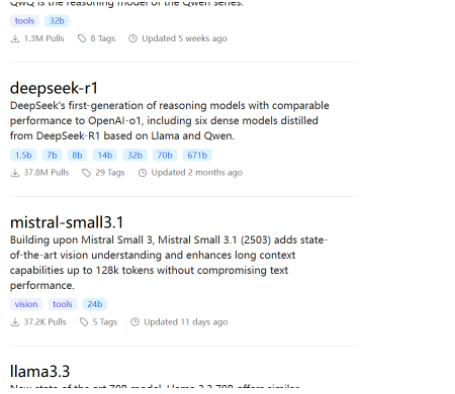
本文介绍了大模型注册与私有化部署流程。首先需要在DeepSeek或OpenAI官网注册获取API Key,建议小额充值。其次讲解了使用Ollama开源软件进行本地化部署的方法,包括下载安装Ollama和DeepSeek-R1模型,并提供了运行模型的基本命令(如ollama run启动模型、ollama list查看模型、/bye退出等)。部署过程需注意硬件配置对运行速度的影响。Ollama可视为类
本文介绍了如何使用FastAPI框架搭建Python Web服务。首先说明需要Python3.6+环境并通过清华源安装FastAPI。然后展示了一个基础应用示例,包含根路径、带路径参数和查询参数的GET请求处理。接着介绍了数据模型验证功能,使用Pydantic的BaseModel定义数据格式,并演示了POST和PUT请求的处理方法。文中还提供了运行方式(uvicorn启动服务)以及代码解析,包括异
再程序里调用 ,比如上传文章图片场景 ,上传好后把$result['oss-request-url']oss的访问路径,保存到数据库中。'KeySecret'=> 'KaqD1uAxxxxxxxxxxxxx',//您的Access Key Secret。'KeyId'=> 'LTAI5tAhDgMxxxxxxx',//您的Access Key ID。要使用阿里云 osssdk,请先到阿里云下载 或
php5.6 线程安全xdebug。
