- @m0_73542617


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
这里只是简单的使用ultralytics进行训练,这个比赛是好几年前的,我当时还没开始做kaggle,所以没参与,这里只是为了熟悉目标检测,后面我再去看看mmdetection。
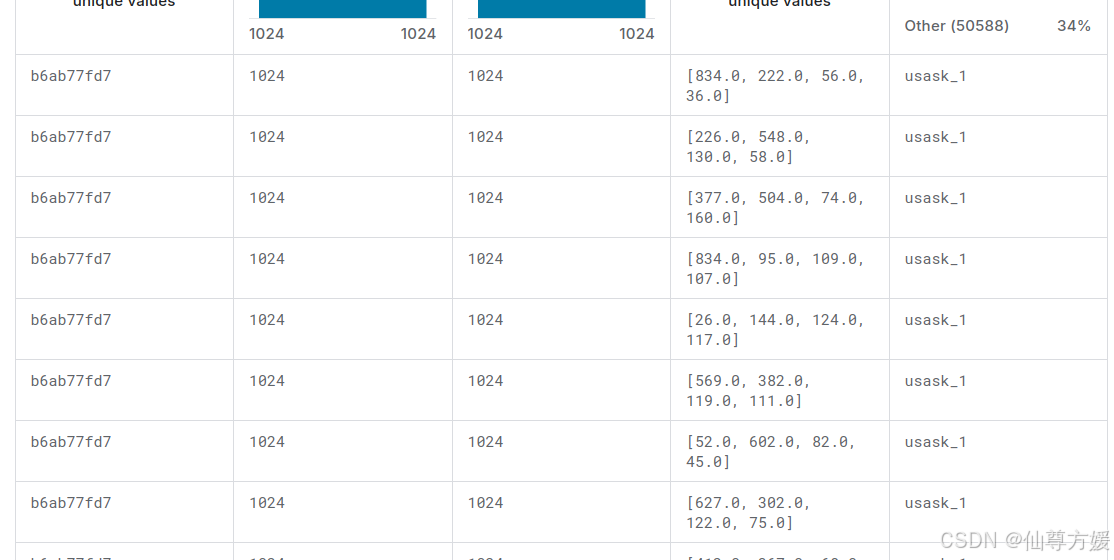
json.dumps编码前的图像标注信息是包含多个字典的list,字典中的 points 表示文本框的四个点的坐标(x, y),从左上角的点开始顺时针排列。在模型训练过程中保存的模型文件是包含前向预测和反向传播的过程,在实际的工业部署则不需要反向传播,因此需要将模型进行导成部署需要的模型格式。ZH(中文)、JA(日语)、ES(西班牙)、FR(法语)、IT(意大利)、DE(德语)、PT(葡萄牙),用

下面这是官方的# 执行编译,得到可执行文件ocr_db_crnn# ocr_db_crnn可执行文件的使用方式为:# ./ocr_db_crnn 检测模型文件 识别模型文件 测试图像路径make -j# 将编译的可执行文件移动到debug文件夹中# 将debug文件夹push到手机上adb shell实际上你还得弄一下下面一步,照下面这个链接做第七步Ubuntu20.04 交叉编译Paddle-O

最后一行是源,可以提高下载速度,第二行的需要自己去github官网下载他最新的包,链接如下。

这个只需注册一个kaggle账号,但这个比赛已经结束了,无法提交成绩。
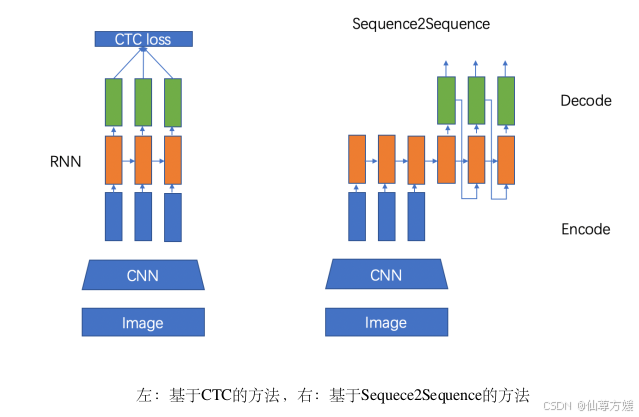
文本识别任务接在检测任务之后,分为规则文本和不规则文本,规则文本主流包括下面的CTC和seq2seq,不规则文本主流分,基于校正的方法;基于 Attention 的方法;基于分割的方法;基于 Transformer 的方法,我也不知道为什么书上处理一个不规则文本数据用的规则文本的模型。