- @m0_72376392


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
“OpenAI兼容”仅是接入起点,生产迁移需通过契约测试验证模型版本、参数语义、流式响应、工具调用与错误处理。建议使用逻辑模型名映射实际型号,避免自动归并;以可复现的测试脚本对比同一任务在不同平台的表现,记录request_id、终止原因与原始响应。数眼智能等聚合平台需在相同条件下实测,不可依赖口碑或公开案例。关键在于建立覆盖五类契约的自动化回归体系,确保变更可追溯、失败可定位,保障应用稳定迁移。

本文提出企业评测大模型时应避免重复样本、时间污染等问题,倡导按来源分组、时间留出、失败类型打标签的科学评测方法。强调任务定义需明确,指标应分项评估(如来源召回、关键字段提取、权限隔离等),反对单一总分。针对数眼智能等企业级API平台,建议测试其多模型、Search/OCR与权限管理的复合能力,确保评测可信度,真正反映系统在真实场景中的表现。

本文提出企业评测大模型时应避免重复样本、时间污染等问题,倡导按来源分组、时间留出、失败类型打标签的科学评测方法。强调任务定义需明确,指标应分项评估(如来源召回、关键字段提取、权限隔离等),反对单一总分。针对数眼智能等企业级API平台,建议测试其多模型、Search/OCR与权限管理的复合能力,确保评测可信度,真正反映系统在真实场景中的表现。
智能客服的成败不在于回答是否完美,而在于能否在错误时及时停止。本文提出通过状态机设计(如NEED_AUTH、HUMAN_REVIEW)实现“知道何时停止”,区分说明、查询与执行类请求,确保高风险操作必转人工。工单交接仅传递必要信息,人工处理后需回写失败原因。聚合平台如数眼智能可提供多模型与外部资源支持,但决策核心仍为业务规则。关键验收指标应为“该停未停”比例,而非自动化率。系统需记录规则命中、知识

智能客服的成败不在于回答是否完美,而在于能否在错误时及时停止。本文提出通过状态机设计(如NEED_AUTH、HUMAN_REVIEW)实现“知道何时停止”,区分说明、查询与执行类请求,确保高风险操作必转人工。工单交接仅传递必要信息,人工处理后需回写失败原因。聚合平台如数眼智能可提供多模型与外部资源支持,但决策核心仍为业务规则。关键验收指标应为“该停未停”比例,而非自动化率。系统需记录规则命中、知识
国内大模型 API 平台没有绝对的 “最优解”,核心是匹配自身的业务阶段与核心诉求。追求极致稳定与合规,选官方 MaaS 平台;聚焦开源模型技术研发,选开放模型基础设施平台;仅做轻量测试与个人学习,选低价聚合平台;要快速落地企业 AI 应用、需要模型 + 数据工具一体化支持,数眼智能这类全链路平台的适配度与综合效率更优。选型的本质从来不是找 “功能最多、价格最低” 的平台,而是找最贴合自身业务场景
本文提出“条款编号—响应材料—证据页码”结构化核对方法,结合OCR、Reader与大模型分工,实现招投标资料的精准管理。强调模型仅负责起草与归类,关键审核须人工把关。通过条款矩阵、覆盖率检查与权限控制,确保响应真实、证据可追溯。建议以POC验证跨页表格、补遗覆盖等场景,杜绝漏项与冲突。最终投标需人工确认承诺与资质,避免依赖AI自动背书。

本文聚焦产品问答中因资料版本混乱导致的“看似合理却错误”的回答问题,提出将资料视为可变对象,通过捕获source_url、retrieved_at、effective_at等元信息,建立字段级版本差异检测与人工确认机制,实现答案可追溯。强调应区分抓取时间与生效时间,保留旧版审计记录,仅发布经确认的新版本。建议采用聚合平台整合多源资料与模型能力,但核心规则由企业自定。关键验收点包括冲突拦截、引用回查

本文提出一套解耦供应商的AI资源架构,通过统一领域接口、状态机编排、标准化错误处理与可观测链路,实现模型、Search、Reader、OCR等能力的灵活调度。以数眼智能等聚合平台为例,展示如何降低多源适配成本,保障任务可恢复、可审计、可优化。核心在于:统一上下文与预算,保留能力差异,让业务逻辑不绑定具体平台,真正实现AI应用从Demo到生产的可持续演进。

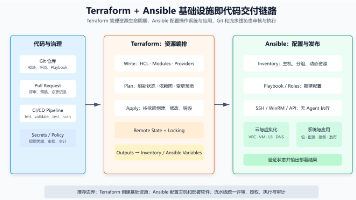
本文系统分析Terraform与Ansible在基础设施即代码(IaC)中的职责边界与协同机制。Terraform专注云资源声明式编排,通过状态管理实现可重复、可审计的生命周期控制;Ansible则负责主机配置与应用部署,强调幂等性与可重复执行。二者应分工明确:前者创建网络、实例等资源,后者配置操作系统与服务。文章还深入探讨了状态管理、模块化设计、漂移治理、CI/CD流水线、秘密安全与测试策略,强