


- @m0_65481401


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
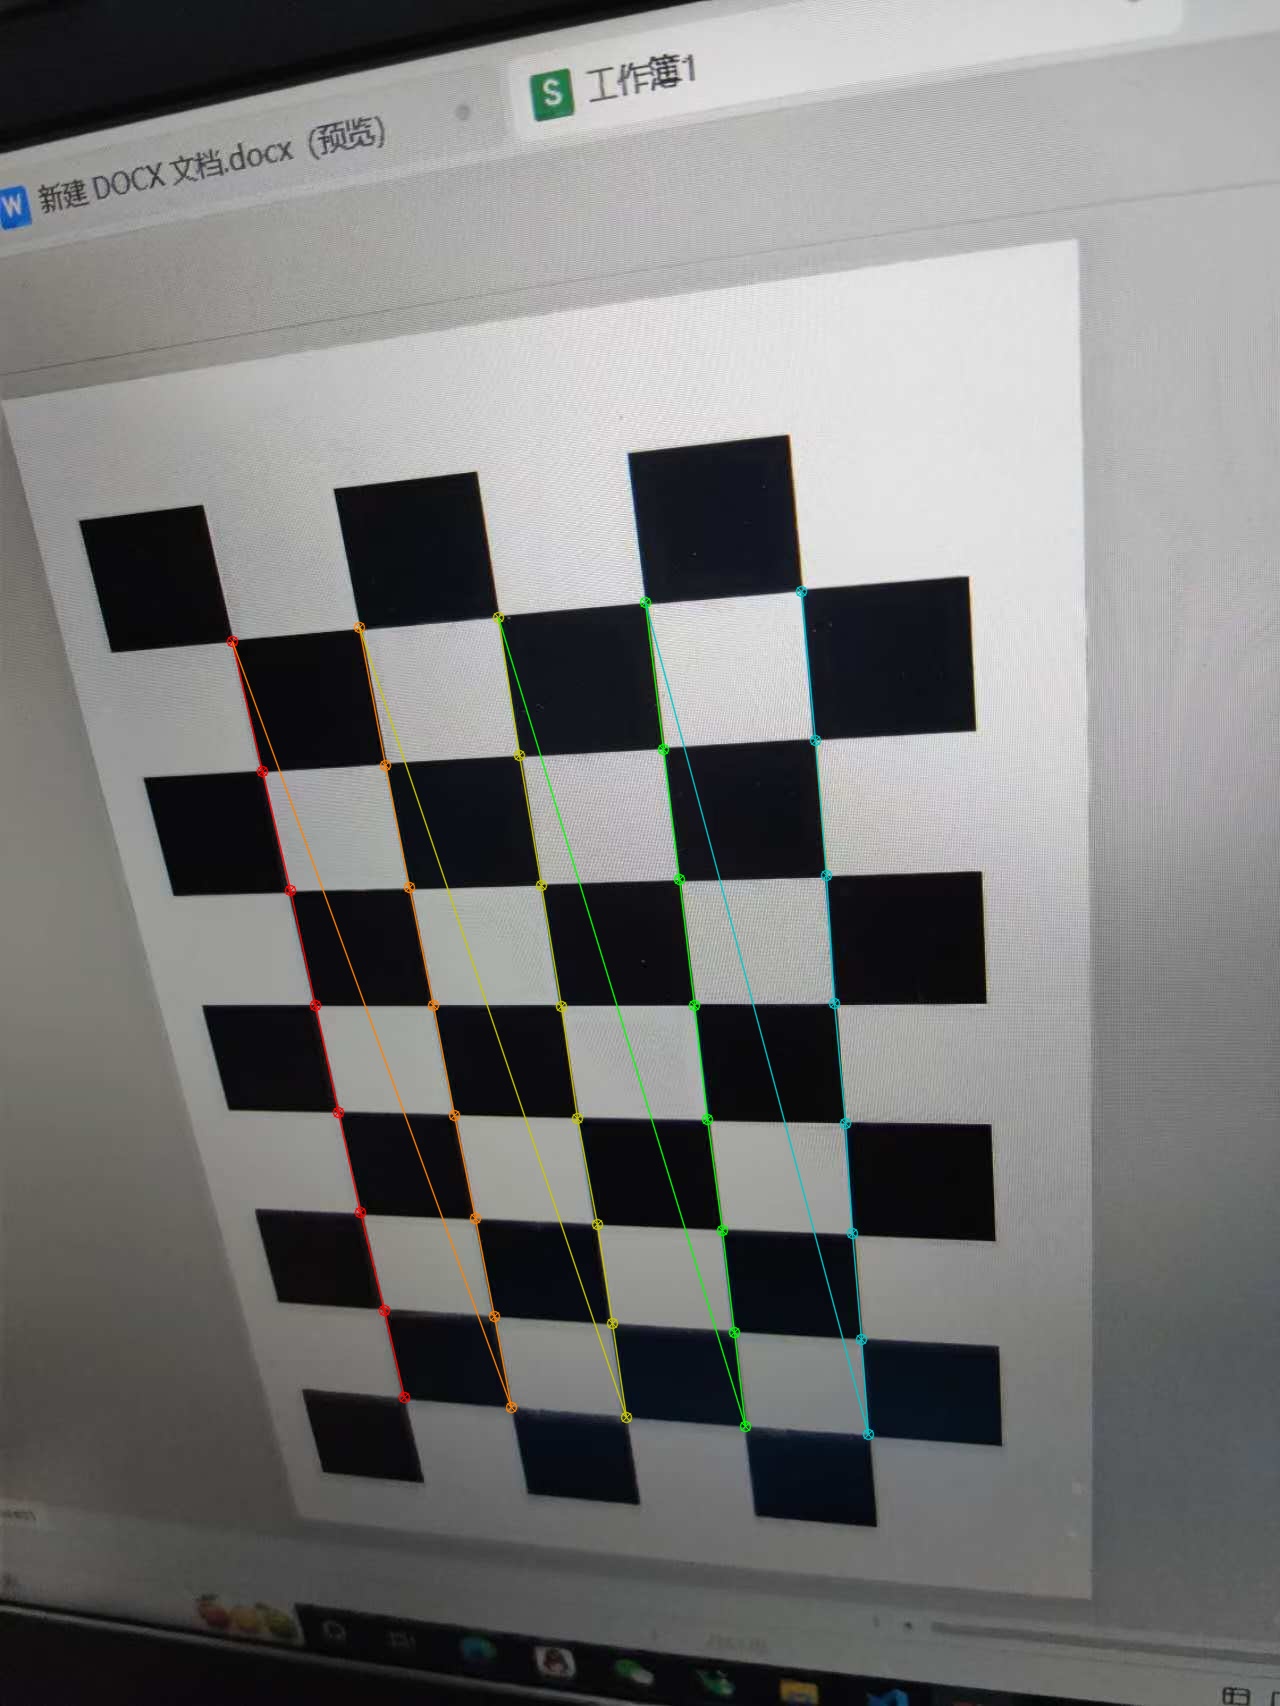
通过使用张正友标定法对摄像机进行标定,确定摄像机的内参数和外参数了解相机的几何模型,从而实现对三维场景的准确重建和测量。
在机器学习领域,Logistic回归(LogisticRegression)是一个非常重要且经典的算法。尽管它的名字中有“回归”二字,但它实际上是一个分类算法,常用于二分类问题。Logistic回归的简洁性和高效性使其在许多实际问题中都能够提供优良的性能。本篇文章将深入探讨Logistic回归的原理、应用,结合具体的代码演示,并讨论一些与之相关的优秀论文。
办公Agent意图识别的核心痛点在于处理用户表达的模糊性、多轮省略和复合任务需求。系统需结合上下文、状态管理和风险控制,采用分层意图体系(如邮件、日程等一级分类)和槽位抽取技术。解决方案包括:1)上下文感知识别;2)Session状态维护;3)主动澄清缺失信息;4)高风险操作二次确认;5)规则+小模型+LLM混合架构。典型场景如"发请假邮件"需识别初始意图后,逐步补全时间、收件
摘要: 本文探讨了大模型面试中关于实时性和多轮对话一致性的优化策略。实时性方面,建议采用流式输出、模型分层部署、Prompt精简、缓存优化及RAG检索加速,并设置超时降级策略。多轮一致性则需维护会话状态(如意图、关键实体、历史摘要),结合QueryRewrite避免信息丢失,并防止上下文污染。两者需平衡处理,简单问题走轻量链路,复杂问题启用RAG和校验。案例演示了企业知识库场景下如何动态管理会话状
Prompt Engineering 在企业大模型应用中的实践 摘要 本文探讨了Prompt Engineering在企业级大模型应用中的关键作用和实施方法。文章指出,企业级Prompt Engineering远非简单的"写提示词",而是需要建立一套完整的工程体系,包括: 结构化设计:将提示词从口语化指令升级为包含角色定义、任务规范、输出格式等要素的结构化协议 可控输出:通过JSON Schema

本文深入解析Transformer架构中的Encoder和Decoder模块,揭示其在大模型应用中的关键作用。文章从工程实践角度出发,对比了Encoder-only、Decoder-only和Encoder-Decoder三种架构的特点及适用场景:Encoder擅长文本理解(如BERT用于分类/检索),Decoder擅长生成任务(如GPT用于对话/代码生成),而Encoder-Decoder适合翻
KV Cache 缓存机制:大模型推理优化的核心技术 KV Cache 是 Transformer 模型推理中的关键优化技术,通过缓存历史 token 的 Key 和 Value 来避免重复计算,显著提升生成效率。文章深入剖析了 KV Cache 的工作原理及其在大模型服务中的应用挑战: 核心原理:在自回归生成过程中缓存历史 token 的 K/V 表示,后续生成只需计算当前 token 的 Q/

办公Agent意图识别的核心痛点在于处理用户表达的模糊性、多轮省略和复合任务需求。系统需结合上下文、状态管理和风险控制,采用分层意图体系(如邮件、日程等一级分类)和槽位抽取技术。解决方案包括:1)上下文感知识别;2)Session状态维护;3)主动澄清缺失信息;4)高风险操作二次确认;5)规则+小模型+LLM混合架构。典型场景如"发请假邮件"需识别初始意图后,逐步补全时间、收件
摘要: 本文探讨了大模型面试中关于实时性和多轮对话一致性的优化策略。实时性方面,建议采用流式输出、模型分层部署、Prompt精简、缓存优化及RAG检索加速,并设置超时降级策略。多轮一致性则需维护会话状态(如意图、关键实体、历史摘要),结合QueryRewrite避免信息丢失,并防止上下文污染。两者需平衡处理,简单问题走轻量链路,复杂问题启用RAG和校验。案例演示了企业知识库场景下如何动态管理会话状
KV Cache 缓存机制:大模型推理优化的核心技术 KV Cache 是 Transformer 模型推理中的关键优化技术,通过缓存历史 token 的 Key 和 Value 来避免重复计算,显著提升生成效率。文章深入剖析了 KV Cache 的工作原理及其在大模型服务中的应用挑战: 核心原理:在自回归生成过程中缓存历史 token 的 K/V 表示,后续生成只需计算当前 token 的 Q/