


- @m0_56487684


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本文主要对近七年U型网络改进工作,Transformer与U型网络的结合,在Synapse和ACDC数据集上进行对比实验,最后证明transformer在图像分割上更有优势。创建新变体过程如旋转,剪切,擦除,噪点引入,遮挡,弹性变形,缩放等。黄高博士在DenseNet[26]中提出,在神经网络 中,先前层与后续层相连接共同作为下一层的输入,通过最大 化信息流以消除梯度消失,并加强特征传播、鼓励特征

解决word格式编辑一处,其余内容格式都跟着一起变化的问题_word调一行其他都跟着变-CSDN博客

选上这两个就好。
1.搜索word,然后右击word,选择文件所在位置。这里的wordicon.exe文件就是对应的一系列word图标。找到目标图标的位置:(这个找寻方式放文末)打开下载后的软件后,点击这个。打开网页后划到最下面下载。2. 右键,点击属性。
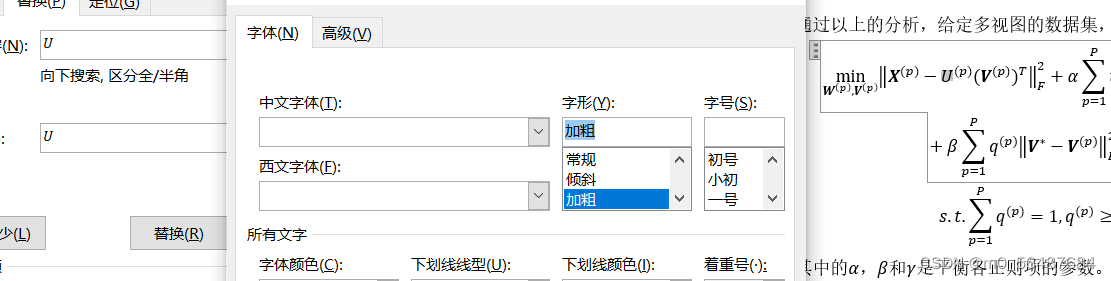
值得注意的是,可能点击替换后,word中字母好像没变化,但别担心,其实是已经替换了的。可以关闭word,然后重新打开,来检验下是不是成功替换。
2.右键选择修改,再点击左下角的格式,选择段落,然后选择 换行和分页。最后取消掉与下段分页,和段中不分页。最后点击确定来关闭所有对话框。1.光标定位到该级标题,然后找到上面对应标题,
检索增强生成是一种结合外部知识检索生大语言模型(LLM)生成能力的技术框架,主要用于解决大模型在处理需要实时或特定领域知识时的”幻觉”问题(如事实性错误、知识过时Retrieval-Augmented Generation (RAG,等)。3.文档分段:将长文档切分为合适长度的片段(如200-500字),避免信息过载,同时保留上下文完整性。1.查询解析:对用户输入进行预处理(分词,去除停顿用词,语
预训练:通过海量的输入得到输出,然后计算loss值,不断调整参数的过程。微调:(监督微调SFT)投入特定的文本进行训练。用小矩阵乘法,去适配大矩阵参数的一个过程。
如果找不到过去的训练资料的话,可以让给模型一些问题以及部分答案,然后让模型回答答案并顺着继续追问,这样不断生成新的问题和答案,从而得到训练资料。post-training 最大的挑战是,模型会可能忘了旧的技能或能力.微调的时候最好混5%的前一阶段的资料,防止模型遗忘已经学到的知识技能。原因,后训练的时候,更加关注到了我们想要的技能,而忽略了其他技能。学得多一些,忘得可能多一些,学的少一些,忘的往往
但其实后面发现推理过短也不好,所以认为设定,如果超过某个长度,直接让他不说了,如果过短就强制把end替换为wait,然后继续输出。对推理结果进行打分,把得出正确结果的收集起来,然后对推理长度做平均,超过平均长度的认为是不好的,短于平均长度的认为是好的。可以训练的时候用老师学生模型,选择推理最短,且回答正确的作为学生模型的训练资料,来学习最短的推理过程。所以有时候训练的时候可以让中间是错误的,知道是