


- @fengquan8866


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
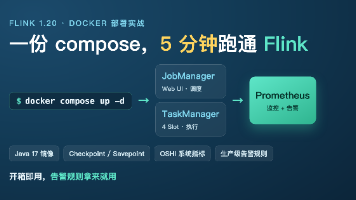
基于 Docker 单机部署 Flink 1.20.1(Java 17 镜像),一份 docker-compose 搞定 JobManager + TaskManager,含 checkpoint/savepoint 挂载与 OSHI 系统指标;再集成 Prometheus 采集 + 任务停止/频繁重启/Checkpoint 失败/反压/TM 内存 GC/Slot 不足等生产级告警规则;最后用 G
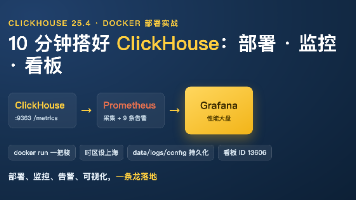
基于 Docker 部署 ClickHouse 25.4 单机实战:用临时容器拷出 config.xml 再改,重点配置 default_time_zone 为上海避免查询差 8 小时、开 Prometheus 指标端点、挂载 data/logs/config 三目录持久化并加 ulimit。含 Prometheus 采集与告警规则、Grafana 装 ClickHouse 数据源导入看板,10
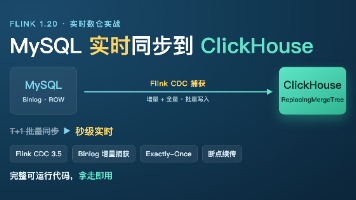
基于 Flink 1.20 + Flink CDC 3.5,监听 MySQL Binlog 实现到 ClickHouse 的实时同步,取代 T+1 批量同步。文中给出 Binlog 开启与最小权限账号配置、Maven 依赖、Flink SQL 建源表与 JDBC 批量写入代码,用 ReplacingMergeTree 按 _version 去重保幂等、Checkpoint 保证 Exactly-O
本文介绍了一种轻量级离线数仓搭建方案,采用ClickHouse+DolphinScheduler组合替代传统的Hadoop全家桶。该方案适用于日增数据量千万级以下的中小团队,具有部署简单(仅需2个组件)、运维成本低等优势。文章详细演示了从数仓分层设计(ODS/DWD/DWS/DIM/ADS)、利用ClickHouse原生MySQL引擎实现数据同步,到通过DolphinScheduler配置增量调度
摘要: 本文介绍基于 Flink CDC 3.5 和 Flink 1.20 实现 MongoDB 到 ClickHouse 的实时数据同步方案。传统定时脚本和消息队列中转方式存在延迟高、业务侵入性强等问题,而 Flink CDC 通过监听 MongoDB 的 Change Stream 实现增量捕获、断点续传和 Exactly-Once 语义。文章详细演示了环境搭建(包括 MongoDB 副本集配
本文介绍了一套高效通用的MongoDB到ClickHouse实时同步方案,通过配置驱动方式实现多集合自动同步。针对MongoDB特有的驼峰命名、嵌套对象、脏数据等问题,设计了15种智能映射策略,包括字段重命名、类型转换、数据清洗等功能。方案采用单一Flink作业处理多个集合,通过配置文件定义映射规则,避免代码重复修改。核心优势在于配置灵活性(新增集合仅需修改配置文件)、数据处理能力(自动转换Ext
摘要: 一个ClickHouse查询任务因内存不足报错,仅需更新2500个用户数据,却扫描了5600万行数据。排查发现,LEFT JOIN操作导致右侧表全量加载到内存,包括千万级的用户扩展信息、设备信息等表。虽然重启ClickHouse后查询能暂时成功,但本质是查询设计问题——为少量更新而全表扫描。优化方案包括在子查询中添加用户ID过滤条件,减少数据扫描量。问题根源在于"用大炮打蚊子&q
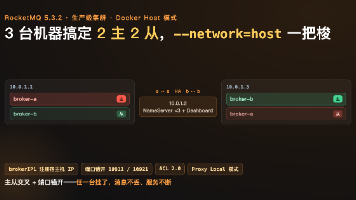
RocketMQ 5.3.2 生产级集群部署实战:用 3 台机器搭 2 主 2 从 + 3 NameServer + Dashboard + Proxy,采用 Docker Host 网络模式让 Broker 注册宿主机 IP,避开 Bridge 模式客户端连不上的坑。主从交叉部署保证单机故障不丢消息,附完整 broker 配置、启停顺序、ACL 2.0 权限、手动建 Topic 与常见问题排查。
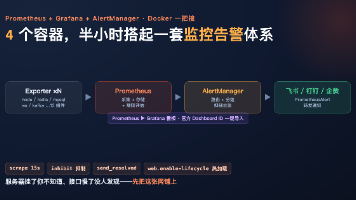
基于 Docker 一把梭搭建 Prometheus + Grafana + AlertManager + PrometheusAlert 完整监控告警体系,覆盖主机、Redis、MySQL、ES、Kafka 等十余种组件的指标采集与可视化,打通告警路由、抑制去重到飞书、钉钉、企微通知,附全部 docker run 命令与 Grafana 看板 ID,四个容器半小时落地。
摘要: ClickHouse内存持续增长5天,常规排查发现MemoryTracking占18.4GiB但具体内存去向不明。system.trace_log等系统日志表体积异常(24.67GiB压缩数据),且业务表parts碎片严重(部分超500个)。通过TRUNCATE系统日志表、配置TTL和OPTIMIZE高碎片表缓解问题,但根因仍未明确。最矛盾的是ClickHouse报告占用20G+内存,而操