- @dege857


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
CLHLS是中国老年健康影响因素跟踪调查数据,由北京大学主持,覆盖1998-2018年全国23个省市,包含11.3万人次调查数据,重点关注高龄老人健康。数据可用于计算虚弱指数(由40个变量组成),支持纵向分析和轨迹分析。通过R语言的clhls.frailtyindex函数可快速提取虚弱指数,并支持多年度数据分析和全变量导出。该数据与CHARLS数据库有相通性,适合双库交叉验证研究。研究团队还开发了

北京大学"中国老年健康调查"(CLHLS)是一项覆盖全国23省市的长期追踪研究,1998-2018年间完成8次入户调查,累计访问11.3万人次,重点关注高龄老人健康。研究发现饮食模式对老年健康有重要影响,植物性饮食(如地中海饮食)对糖尿病、心血管疾病等具有保护作用。研究者开发了专用R包sciclhls,包含CLHLS.hPDI和CLHLS.UPDI函数,可从CLHLS数据库便捷
摘要:列线图(诺莫图)是一种基于多变量回归分析的预测工具,通过直观的图形化评分系统预测临床结局或疾病风险。近年来在高质量临床研究中广泛应用,尤其在SEER数据库分析中。本文以一篇16分SCI论文为例,展示了如何使用列线图建立风险预测模型(包括变量筛选、模型构建和可视化),并通过最佳阈值划分低、中、高风险组,最终用KM曲线验证分层效果。分析使用R语言实现,涵盖逐步回归、风险分数计算、截点优化和生存分

北京大学主持的"中国老年健康调查(CLHLS)"是一项覆盖全国23个省市的长期追踪研究,1998-2018年间完成8次调查,累计入户访问11.3万人次,其中80岁以上高龄老人占67.4%。研究收集了老人健康、认知、社会参与及照料需求等丰富数据,并包含2.89万死亡老人临终前状况。调查数据已通过开放平台免费共享,被1万多位学者使用,产出大量学术成果。该数据集以sav格式存储,包含
我们通过TwoSampleMR包把它下载,先使用extract_instruments函数对暴露数据(就是体重BMI的SNP数据)ieu-a-835进行下载,如果是已经下载到电脑里面的数据,我们使用read_exposure_data函数和clump_data函数读取。这三步走完就可以进行MR分析了,代码非常简单。孟德尔随机化(Mendelian randomization,简称MR)是一种基于遗

数据解释如下:low 是否是小于2500g早产低体重儿,age 母亲的年龄,lwt 末次月经体重,race 种族,smoke 孕期抽烟,ptl 早产史(计数),ht 有高血压病史,ui 子宫过敏,ftv 早孕时看医生的次数,bwt 新生儿体重数值。假设咱们想race为研究目标,因为它是分类变量,咱们最好把它转成因子,因为scitb包有一定对数据类型的判定能力,如果你的分类变量类别大于5个,而你不转

上一期我们已经介绍了如何使用注册SEER数据库的账号和密码,今天我们来介绍一下怎么把数据提出来。首先我们需要打开官网网页:https://seer.cancer.gov/选择seer data&software选择SEER.stat然后从左到右依次点击红色箭头处这时会跳转到另外的页面,下载软件也要提交一个申请,点击同意后把列表上内容填好发送申请就可以了,seer官网就会把软件下载的地址发送
我们做临床研究常见的烦恼为没有好的数据,目前气象网站上有很多关于气象因素和空气质量数据,但是没有系统的整理和格式等问题,我们使用起来非常不方便,而且很费时间,我们可以使用R语言爬虫工具对网站上的数据进行抓取,然后对数据进行整合,最后进行分析,达到事半功倍的效果,先申明一下,爬取工具不是病毒,原理我就不废话这么多了,主要是对实际操作进行讲解。今天我们要爬取的网站是PM2.5网,为什么选这个网站,因为
本研究基于中国健康与退休追踪调查(CHARLS)数据,采用机器学习方法构建帕金森病诊断模型。研究通过比较不同变量数量下随机森林模型的预测性能,发现10个变量时模型表现最优(AUC=0.85)。方法学上,研究采用训练集(70%)和测试集(30%)划分,评估了包括敏感性、特异性在内的13项指标。研究创新性地展示了变量数量与模型性能的关系,为社区帕金森病筛查提供了高效的特征选择方案。复现结果表明,该方法
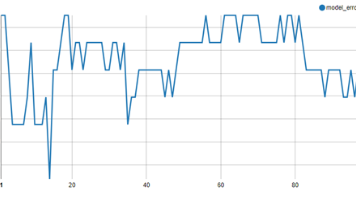
本文介绍了使用R语言实现AdaBoost算法的过程。首先导入数据和相关R包,对数据进行预处理和变量筛选。将数据分为70%训练集和30%测试集后,构建AdaBoost模型并设置100次迭代。通过预测结果分析混淆矩阵和错误率,并可视化变量重要性。结果显示,增加迭代次数并不能持续降低错误率,在17次时达到最低。最后展望将开发适配函数用于ROC曲线等分析。该案例展示了AdaBoost算法作为集成学习方法的