


- @bqw18744018044


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
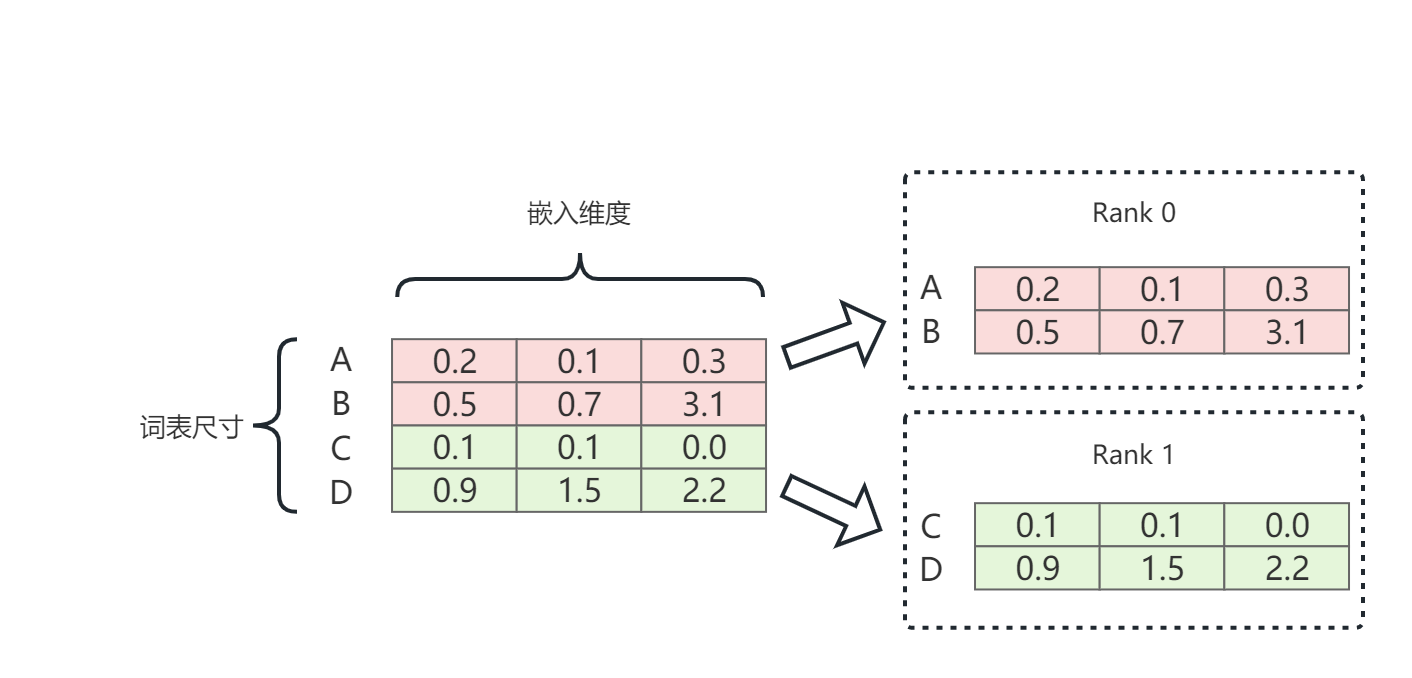
张量并行版Embedding层及交叉熵的实现及测试Megatron-DeepSpeed是DeepSpeed版本的NVIDIA Megatron-LM。像BLOOM、GLM-130B等主流大模型都是基于Megatron-DeepSpeed开发的。这里以BLOOM版本的为例,介绍其模型并行代码mpu的细节(位于megatron/mpu下)。。
from pandas import Seriesimport pandas as pdimport numpy as np一.介绍Series由一组数据和一组索引组成o = Series([1,2,3,4])print(o)print(o.values) # 数据print(o.index) # 索引01122334d...
一、基本概念 二、穷举算法的时间复杂度 三、分析子问题 四、递推方程和标记函数 五、算法LCS1. 伪代码算法:LCS(X,Y,m,n)输入:序列X及其长度m,序列Y及其长度n输出:最长公共子序列的长度for iß0 to m do C[i,0]ß0for jß0 to n d...
一、word2vec在自然语言处理中,词向量是一种常见的词分布式表示。词表中的每个单词均由一个维度固定的连续向量表示。word2vec是2013年Google公布的训练词向量的工具,其包含了两个模型,分别是:CBOW和SkipGram。这里仅简单介绍SkipGram模型,更加详细的原理介绍见文章【自然语言处理】【Word2Vec(二)】超详细的原理推导(包含负采样和层次softmax)。1. Sk
import numpy as np一、ufunc函数简介ufunc函数是一种对数组中每个元素进行运算的函数,作用于数组上的速度通常会被Python内置的函数快很多。例如:作用于数组时np.sin()要比math.sin()快很多倍。二.求和不同轴求和x = np.array([[1,2,],[3,4]])print(x.sum()) # 所有元素求和pri...
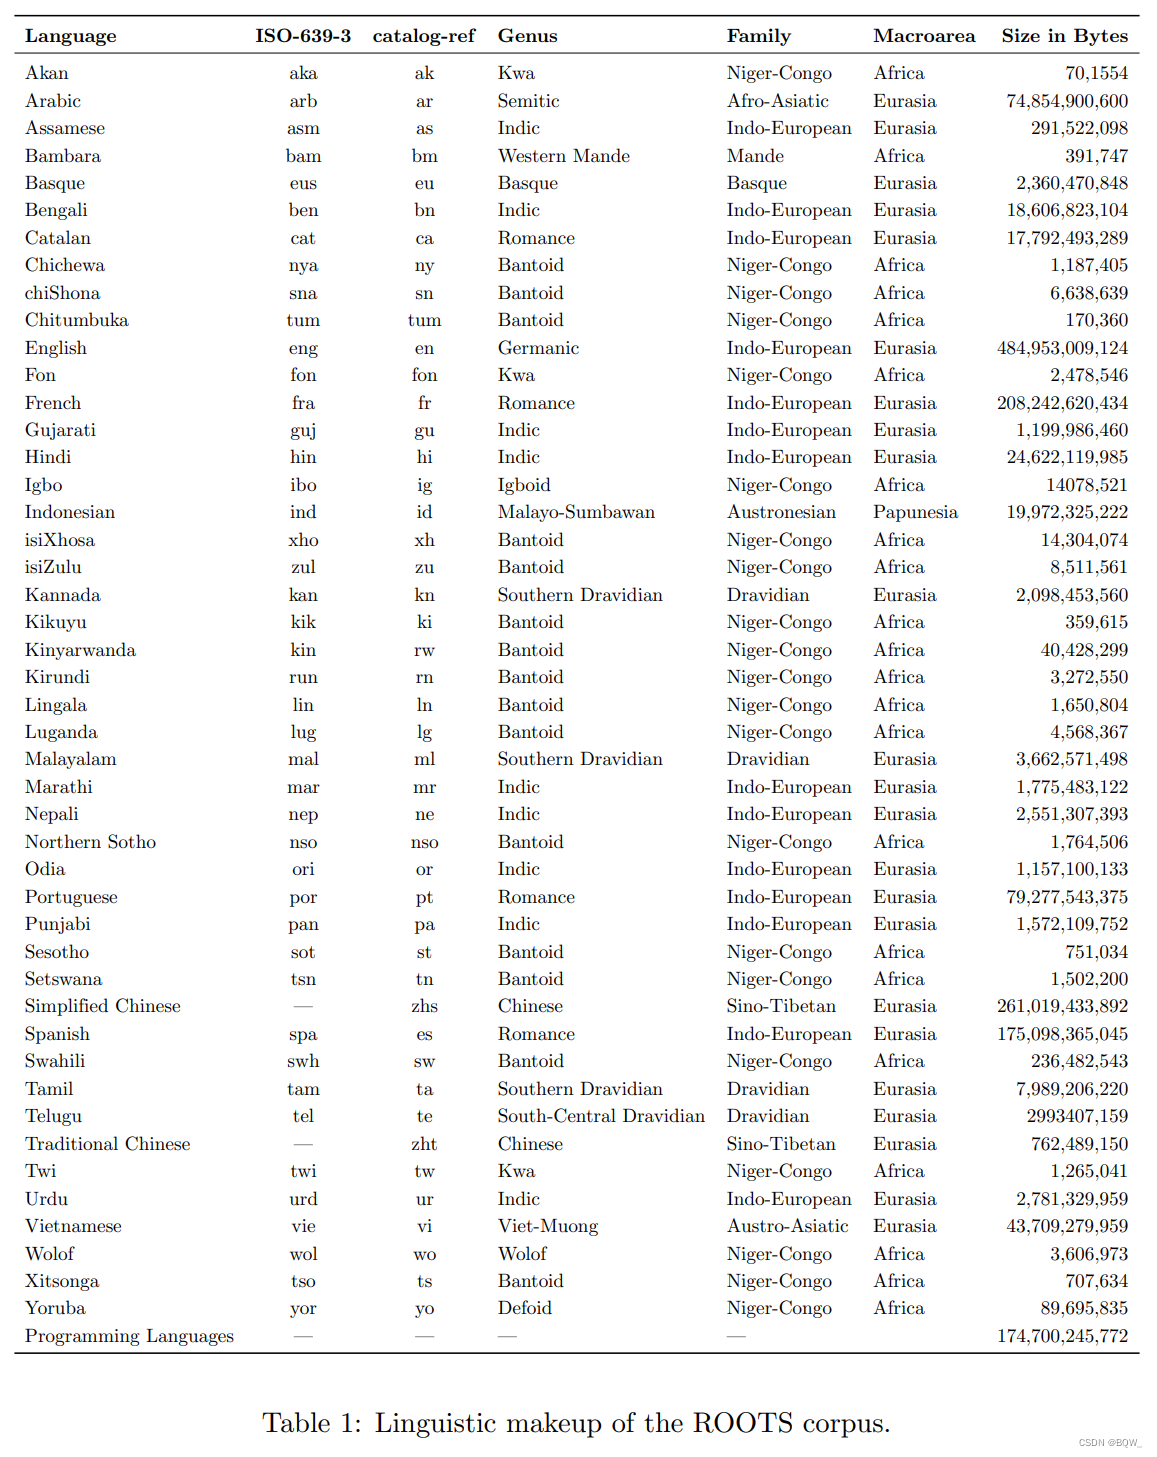
预训练语言模型已经成为了现代自然语言处理pipeline中的基石,因为其在少量的标注数据上产生更好的结果。随着ELMo、ULMFiT、GPT和BERT的开发,使用预训练模型在下游任务上微调的范式被广泛使用。随后发现预训练语言模型在没有任何额外训练的情况下任务能执行有用的任务,进一步证明了其实用性。此外,根据经验观察,语言模型的性能随着模型的增大而增加(有时是可预测的,有时是突然的),这也导致了模
本文是一个基于Transformers的文本生成代码示例。该示例中使用中文版本的BART模型,数据则使用NLPCC2017的中文摘要数据集。
基于对比簇分配的无监督视觉特征学习《Unsupervised Learning of Visual Features by Contrasting Cluster Assignments》论文地址:https://arxiv.org/pdf/2006.09882.pdf一、简介无监督(或者自监督)视觉表示的目标是,在不使用人工标注的情况下或者图像的特征。目前,无监督方法在计算机视觉任务中快速的接
知识图谱表示学习(五)PairRE:基于成对关系向量的知识图谱嵌入原始论文:https://arxiv.org/pdf/2011.03798.pdf一、简介基于距离的知识图谱嵌入方法在链接预测任务上效果显著。在链接预测任务中,存在两个被广泛研究的主题:(1) 处理复杂关系的能力,例如:N-to-1\text{N-to-1}N-to-1、1-to-N\text{1-to-N}1-to-N和N-to