


- @Zcymatics


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
传统数值算法求解浅水方程时,依赖复杂的网格离散化,计算成本高,且无法预测任意时间点的解。数据驱动的机器学习方法虽在多领域取得进展,但在复杂领域尤其是数据稀缺场景下应用受限。且传统机器学习算法未充分利用先验知识,导致算法泛化能力较低。因此本文提出一种改进的PINN算法求解浅水方程,算法基于PINN和LSTM模型,在损失函数中引入L1正则化项作为惩罚,并在LSTM网络结构中加入注意力机制。通过一维浅水
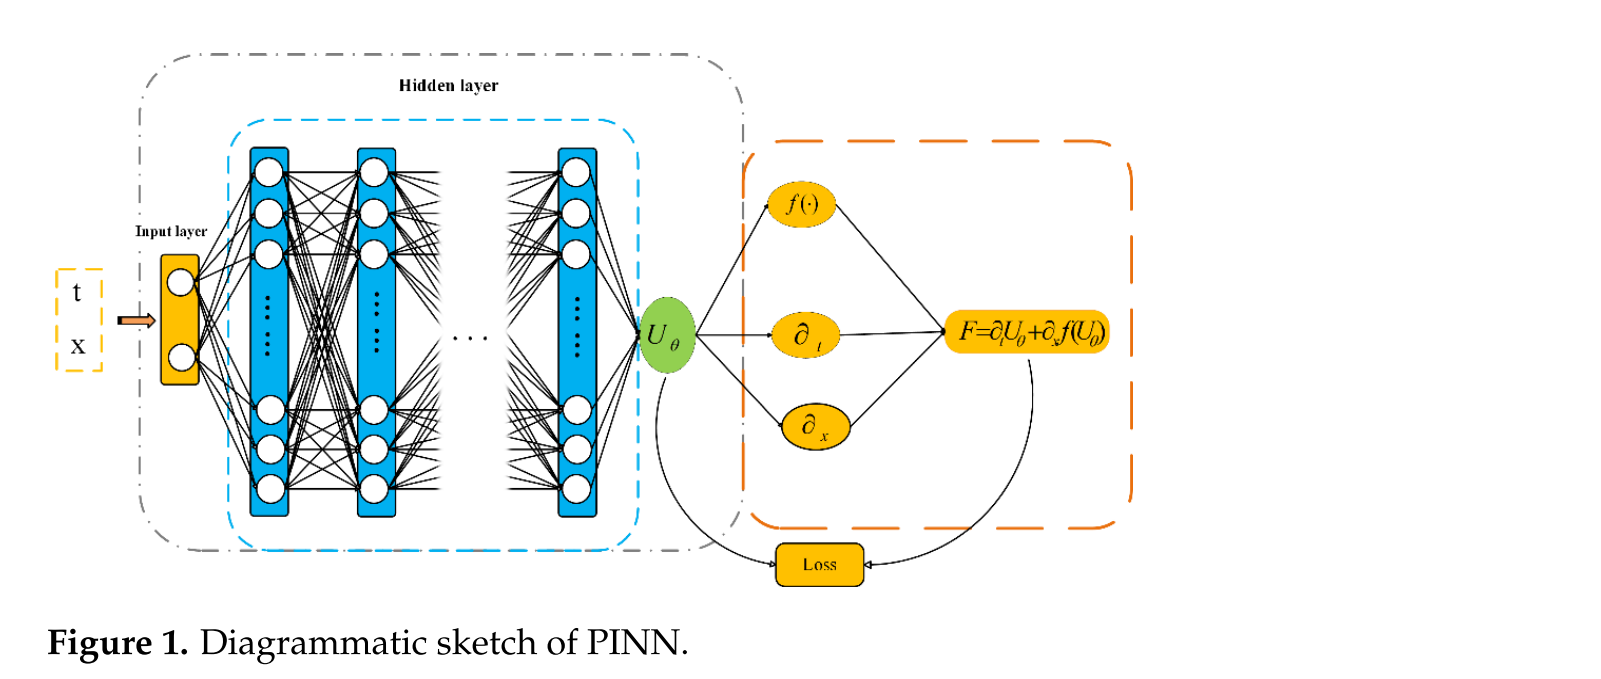
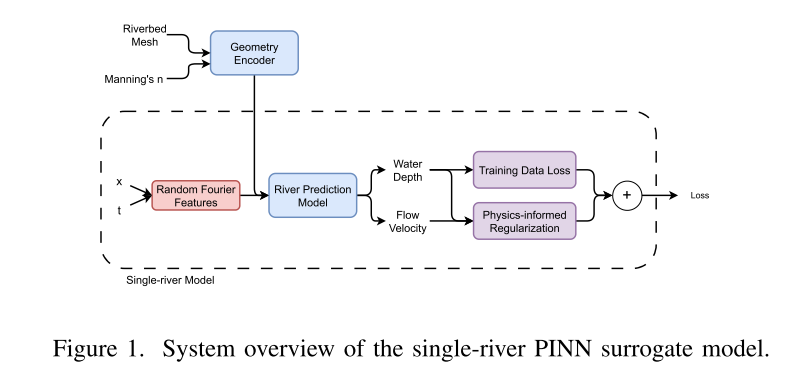
河流水位动态对农业、工业和城市基础设施至关重要,准确预测有助于灌溉、供水、排水规划和洪水风险评估等领域的决策制定,尤其在极端天气事件中,实时预测对洪水预报和应急响应至关重要。但传统水动力模型,如HEC - RAS虽能通过求解圣维南方程提供高精度的河流水位模拟,但计算成本高,需要大量参数校准和精细的时空数据,导致实时预报在快速演变的洪水场景中效果不尽人意。而纯数据驱动的深度学习模型,如DNN、RNN
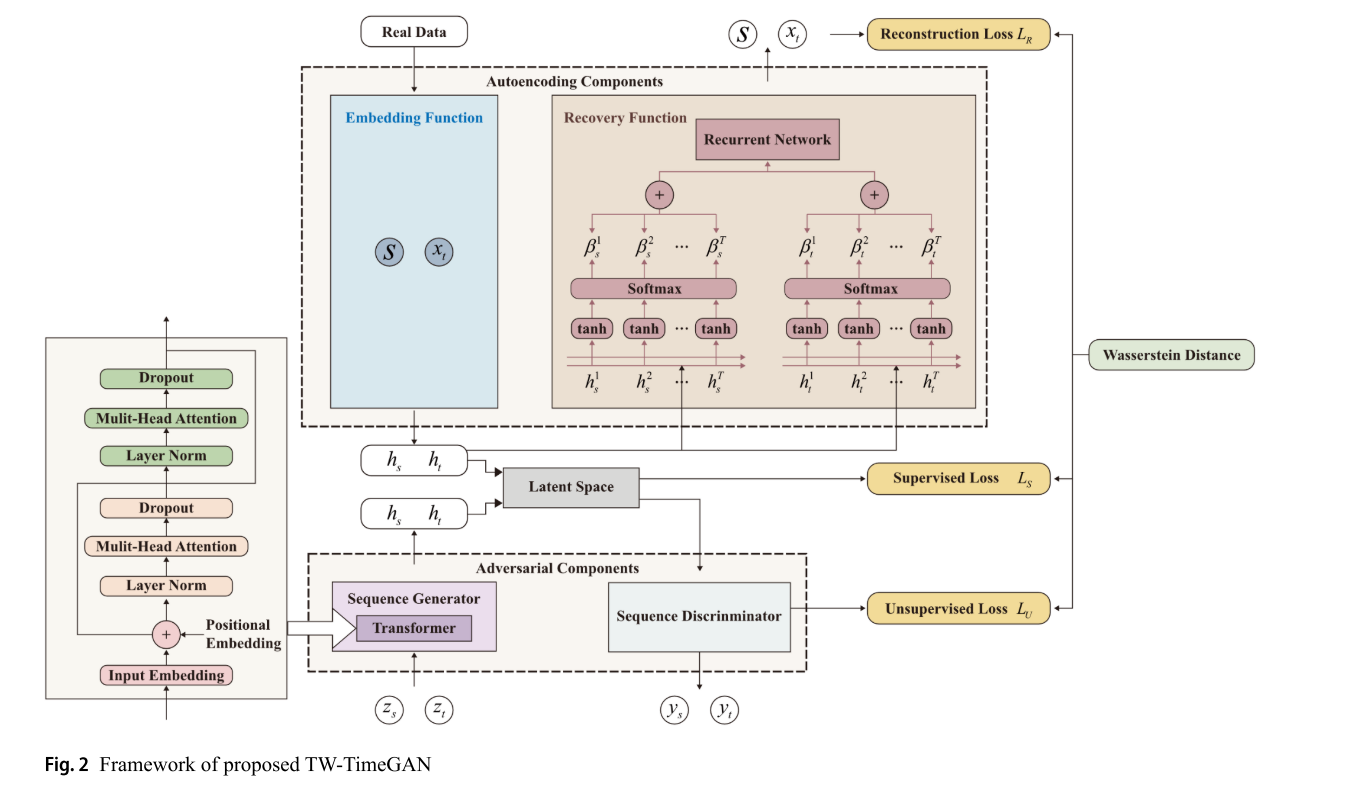
随着城市化加速,城市洪涝防治对高精度洪水预报需求迫切。当前模型分为物理机制驱动与数据驱动两类:传统水文模型依赖精确地理数据且计算复杂;数据驱动模型虽效率高,但神经网络需要大量洪水时序数据,而实际洪灾事件稀少导致样本不足,易引发过拟合问题。针对TimeGAN在洪水场景的应用局限,本文提出新型双注意力数据增强网络TW-TimeGAN。该模型创新融合Transformer架构与Wasserstein距离
本周周报主要讲述了注意力机制中更加细节的内容,周报讲述了相关的复杂性如果通过多头注意力机制解决的方法,并讲述了注意力机制如果通过位置编码方式解决先后位置的问题。此外,本周周报在注意力机制的章节中,将self-attention与CNN和RNN进行了比较以及其在实际场景的应用。在RNN的章节中,本周报详细描述了RNN的概念、RNN的变形拓展、以及LSTM。然后,本周报在Pytorch的章节,讲述了优

这周主要对Deep Learning进行了进一步的学习,内容包括反向传播算法的过程原理。还学习了regression,根据宝可梦的案例学习到了Loss中使用正则化的技巧。此还继续学习了Pytorch课程,包括学习Dataset和Dataloader各自的功能,以及Dataset的代码实战。
(一)熟悉常用的 Linux 操作cd 命令: 切换目录(1)切换到目录“/usr/local”(2)切换到当前目录的上一级目录(3)切换到当前登录 Linux 系统的用户的自己的主文件夹ls 命令: 查看文件与目录(4)查看目录“/usr”下的所有文件和目录mkdir 命令: 新建目录(5)进入“/tmp” 目录,创建一个名为“a”的目录,并查看“/tmp” 目录下已经存在哪 些目录(6)进入“
本文系统介绍了量子计算的核心原理与数学基础。量子比特利用叠加态实现并行计算,其状态由复数概率幅描述,遵循量子力学的三大基本假设:量子态空间、幺正演化和复合系统张量积。量子计算的关键特性包括量子并行性、纠缠态和可逆运算,通过量子干涉实现高效算法(如Shor算法和Grover搜索)。然而量子退相干效应是主要挑战,需在远小于退相干时间内完成运算。这些原理为量子算法设计提供了理论基础,也指明了未来量子纠错
本周周报主要对GAN剩下的知识进行了补充学习。周报详细描述了训练GAN存在的难点和训练GAN时的一些技巧,然后还介绍了如何去评估一个GAN的性能的好坏。此外,周报还补充了之前提到的条件型GAN(conditional GAN)。最后,周报通过头像风格迁移引出了Cycle GAN(循环对抗生成网络),并详细描述了其概念原理、应用场景以及其拓展。

本案例共包含4个实验步骤。(1)本地数据集上传到数据仓库Hive。(2)Hive数据分析。(3)Hive,MySQL、HBase数据互导。(4)利用R进行数据可视化分析。实验整体的流程如下:将数据源抽取到HDFS存储;通过Hive清洗、处理和计算原始数据;HIve清洗处理后的结果,可以存入Hbase或者其它数据库中例如MySQL。

本周周报在机器学习的理论内容中,概述了Transformer里面Decoder的内容,其中包括Decoder的结构、autoregressive decoder(自回归解码器)以及non-autoregressive decoder(非自回归解码器),此外还讲述了Transformer 的训练过程,并在最后提供了序列到序列模型训练常用的Tips。在Pytorch代码学习中,本周报详细的讲述了训练模
