


- @Walksunw


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
摘要: 2025年10月,李飞飞团队发布实时生成式世界模型RTFM,仅需单块H100 GPU即可运行。RTFM基于三大原则:效率(交互式帧率推理)、可扩展性(端到端学习渲染,无需显式3D建模)和持久性(3D空间记忆实现无限交互)。其核心技术采用自回归扩散变换器,通过海量视频数据学习渲染规律,将物理渲染转化为数据驱动的感知任务,直接预测新视角画面。RTFM还创新性引入**"姿势帧"

摘要 ExGRPO(基于经验分组的相对策略优化)是一种新型大模型推理训练框架,解决了传统强化学习方法的三大痛点:经验浪费、奖励噪音和训练低效。该技术通过动态筛选中等难度(25%-75%正确率)且低熵(逻辑连贯)的解题轨迹构建"智能错题本",采用混合On/Off-policy优化策略,结合组内相对评估机制,显著提升训练效率。实验表明,在数学推理任务中,ExGRPO使样本利用率提升
【摘要】清华大学与智谱AI联合发布Glyph框架,创新性地通过视觉压缩技术突破大模型的长文本处理瓶颈。该框架将文本渲染为图像,利用视觉语言模型(VLM)处理,在保持精度的同时实现3-4倍token压缩。Glyph采用三阶段技术路径:持续预训练建立视觉-语言对齐能力;LLM驱动的遗传搜索算法优化渲染参数;强化学习与OCR辅助任务提升细节理解。实验表明,该方法显著降低算力消耗,使128K窗口模型能处理

DeepSeek-OCR推出革命性"光学压缩"技术,仅30亿参数即实现10倍无损压缩,在单张A40显卡上日处理20万页文档。该技术将文本转为图像后用视觉token压缩,100个token可还原千字文档(97%精度),比传统方法节省90%资源。模型采用仿生设计模拟人类记忆遗忘曲线,支持6种分辨率模式自动切换。核心架构包含高效压缩的DeepEncoder编码器和低延迟的3B-MoE
谷歌DeepMind正式发布新一代AI模型Gemini 3.0,推出Pro专业版与Flash轻量版两个版本。该模型在代码生成和全场景适配方面实现重大突破,可一键生成完整Web操作系统,编程能力显著超越GPT-5等竞品。技术亮点包括改进的MoE架构、多模态融合和终端适配优化,使延迟降低至前代的1/3,并支持8GB显存本地部署。实测显示,Gemini 3.0能生成功能完整的Web版macOS系统,在物
微信AI与清华大学联合发布的CALM模型突破了大语言模型的传统token预测范式,创新性地将多个token压缩为语义向量进行预测。该模型通过四个核心模块实现端到端生成,其中语义压缩模块采用自编码器实现99%准确率的无损压缩,生成模块则基于Energy Transformer实现连续向量预测。研究表明,当K=4时,CALM在保持性能相当的前提下,训练算力降低44%,推理算力降低34%,显著提升了效率
摘要:GitHub 2025年数据显示TypeScript以263.6万贡献者超越Python登顶,增长66%。这一变化反映开发范式转型:类型化语言成为AI时代的首选,现代框架默认使用TS,其严格类型系统显著提升AI代码可靠性。Python虽在AI领域仍以58.2万仓库占据主导,但TS与Python形成互补格局,分别代表工业级开发与快速迭代的不同优势。微软TS Native预览版性能提升10倍,进
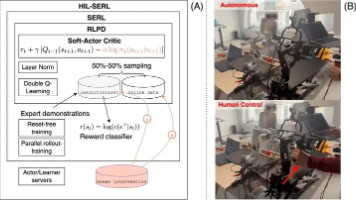
HuggingFace联合牛津大学推出《Robot Learning: A Tutorial》教程和LeRobot开源工具库,为机器人学习新手提供"理论+实践"的入门指南。教程从传统机器人学的局限切入,详细讲解强化学习、模仿学习等核心技术,并配套开源工具包,包含SOTA方法、预训练模型和模拟环境。特别推荐轻量化VLA模型SmolVLA,参数仅4.5亿,适合初学者调试。这套资源降
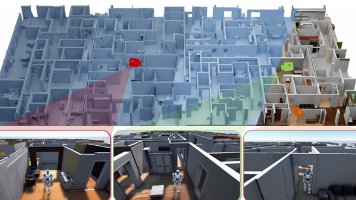
华为联合高校推出世界模型WorldGrow,实现室内3D场景生成技术突破。该模型能在单张A100显卡上30分钟生成272㎡高质量连贯场景,解决了传统AI建模中边缘断裂、逻辑混乱等问题。通过"双生成器搭档"和三线性插值算法,WorldGrow实现了高精度细节与逻辑化布局,测试指标FID值仅7.52。值得注意的是,这项由华为实习生主导研发的技术,已通过论文公开并集成至华为云盘古大模
本文原是github开源项目MC_thread_pool的说明文档,原文发送在此,同时本文中所有代码均在github中有完整实现,查看代码请移步github仓库!
