


- @Tony_Shen


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
Tab5PC开源项目是基于ESP32-P4的嵌入式DOS模拟器,可在巴掌大的M5Stack Tab5上运行FreeDOS,支持VGA图形、SoundBlaster16与AdLib音效、SD卡镜像存储及Wi-Fi文件传输,性能相当于1990年代初486电脑。可安装UCDOS+WPS实现中文办公,运行Doom、Wolfenstein等经典DOS游戏,适合教学演示与复古展示。通过烧录固件并配置SD卡,用

本设计基于ESP32-S3实现低延迟TTS语音播放系统,具备配置管理、网络拉流、音频解码播放与实时频谱可视化四大功能。通过多路输出架构将解码后的PCM分发至I2S功放与FFT分析模块,保障音视频同步;采用局部增量刷新策略优化1.9英寸屏幕显示性能,避免残影;结合全局状态机与空值兜底机制,确保配置可靠性与运行稳定性。整体方案兼顾实时性、低功耗与用户体验,适用于嵌入式语音交互场景。

本文介绍基于ESP32的智能播报系统,其服务端为单文件Python程序,运行于局域网Linux主机,实现协议转换、流量适配与成本控制。采用单线程阻塞模型,通过缓存机制避免重复调用云端TTS接口,支持流式音频下发,指令解析严格按“TTS|音色|文本”格式处理,兼容空值与异常输入。服务端部署简单,依赖仅requests库,具备高可维护性与故障可复现性,适用于自用场景。

SSR-Net是一种超轻量级年龄/性别识别模型,其CoreML版本仅0.17MB,性能接近主流大模型。采用多阶段回归策略,将年龄估计分解为多个小粒度分类任务,解决量化分组问题。支持实时摄像头检测,结合LBP或MTCNN人脸检测器实现高效推理。提供IMDB/WIKI/Morph2等数据集预训练模型,适合移动端及资源受限场景。模型以JSON+H5格式存储,输入64x64 RGB图像,输出年龄值或性别分
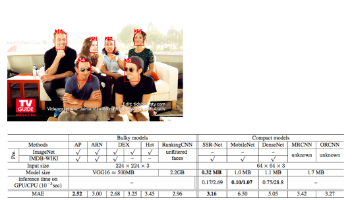
本文对比分析了轻量级离线模型、本地部署大模型和云端API调用大模型三大技术方案。从模型体量、部署位置、算力需求、隐私性等维度进行详细对比,指出轻量级模型适合MCU级设备实现简单感知,本地大模型适用于边缘设备处理复杂推理,云端API则适合大规模低成本部署场景。针对嵌入式领域,重点阐述了本地化部署大模型的技术路径,包括7B以下模型选型、量化工具选择(GPTQ/AWQ/TensorRT等)以及三类典型硬

本文介绍了在RK3588/RK3576平台上使用RKNNSDK进行模型部署和NPU加速推理的完整流程。首先详细说明了开发环境配置,包括硬件平台参数和软件环境搭建。然后逐步演示了如何安装RKNN运行时库、编译运行示例程序,重点讲解了YOLOv5模型的图片和视频推理实现。针对视频检测场景,文章详细说明了如何通过修改源码添加OpenCV显示功能,包括YUV420SP到BGR的转换、检测框绘制和文字标注等

ESP-Claw和MimiClaw是面向物联网设备的AI智能体框架。ESP-Claw基于ReAct模式,通过Lua脚本动态控制硬件,支持热更新;MimiClaw则是纯C实现的极简版,功能固化但资源占用低。两者均可在ESP32芯片上实现本地感知-决策-执行闭环,但定位不同:ESP-Claw适合灵活多变的通用场景,MimiClaw适用于固定功能的专用设备。分析指出,AI智能体更适合通用多变场景,传统嵌
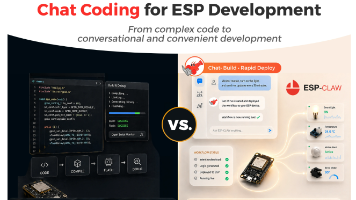
豆包语音TTS 2.0是字节跳动自研的高拟真语音合成模型,支持多语种、方言及情感驱动的自然表达,具备端到端流式合成能力。通过火山引擎API可实现低延迟、高保真语音输出,适用于智能硬件、数字人等场景。本文介绍其单向流式接口调用方法,包括请求构造、响应解析与Python测试方案,强调需按行处理NDJSON流、正确解码base64音频分片,并注意采样率与音色匹配,确保嵌入式设备稳定播放。

本项目基于ESP32-S3与Linux主机构建低延迟、可配置的实时语音播报系统,实现文字到语音的端到端流式合成。通过轻量Python服务中转豆包语音接口,支持音色选择、配置持久化、循环播报与频谱可视化,具备秒级响应、音频连续、显示不干扰等非功能特性。采用极简协议与模块化设计,解决传统方案改版难、调试复杂问题,适用于门店提示、教学演示等小批量自用场景,代码开源,部署灵活。

实时系统要求任务能够在规定的时间内完成响应,对于硬实时任务,错过截止时间可能会导致系统失败甚至产生严重后果。在诸如工业控制、汽车电子、航空航天等许多嵌入式应用场景中,需要系统对外部事件进行快速、确定性的响应,这就促使了 Linux 系统实时化技术的发展。
