


- @Queen_sy


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
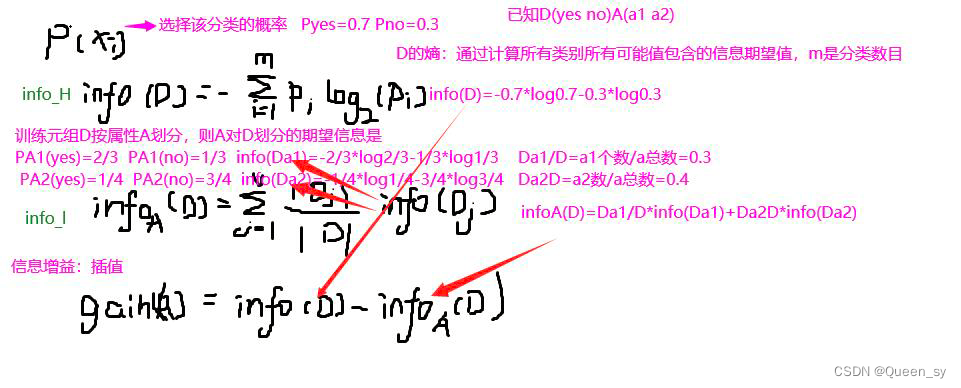
1、决策树是一个树结构(可以二叉或非二叉),每一个非叶子节点表示一个特征属性的测试,每一个分支代表这个特征属性在某个值域上的输出,叶节点存放类别。2、决策过程:从根节点开始,测试待分类项中相应的特征属性,并按照其值选择输出分支,直到达到叶子节点,叶子节点存放的类别作为决策结果。
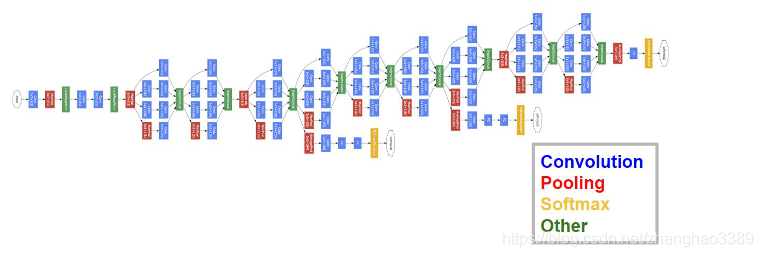
2)Conv包括1*1convolution 3*3convolution 5*5convolution。4)每个组合分支都先经过1*1convolution的好处是降低了计算量,如下图。3)卷积核超参数选择困难,自动找到卷积的最佳组合分支,最后采取不同权重。1)图中包括结构:Conv Average Pooling。
【摘要】本文展示了一个日期选择范围校验的实现方案,通过Vue+Element UI实现日期范围不超过7天的校验功能。关键点包括:1)在el-form组件中设置rules和prop属性;2)使用validator自定义校验函数计算日期差值;3)通过change事件触发校验。校验逻辑会检查日期范围是否为空和是否超过7天,并给出相应提示。代码示例中包含表单绑定、校验规则定义和日期变更处理等核心实现。
模型开始w是一个随机猜测,w=random value,搜索的过程:就是要找一个w最适合数据集的w目的:使得Σ(y^-y)²最小。最直接的方法:将认为权重可能取值的区间w_list=[]表示出来,循环,每层循环求取一个loss(损失) loss最小的w最佳,例如当权重增多时,并不可取。

GaussianNB解决连续型数据的模型,期望样本特征取值都是符合正太分布MultinomialNB 大文本集的分类处理(文章影评)适合有几个BernoulliNB小文本集的分类处理(短信、消息、商品评论)适合判断有无。

模型开始w是一个随机猜测,w=random value,搜索的过程:就是要找一个w最适合数据集的w目的:使得Σ(y^-y)²最小。最直接的方法:将认为权重可能取值的区间w_list=[]表示出来,循环,每层循环求取一个loss(损失) loss最小的w最佳,例如当权重增多时,并不可取。
【代码】Dataset and DataLoader加载数据集+采用mini-batch糖尿病数据集的逻辑回归。
模型开始w是一个随机猜测,w=random value,搜索的过程:就是要找一个w最适合数据集的w目的:使得Σ(y^-y)²最小。最直接的方法:将认为权重可能取值的区间w_list=[]表示出来,循环,每层循环求取一个loss(损失) loss最小的w最佳,例如当权重增多时,并不可取。
下面的PAD表示填充,填充就是当句子长度不满足max_len时候,会填充pad。## 这里有两个数据进行输入,一个是enc_inputs 形状为[batch_size, src_len],主要是作为编码段的输入,一个dec_inputs,形状为[batch_size, tgt_len],主要是作为解码端的输入。一定需要注意的是这里得到的矩阵形状是batch_size x len_q x len_k

1)w.data表示张量w的值,其本身也是张量,输出格式tensor[数]。2)w.grad表示张量w的梯度,其本身w.grad是张量 用时(标量计算时)需要取w.grad.data,表示张量w.grad的值,输出格式tensor[数],(梯度输出时)需要取w.grad.item(),表示返回的是一个具体的数值,输出格式 数>3)w.grad.item()l.item() 表示返回的是一个具体的数
