- @NVIDIA_Community


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本文介绍基于NVIDIA NeMo Claw构建的内存驱动型智能体——办公室主任,通过结构化自我模型(人员、项目、优先级等)实现企业工作流的持续上下文维护与决策优化。该设计强调证据、知识与行动分离,支持选择性检索、用户校正与审计追踪,提升任务准确性与可信度。实测显示,其在事实跟踪、实体消歧、多源合成等任务上显著优于传统RAG。结合NVIDIA OpenShell实现安全沙盒运行,保障权限与边界控制
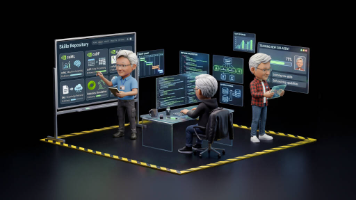
随着越来越多的团队从人形机器人启动转向特定任务的技能开发,对可重复开发工作流的需求也与日俱增。构建人形机器人仍然十分复杂,而且当今的开发流程仍然高度分散。因此,开发者在专注于构建机器人功能之前,会花费大量时间来配置机器人基础设施。虽然机器人社区已经开发出跨流程各个阶段的工具,但由于软件生态系统孤立、数据格式不兼容以及工具之间的手动集成,将它们连接到无缝工作流仍然是一项挑战。为解决这一问题,我们推出
构建 TensorRT 引擎可能需要几秒钟到几分钟的时间。大型强类型模型、深度策略搜索和全新 GPU SKU 上的冷定时缓存可能会让开发者、最终用户或 AI 智能体盯着冻结的终端,而不知道是否要等待、重试或终止该进程。大多数 NVIDIA TensorRT 集成在构建过程中不会报告任何内容,或者无法提前终止。在长时间运行的智能体工作流中,这会浪费 GPU 小时并导致会话卡顿。图 1. 用于 Ten

编码正成为长期运行的机器学习 (ML) 工作流程的实用运算符。他们可以检查资源库、设置运行时、解决构建问题、启动实验、监控执行、分析指标并汇总结果。对于研究而言,这一点很重要,因为有意义的指标通常只有在基本实验基础设施就绪后才会出现。是 Andrej Karpathy 的一个开源 Python 项目,用于自动化 AI 和 ML 模型训练。通过这种方法,将高层次的目标转化为假设,编辑和测试真实的代码

是一个开源分布式 SQL 引擎,可对超大型数据集快速运行交互式查询。在 NVIDIA GPU 上,Presto 可为分析查询工作负载提供峰值性能,并为用户和智能体提供低延迟。GPU 加速的 Presto 可降低分析工作负载的延迟,让您和智能体畅通无阻并尽可能快地进行迭代。本文将介绍如何使用单节点和多节点在扩展分析基准测试中高效执行多 GPU Presto。我们还强调了在与数据源搭配使用时对 NVI

NVIDIA DGX Spark以GB10超级芯片与128GB高速统一内存为核心算力底座,凭借轻量化、全流程、高性能的特性,系统性解决智能安防与工业智能方案研发过程中数据处理慢、模型迭代难、推理延迟高、落地验证繁琐等痛点。通过构建视频智能分析、设备预测性维护两大AI能力体系,全方位赋能安防智能化管控与工业数字化运维,为智慧城市、智能制造领域的轻量化AI研发与场景落地提供高性能、高可靠的标杆方案。后
CUDA 13.3 为 NVIDIA GPU 带来了一个缺失的基元:硬件加速的无携带乘法。我们对两个工作负载 ( GHASH 和 sum-check 协议) 进行了基准测试,在 B200 上,速度分别提高了 18.8 倍和 13 倍。最大的收益显示了现代密码学的发展方向:大输入身份验证加密和二进制域零知识证明。
现代芯片设计日益受到工程时间的限制。寄存器传输级 (RTL) 开发和验证需要具备专门的硬件知识、精确的推理能力以及与电子设计自动化 (EDA) 工具的重复交互。LLM 加速了代码生成,而 AI 智能体通过使用验证反馈来迭代纠正错误,从而扩展其影响。这对于 RTL 至关重要,因为 RTL 的正确性取决于精确的时间行为,并且许多错误仅在基于工具的验证期间才会出现。
人才招聘数字化转型已是企业刚需,传统人工招聘模式效率低、误差大、周期长等痛点严重制约企业发展。NVIDIA轻量化个人 AI 超算 DGX Spark 打造本地部署、高速推理、数据安全的智能招聘解决方案,依托 AI 自动简历解析、大数据多维度人岗匹配、全流程智能协同三大核心能力,一站式解决招聘全周期各类痛点,在人力投入、人岗匹配精度、招聘周期三大维度实现突破性优化,为各规模企业搭建高效、精准、安全的

工业机械产生的警报数量超过技术人员能够进行分类的数量。对于每个需要跟进的重要警报,技术人员都会提取历史背景,确定正确的程序,检查专家信号是否确认故障模式,并编写建议。此过程保持一致,非常适合。本文将讨论使用库构建的按警报分析 AI 智能体,使用开放智能模型和安全运行时。该智能体是端到端 GPU 加速的,位于单个 HTTP 端点的后面。任何上游 (流中过滤器,操作者用户界面中的单击按钮) 都以同样的