- @LoseInVain


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
最近我在恶补一些经典的LLM工作,之前也精读过MetaLM这个工作但是没有及时笔记,现在已经有些遗忘了,因此在过年期间复习了下,在此笔记希望对诸位有所帮助。

markdown数学公式编辑目录希腊字母常见操作大全数学符号大全其他希腊字母编号大写代码大写渲染结果小写代码小写渲染结果1NAA\alphaα\alpha2NAB\betaβ\beta3\GammaΓ\Gamma\gamm
[darknet源码系列-1] darknet源码中的常见数据结构FesianXu 20201117 at UESTC前言最近笔者在好奇如何从最底层开始搭建一个深度学习系统,之前都是采用现成的成熟深度学习框架,比如PyTorch,TensorFlow等进行模型的搭建,对底层原理了解不是特别深刻。因此笔者最近在阅读darknet的源码,希望能从中学习到一些底层的知识,本文主要是对darknet中常见
此文翻译自[1],[1]对数据并行和模型并行进行了很好地区分,因此这里推荐给大家。介绍现在深度学习模型的参数量已经变得越来越多了,数据集的尺寸也随之疯狂地增长。为了在一个巨大的数据集上训练一个复杂的深度学习模型,我们不得不使用多节点的并行方式,否则我们永远不可能达到这个目的。这里谈到的并行,通常指的有两种,或者它们各自的混合:数据并行 (Data Parallel)模型并行 (Mode...
在深度学习中,经常需要动态调整学习率,以达到更好地训练效果,本文纪录在pytorch中的实现方法,其优化器实例为SGD优化器,其他如Adam优化器同样适用。一般来说,在以SGD优化器作为基本优化器,然后根据epoch实现学习率指数下降,代码如下:step = [10,20,30,40]base_lr = 1e-4sgd_opt = torch.optim.SGD(model.paramet...
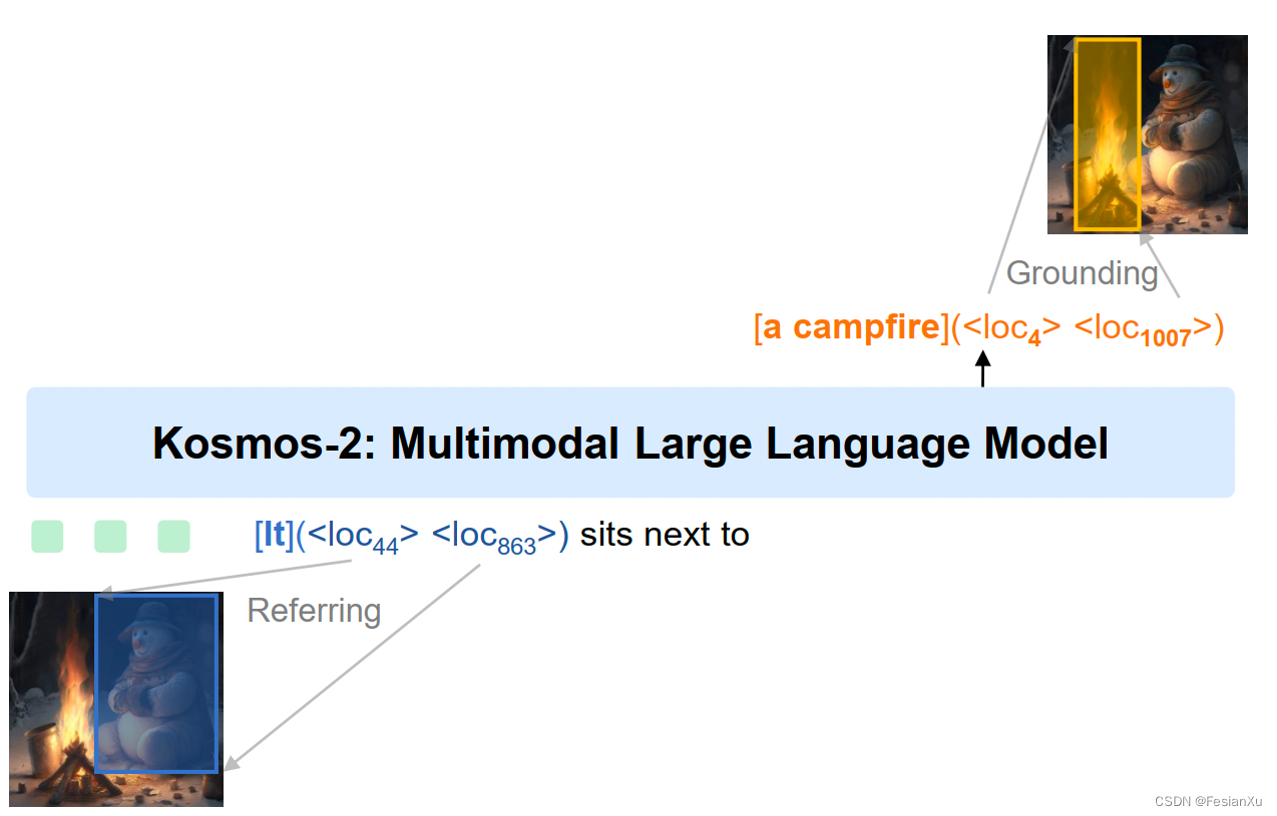
kosmos-2:一种提供了基准和指代能力的多模态大语言模型
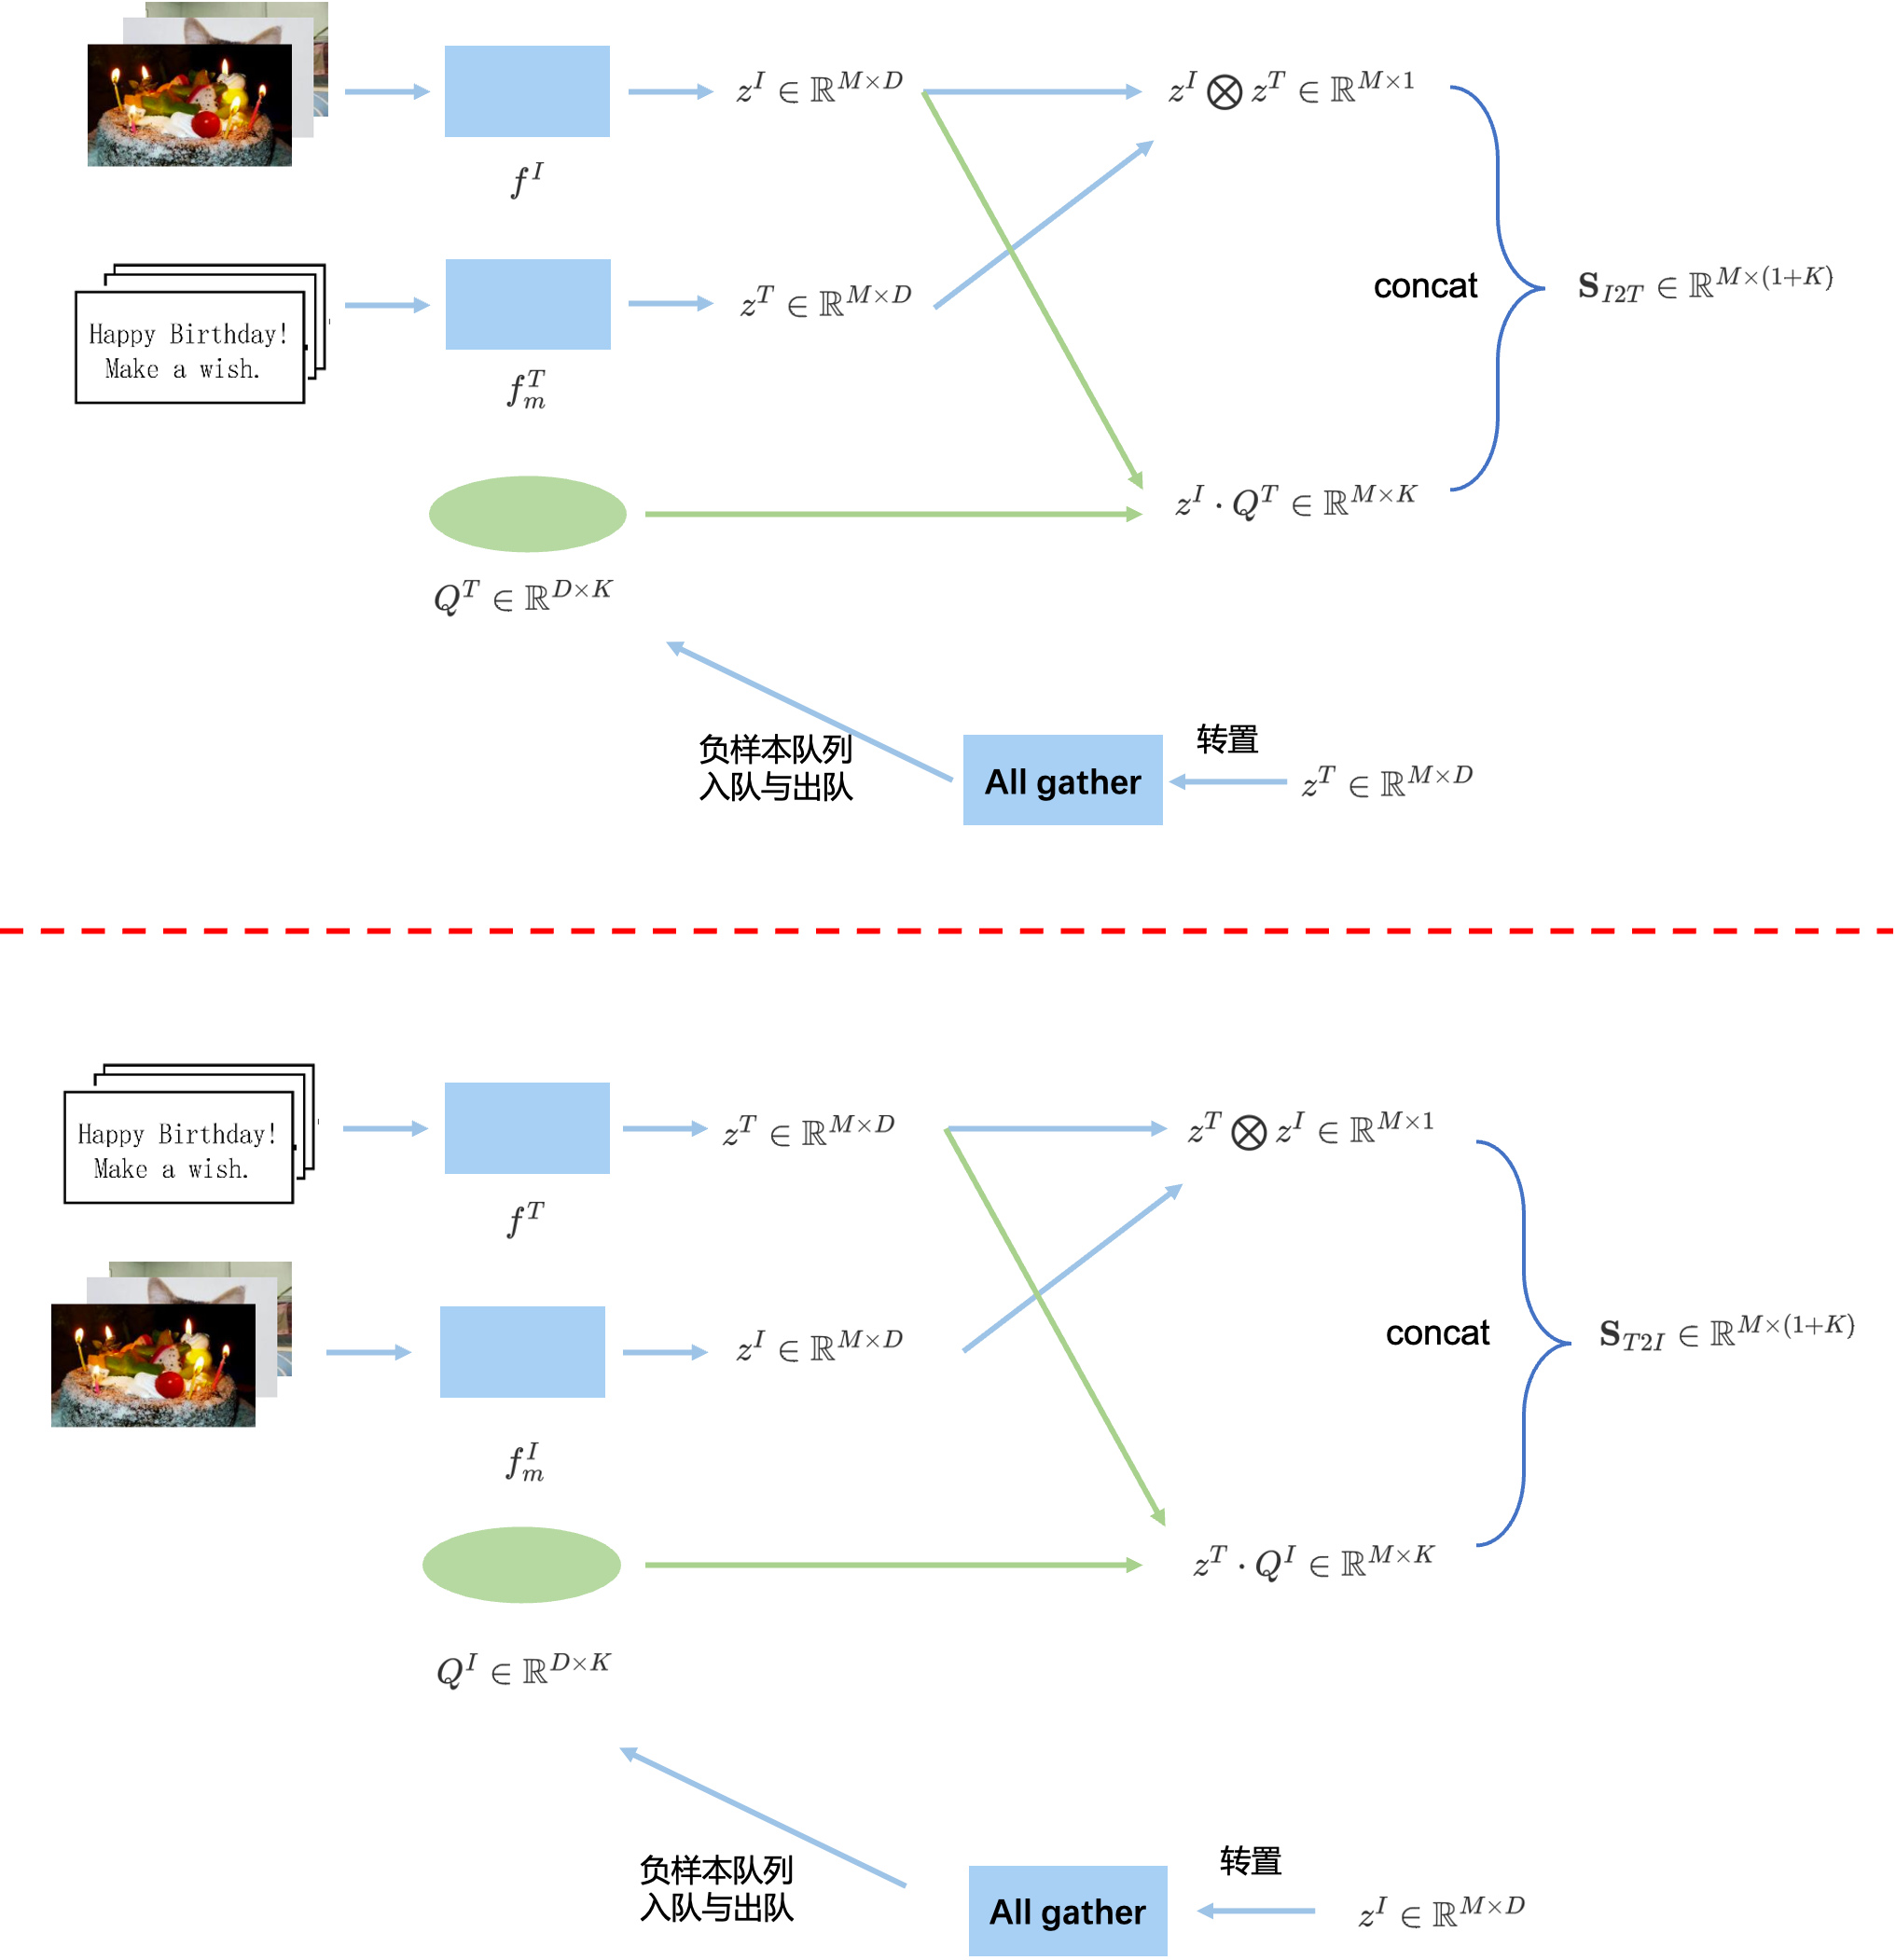
图文搜索系统中的多模态模型:将MoCo应用在多模态对比学习上FesianXu 20210917 at Baidu Search Team前言之前我们在[1]中介绍过超大负样本对于对比学习训练的重要意义,并且在[2,3]中介绍了MoCo,Memory Bank等方法去突破硬件限制地去进一步增大负样本数量。然而,之前这些方法都尝试在单模态数据上进行对比学习[4],在文章[5]中,作者团队提出了WenL
联系方式:e-mail: FesianXu@163.comQQ: 973926198github: https://github.com/FesianXu如有谬误,请联系指正。转载请注明出处文章目录基模型参数加载从持久化模型开始加载模型吧部分加载模型模型Fine-Tune给每一层或者每个模型设置不同的学习率Pytorch内置的模型Reference我们在使用pytorch的时候,经常...
本文探讨了大语言模型(LLM)训练中的偏好对齐方法,重点介绍了直接偏好优化(DPO)和近端策略优化(PPO)两种方法。偏好对齐通过对比正负样本(如奖励模型筛选或人工标注)优化模型回答质量,避免仅依赖行为模拟(SFT)导致的泛化不足问题。DPO通过引入初始模型约束和Bradley-Terry偏好模型,稳定训练过程并防止奖励劫持。实验表明,无约束优化易生成无意义回答,而DPO结合KL散度约束能有效提升
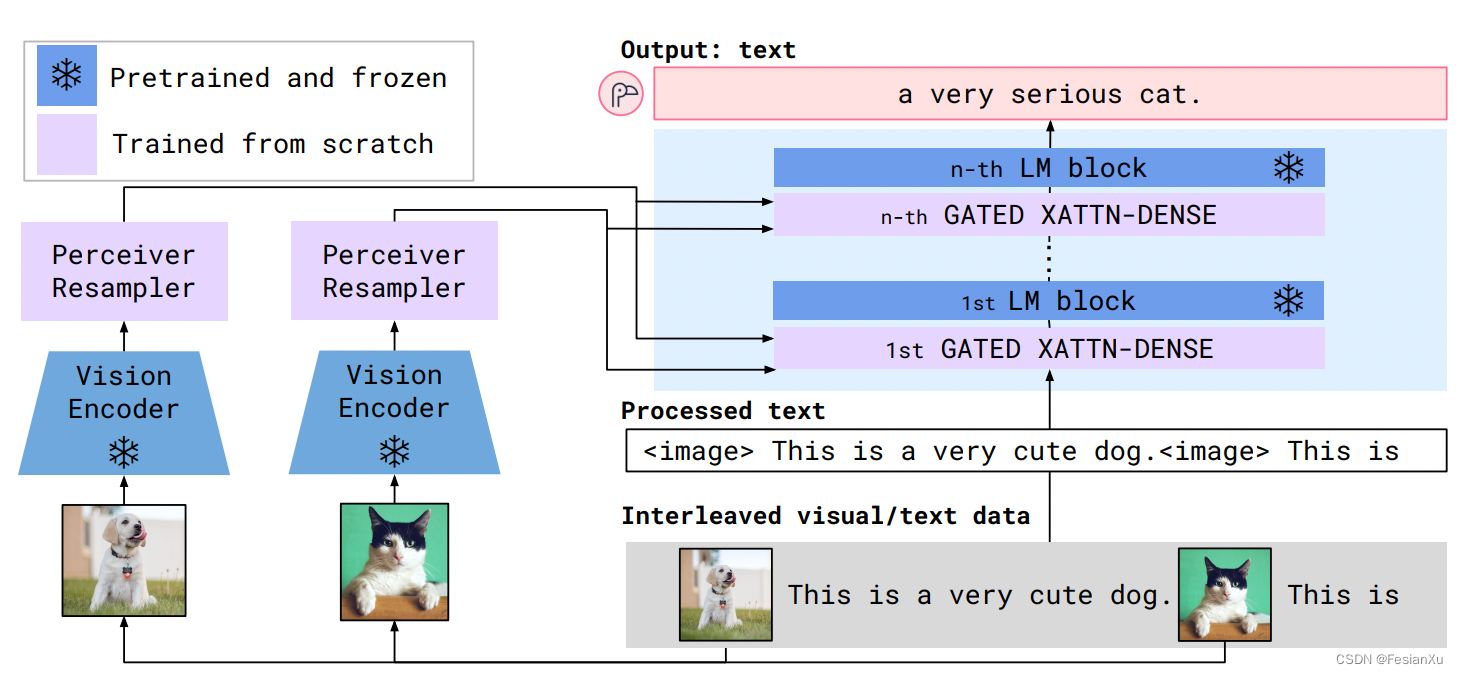
Flamingo算是DeepMind的多模态融合LLM的一个较老的工作了(2022年),之前粗略读过没来得及及时总结,本次过年笔者重新细读了论文,发现其在50多页的论文中有着不少细节,本文对该工作进行读后感笔记。