


- @JXL1860


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
基本定义回顾:大的batch有平行计算加持,其实并不比小batch慢算整个epoch的时候,其实小batch,不一定算快重点讲解:GPU并行计算带来的反直觉效率如果大批次更快,我们为什么不总是用它呢?下一部分给出了颠覆性的答案:训练效果。重点讲解(一):“带噪声的梯度”有助于优化重点讲解(二):小批次能找到“更好”的最小值,提升泛化能力核心问题:为什么小批次训练的模型在**测试集(Test Set

通才”不是指Prompt把模型变成了通才,而是指模型本身已经被训练成了一个“通才”。它在海量数据中学习了语言、逻辑、知识和多种技能的潜在模式。Prompt的作用是“激活”和“引导”。它像一个开关或一个指令,告诉这个强大的通才模型:“嘿,现在请启动你的‘翻译’技能”或者“现在请启动你的‘创意写作’技能”。

总结深度学习4个关键组件

使用gemini 2.5 flash Image -preview生成模型,整体体验让人印象深刻,尤其是在和方面。首先,最直观的感受是生成速度,比之前用过的GPT-5感觉要迅捷不少,几乎是瞬间出图,大大提升了创作效率。其次,在图像质量上,这款模型对尤为出色。它能精准捕捉复杂的光影变化,让人物面部和环境阴影看起来非常自然且富有层次感,大大增强了图像的真实感和艺术性。在不同平台的使用体验上,无论是AI

使用gemini 2.5 flash Image -preview生成模型,整体体验让人印象深刻,尤其是在和方面。首先,最直观的感受是生成速度,比之前用过的GPT-5感觉要迅捷不少,几乎是瞬间出图,大大提升了创作效率。其次,在图像质量上,这款模型对尤为出色。它能精准捕捉复杂的光影变化,让人物面部和环境阴影看起来非常自然且富有层次感,大大增强了图像的真实感和艺术性。在不同平台的使用体验上,无论是AI
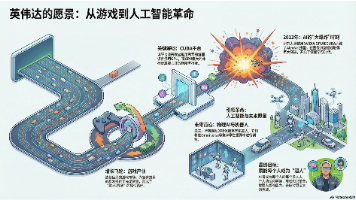
最后,他用新款GeForce显卡生动地诠释了这一点:在渲染一个4K屏幕的800万像素时,GPU只精确计算了其中一小部分(约50万),而其余绝大部分像素都是由AI根据已有信息智能填充的,效果却完美无瑕。黄仁勋解释了其中的“飞轮效应”:电子游戏代表了一个潜力巨大的市场,这个市场能够支撑庞大的研发预算,从而催生更先进的技术;这次赌注不仅为后来的AI革命铺平了道路,也奠定了英伟达一个核心的行事准则:永远为
Source EncoderChannel EncoderModulatorChannel + NoiseDemodulatorChannel DecoderSource DecoderSinkWorks at the information/coding level (bit sequences).Two main types:Source encoder: compresses data in

这让在容器中使用GPU变得极其简单,并且让您的容器镜像具有了真正的可移植性,可以在任何安装了NVIDIA Docker的机器上运行。当环境变得异常复杂时(例如,需要在最新的GPU上运行依赖旧版CUDA的旧项目),容器化技术就成了我们的终极武器。:您可以在容器里打包旧版的PyTorch和它依赖的旧版CUDA,然后在安装了最新驱动和GPU的机器上无缝运行。任何机器学习模型的运行,都离不开一个精确配置的

无需代码基础,通过轻松搭建个人网站、设计海报、制作播客;Coze(国内叫“扣子”)是字节跳动推出的一个。它本质上不是单一的大模型,而是一个“平台化工具”,提供可视化的工作流、插件接口、知识库(RAG)、长期记忆等能力,让用户(即使不懂代码)也能快速创建和部署自己的 AI 聊天机器人或任务型智能体。:像搭积木一样配置逻辑,不需要自己训练模型,就能做问答机器人、助手、客服、游戏 NPC 等。:可以上传

无需代码基础,通过轻松搭建个人网站、设计海报、制作播客;Coze(国内叫“扣子”)是字节跳动推出的一个。它本质上不是单一的大模型,而是一个“平台化工具”,提供可视化的工作流、插件接口、知识库(RAG)、长期记忆等能力,让用户(即使不懂代码)也能快速创建和部署自己的 AI 聊天机器人或任务型智能体。:像搭积木一样配置逻辑,不需要自己训练模型,就能做问答机器人、助手、客服、游戏 NPC 等。:可以上传