- @Fangyechy


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
然后统计byte gram,选出出现次数最多的byte gram,将其塞入到词表中,若组成的byte gram使得原本单独的部分无其他非组成该byte gram的情况,则该部分需要从原先的词表进行删除。然后向量是具有空间的,通过和积化差可以得到这个向量是由于某些向量线性组合而成,而线性组合也有对应的空间表示,从而通过线性组合区分位置关系。(位置信息是很重要的,词的意思可通过上下文进一步明确,上文放

方法就是乘上对应的权重。时,再让他去乘上对应曝光次数,即可得到商家获得利润💰。

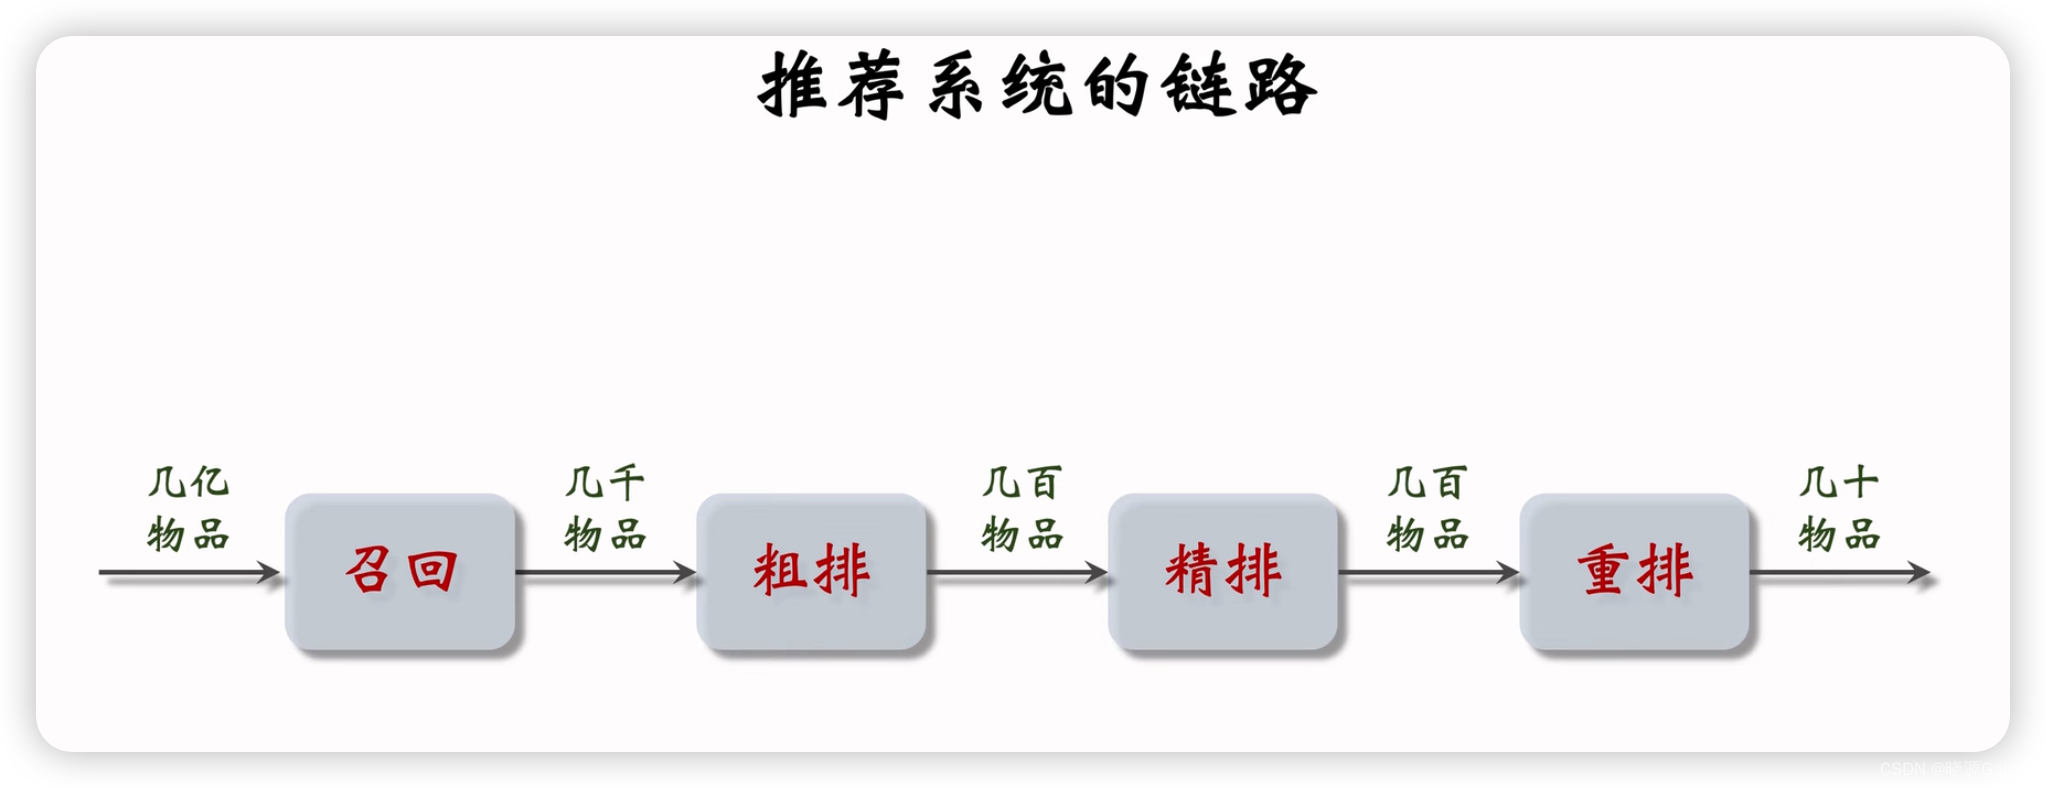
推荐系统整体框架由召回、粗排、精排、每次用户刷新页面,都会产生一个重新从数据库拿数据的流程。在这个流程中,包括召回、粗排、精排和重排四个阶段。其中召回会从数据库中使用多个召回通道,从而拿回相当的数据。这些数据先粗排后精排。在粗排过程中,会给每一个物品/评价进行打分,然后再进一步精排,最后插入广告,来进行最后一步的重排。(排序意味有相应的关键字用来比较,这里的排序常常是指,用模型去计算结果,然后按结
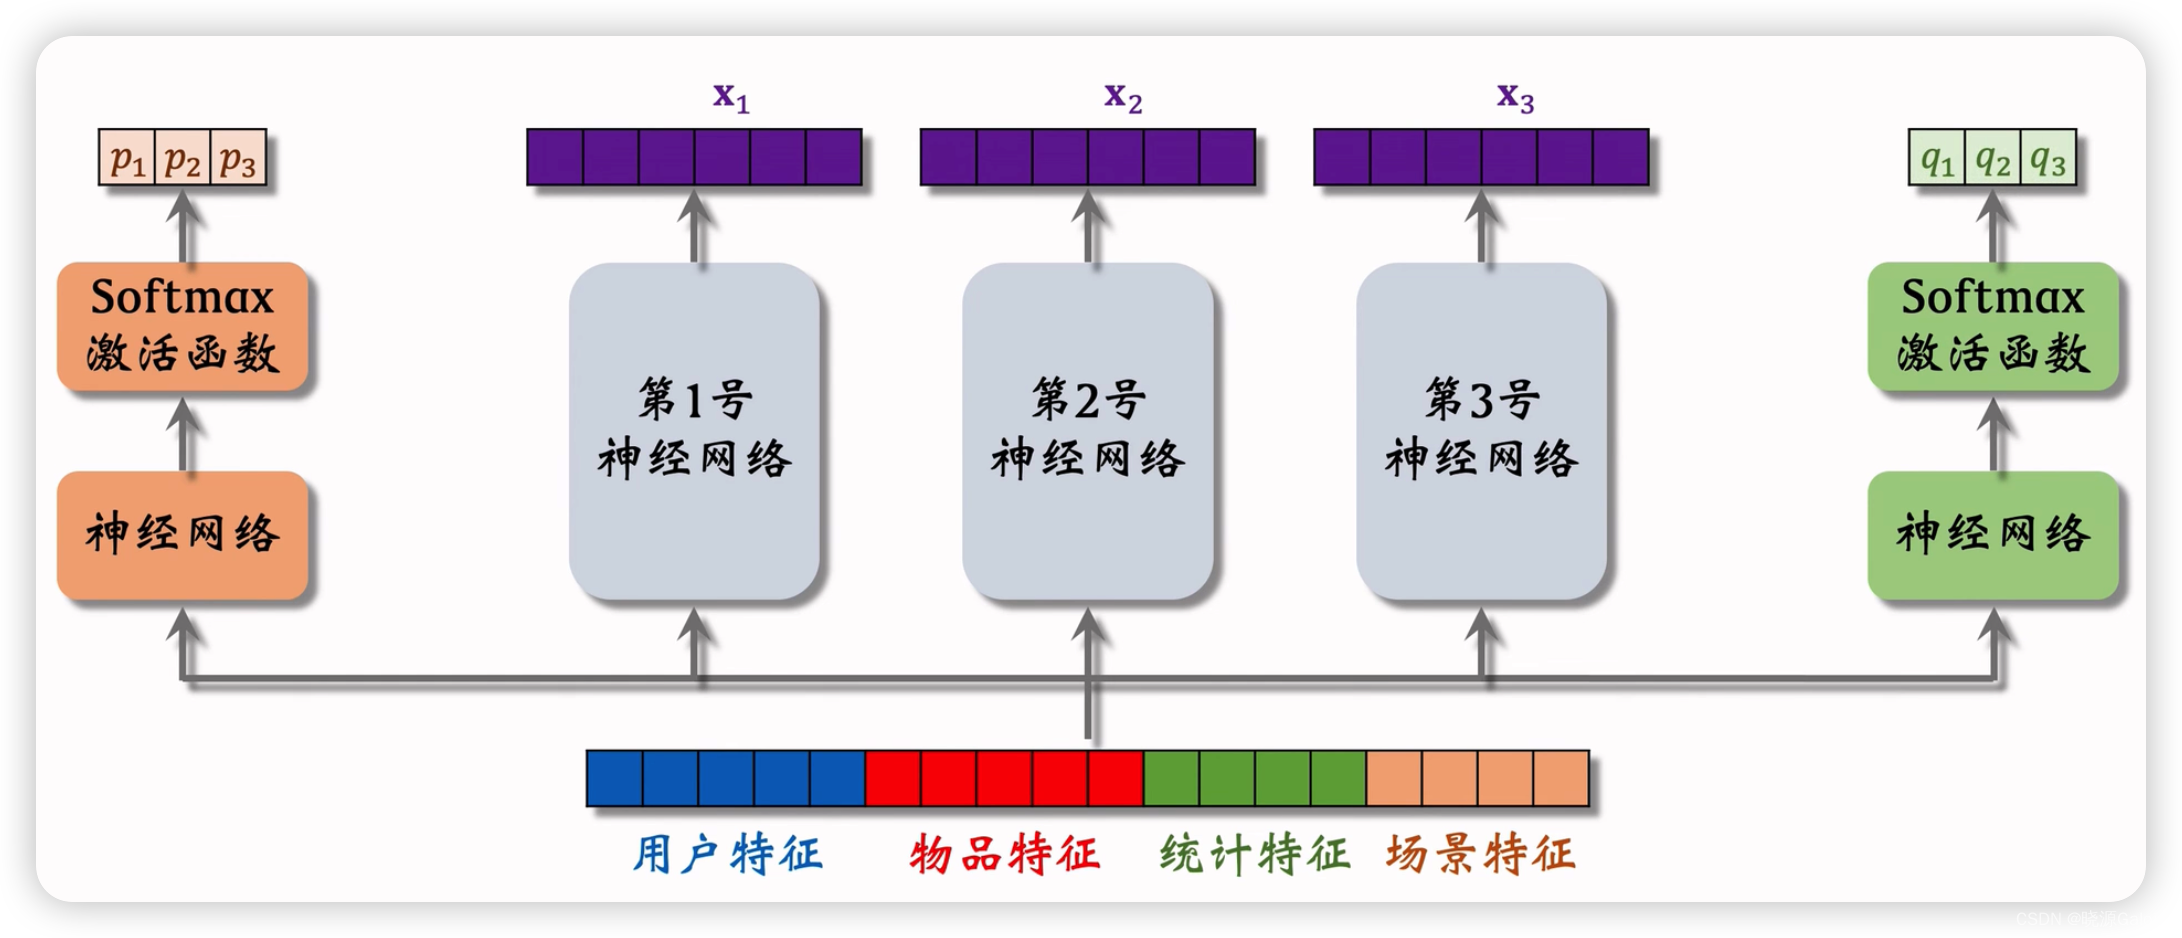
MMOE是指Multi-gate Mixture-of-Experts注意看Expert后面加了s,说明了有多个专家。而在MMOE中专家是指用来对输入特征计算的神经网络,每个神经网络根据输入计算出来的向量都会有所不同。
由于序列过大会造成运算次数的增加,而固执地采用后N个则会无法保持长期兴趣的数据,所以可以在保证序列长度固定的前提下,对N个挑选出来的对象进行操作。物品ID通过Embedding将会得到一个向量,性质差不多的向量在空间中也会处于差不多的位置,可以用取平均方式得到一个综合所有向量的向量。而这个所占的重量/占比,是需要和要查询的候选向量进行比较来得出,也就是所谓的相似度,相似度越大,受其影响也会越大。所
因为推荐链路包括召回、粗排、精排和重排四个阶段,每个阶段都可以尝试新的模型,也可以说每个阶段可以由不同的部门进行负责,而每一个部门都可以提出使用A/B测试的请求(领走一批用户作为测试),所以有可能用户是不够用的。其中小流量是指对部分的用户先尝试改进的算法模型,而非全部。若为全部,如果算法模型存在问题,可能会导致用户体验差,导致用户流失,而小流量的损失代价相对小。互斥,不要同时对同一层的同一批/桶用
补码的一位大小的乘法。
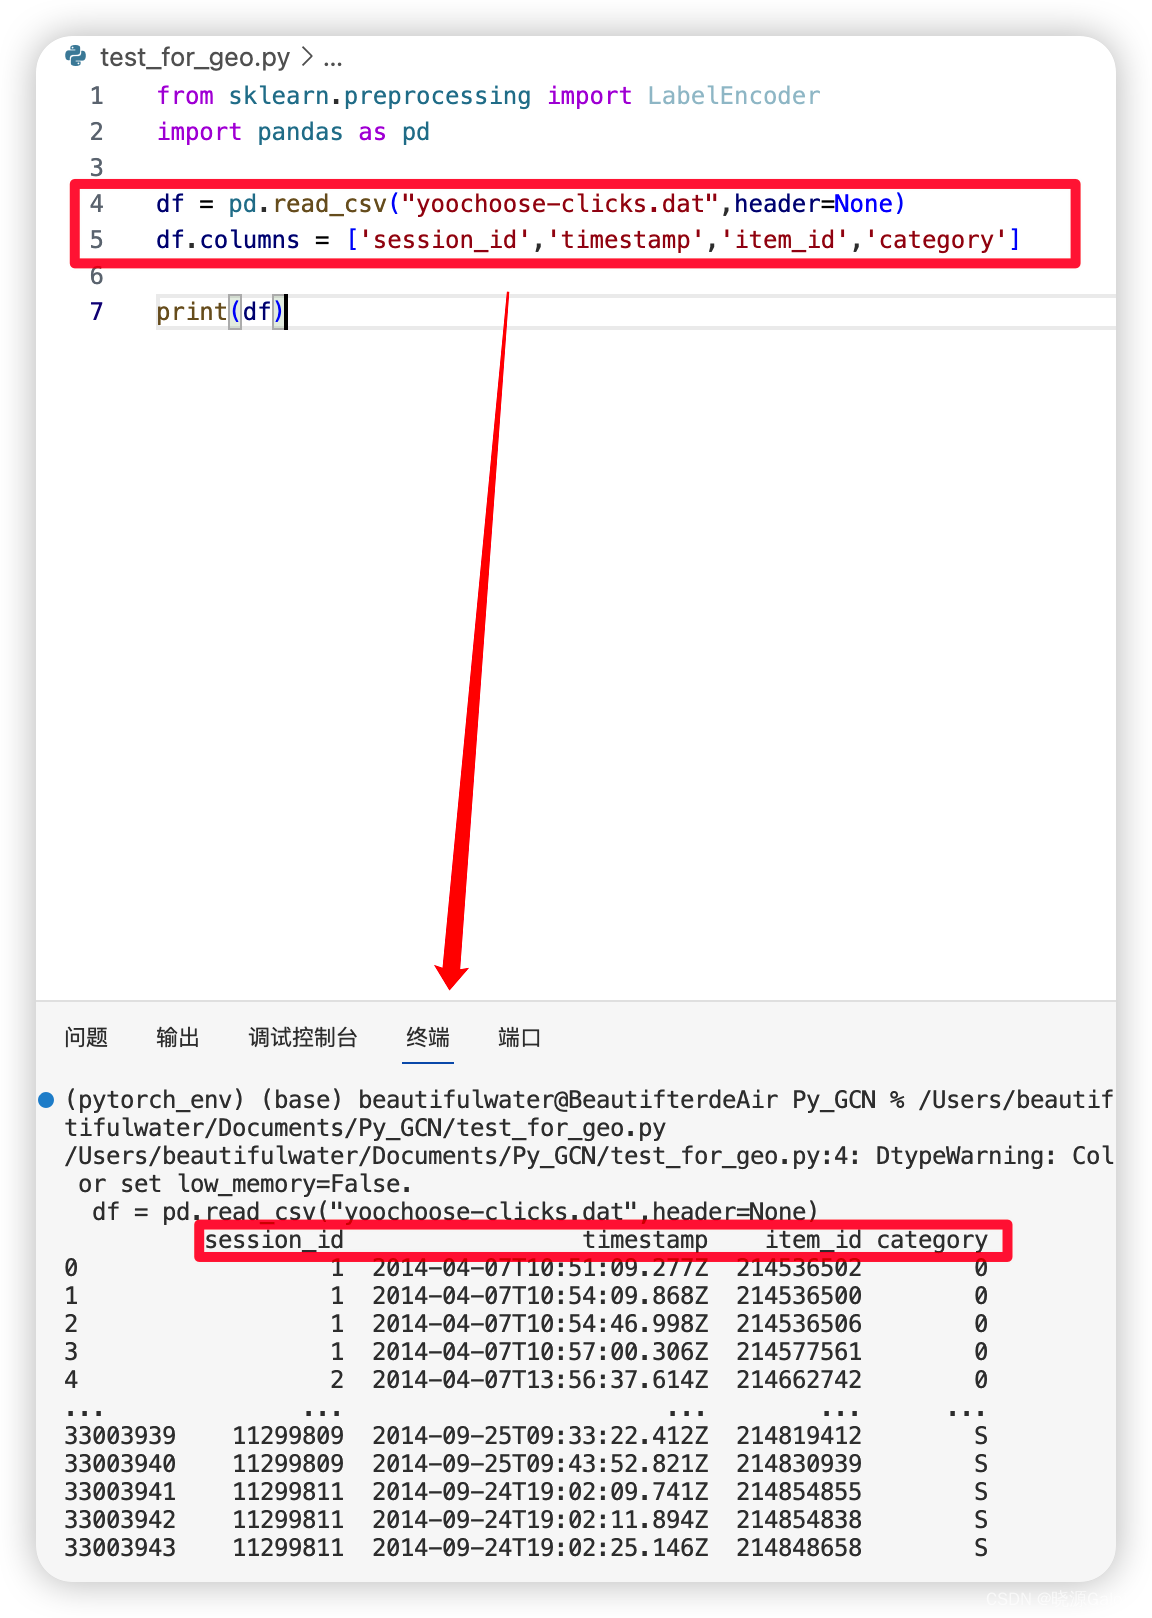
第二步,刚开始这些点并没有图的编号(有session_id,但并不是一个方便建图的编号),于是可以采取按某一个关键字进行排序的方法,按大小给图上的节点进行重新编号。表示的是某次会话下的某个操作,category代表购买情况,其中0代表未购入,1代表购入。考虑复用性的话,记得将构造出来的数据集进行保存。应用场景:数据集过多,抽取部分数据进行观察。可以选取出列表/集合中的其中一项。表示的是某次会话的编
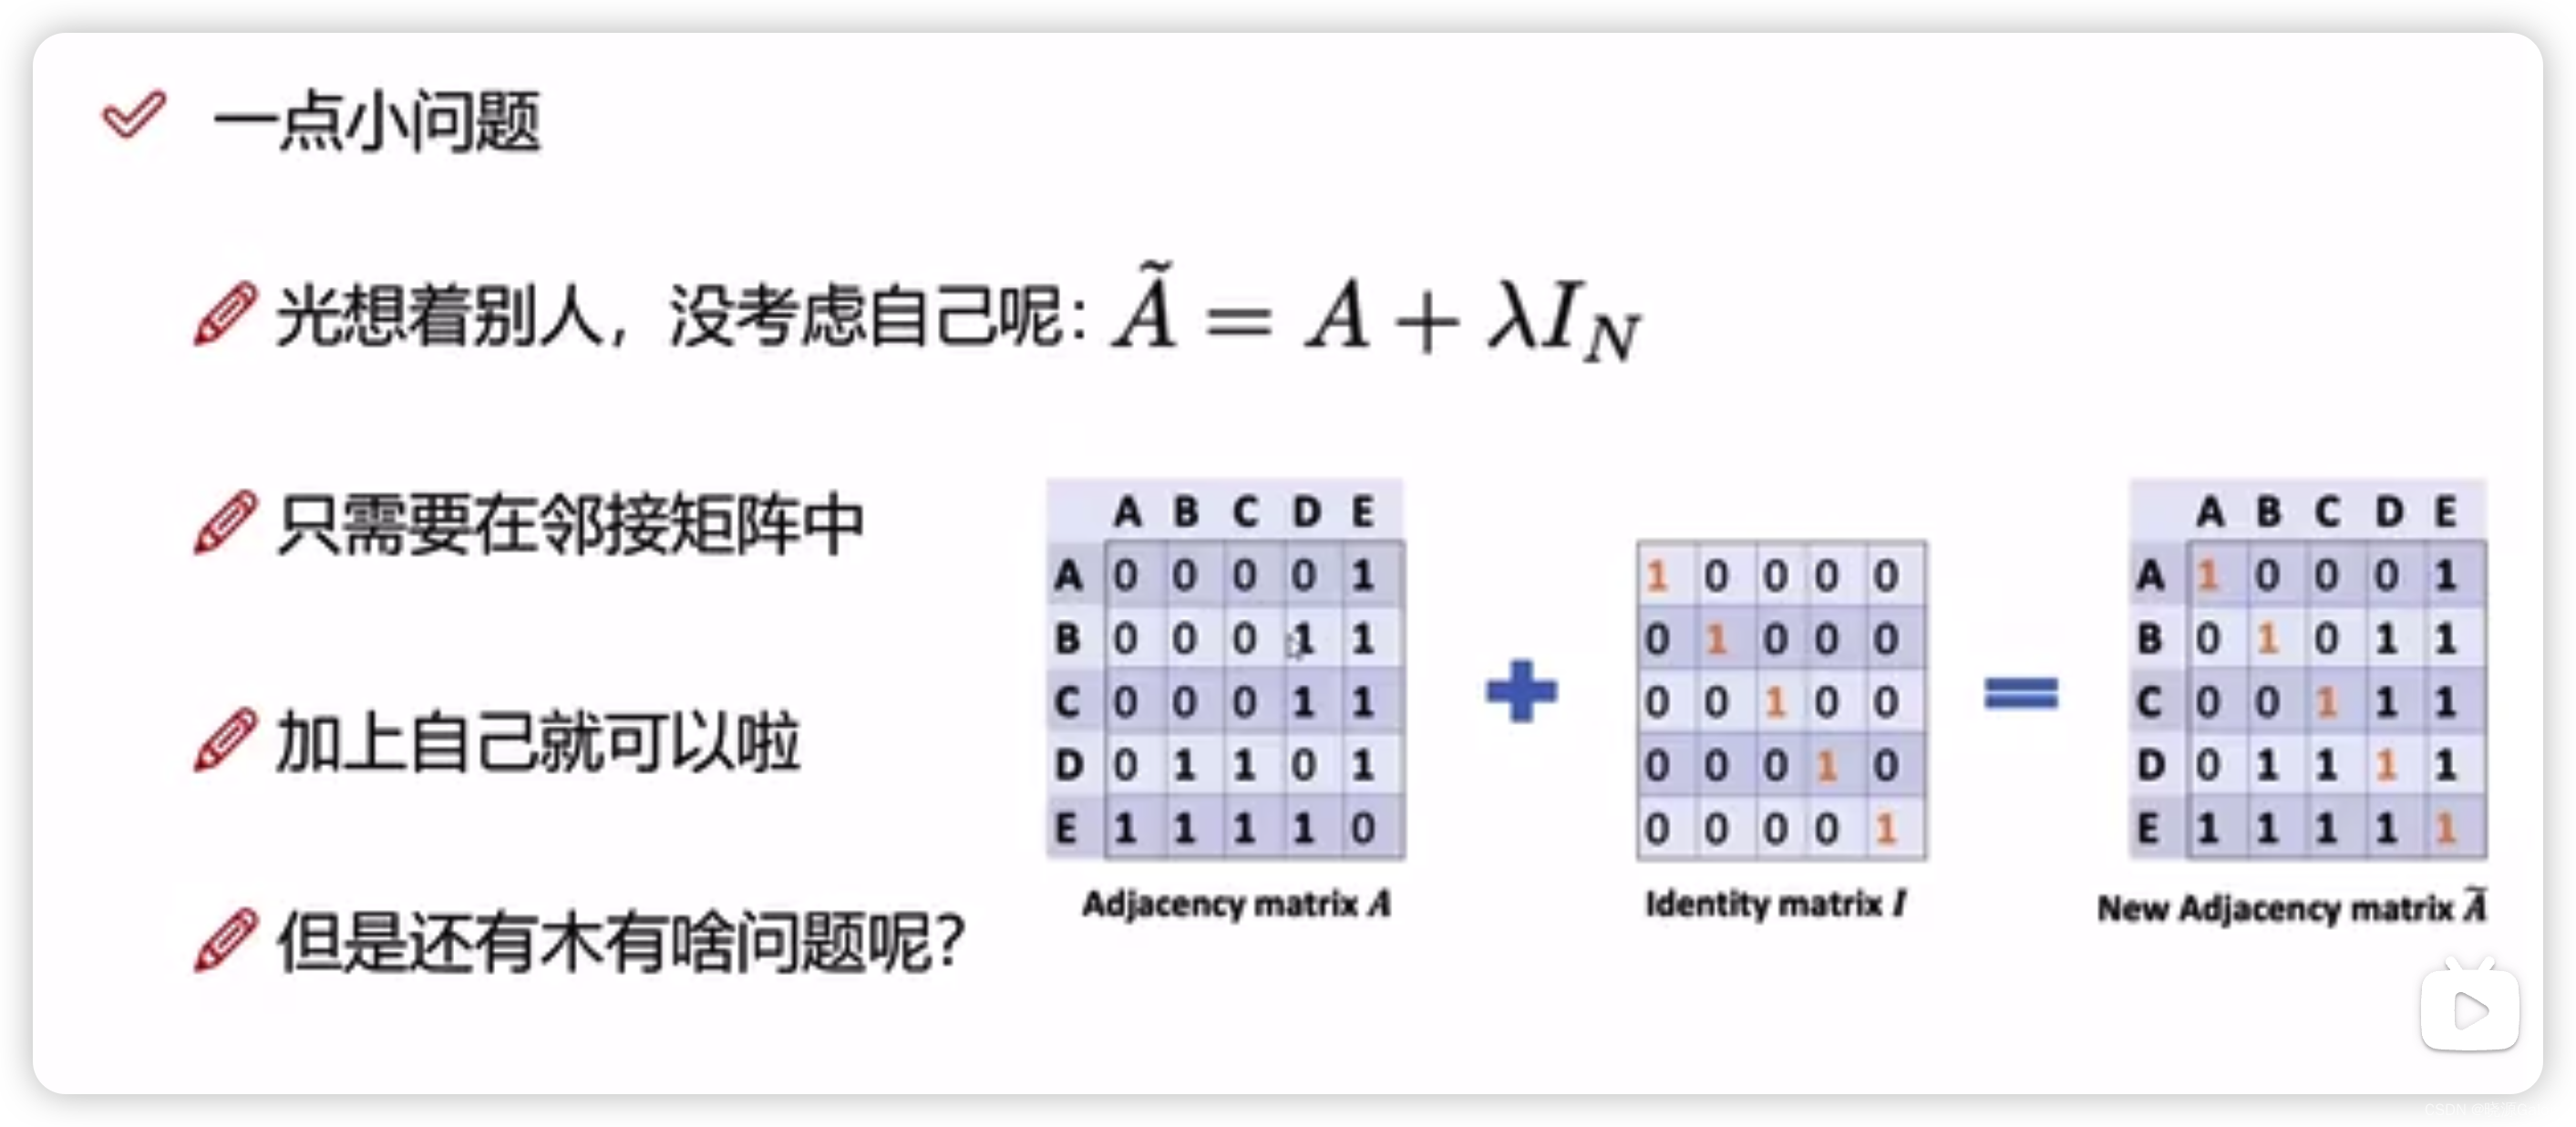
而这就相当于矩阵内同一个元素做了两次归一化,于是可以将度矩阵开个方(将对角矩阵开方是可以做到的)此时可以再邻接矩阵的基础上,再加上一个单位阵,从而使得最终的结果包含自身对整体的贡献。左乘度矩阵的逆只是对行向量做归一化。于是需要右乘上一个矩阵对列向量做归一化。由于邻接矩阵中一般不会(i,i)等于1,除非第i个点上有自环。而如果用邻接矩阵去乘上特征矩阵,那么将丢失自身向自身的贡献。也就是说需要再做一个
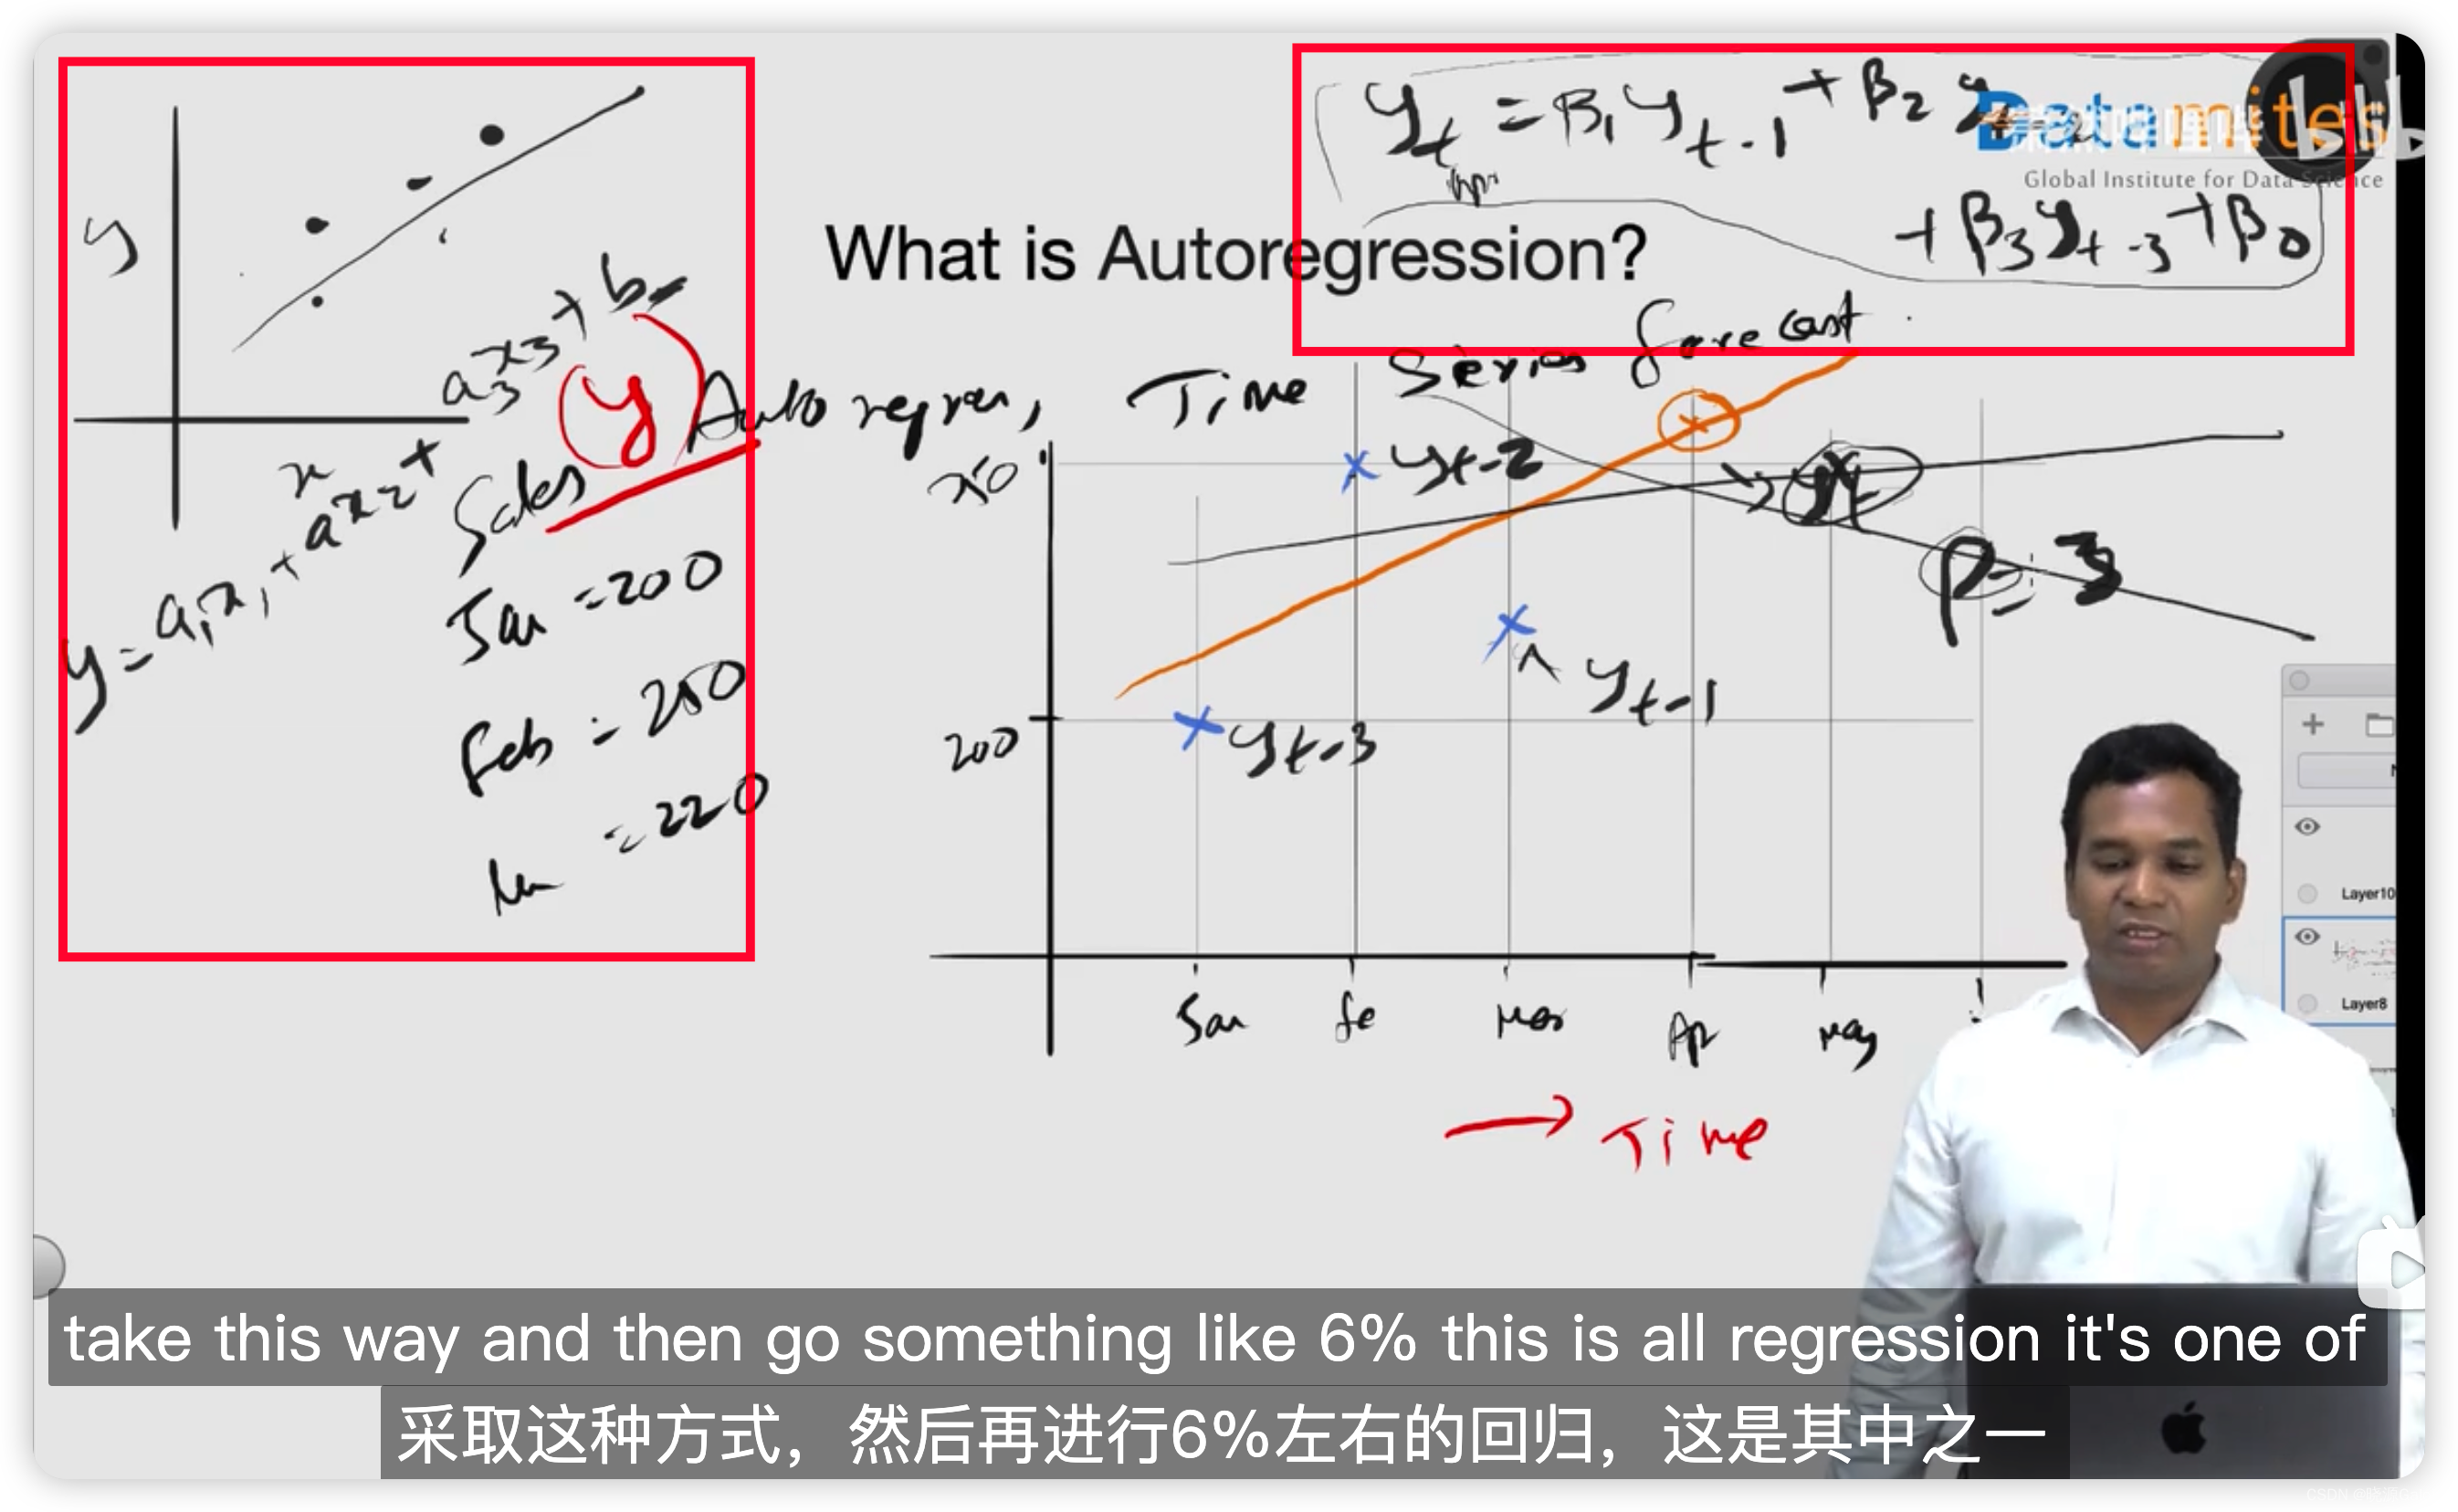
回归是用x去拟合出函数出来,而自回归是用之前的y去拟合出函数。