


- @AutoMQ


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
AutoMQ与Ververica达成战略合作,共同打造云原生实时数据流处理解决方案。AutoMQ提供高弹性、低成本的Kafka兼容流存储,Ververica则基于Apache Flink提供企业级流计算能力。双方集成将解决传统架构的资源利用率低、运维复杂等问题,实现毫秒级延迟、秒级弹性伸缩和高达90%的成本优化。该方案无需重构代码即可构建端到端实时数据管道,适用于金融风控、实时推荐等场景,助力企业
今天,我们正式宣布:继 S3 WAL、EBS/Regional EBS WAL[1] 之后,AutoMQ 将在 2025 年的 12 月的新版本中全面支持以 AWS FSx 作为新的 WAL 存储选项。AutoMQ 本身是一款完全兼容 Apache Kafka 协议、基于 S3 对象存储构建的新一代 Diskless Kafka,通过自研的「WAL + 对象存储」创新流存储引擎,将写入日志与大规模
通过引入 FSxN 作为 WAL,
我们非常荣幸地宣布,AutoMQ 与 Aklivity 正式达成战略合作伙伴关系!共同致力于推进云原生实时数据基础设施的演进,助力企业深度释放实时数据的核心价值。数字化转型全面加速,实时数据已成为商业创新与提升竞争力的核心。然而,传统的实时数据架构在多系统互联、数据安全保障以及成本控制等方面仍面临重重挑战。AutoMQ 的无状态云原生 Kafka 平台现已深度集成 Aklivity 的多协议网关技
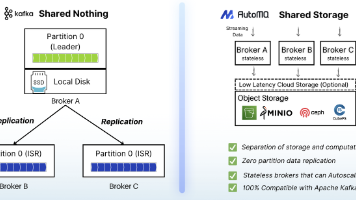
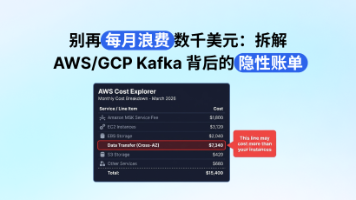
云上Kafka集群的跨可用区(AZ)流量费用可能占到总成本的50%以上,却常被忽视。AWS/GCP对跨AZ数据传输双向收费($0.02/GB),而Kafka的3副本架构必然产生大量跨AZ流量:Producer写入(2/3概率跨AZ)、Leader-Follower复制(确定性2GB/1GB写入)、Consumer读取(多组重复消费)。典型100MB/s生产集群月流量费可达$24,000,优化后仍需
Kafka 社区对共享存储的兴趣由来已久:如果所有数据都放在 S3 这样的共享存储上,Broker 就不需要本地磁盘,副本复制可以省掉,跨 AZ 流量费也随之消失。但对象存储的延迟一直让这个想法停留在"理论上很美"的阶段。AWS 最近发布的 S3 Files 改变了这个前提——它给 S3 加上了 NFS 文件系统接口,小文件读取延迟做到了亚毫秒级。于是一个老问题以新的面貌回来了:Kafka 能不能
RTO (Recovery Time Objective,恢复时间目标)。在分布式系统的语境下,RTO 并不是一个抽象的 SLA 数字,而是一个倒计时的秒表。它指的是从故障发生的那一刻起,到系统完全恢复服务能力所允许消耗的最长时间。对于运维团队来说,RTO 就是从“系统报警”到“业务止损”之间的生死时速。这一行看似微小的配置调整,成本极低,却能有效消除单节点故障下的客户端滞后,将 RTO 缩短约
360集团采用AutoMQ解决了Kafka冷读难题,显著提升了日志检索平台性能。AutoMQ的存算分离架构通过三条独立数据路径(写入、热数据消费、冷数据读取)实现冷热隔离,将生产P99延迟从10秒降至500毫秒,积压量减少40倍,同时节省50%硬件成本。评估测试验证了其毫秒级延迟、读写隔离和分钟级弹性扩容能力。生产部署采用K8s+对象存储方案,配备集群级故障切换机制,为360的日志平台提供了更高效
当前云厂商与开源软件之间的开源托管云服务的不公平竞争关系,在一定程度上可以类比为过去微软 Windows 操作系统上的 IE 浏览器与其他浏览器的关系。即使没有直接使用其他浏览器的代码,Windows 浏览器依然凭借其自定义的不公平规则和与操作系统的强绑定,垄断了 Windows 浏览器市场多年,打压了许多浏览器创新者,最后导致了劣币驱逐良币的局面。当现有的开源协议不能满足当前的云时代,面对云厂商
360集团采用AutoMQ解决了Kafka冷读难题,显著提升了日志检索平台性能。AutoMQ的存算分离架构通过三条独立数据路径(写入、热数据消费、冷数据读取)实现冷热隔离,将生产P99延迟从10秒降至500毫秒,积压量减少40倍,同时节省50%硬件成本。评估测试验证了其毫秒级延迟、读写隔离和分钟级弹性扩容能力。生产部署采用K8s+对象存储方案,配备集群级故障切换机制,为360的日志平台提供了更高效