- @AM_1867


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
用1台E1001+4台DGX Spark在桌面上组免高端交换机的大模型集群:4×1PFLOPS算力、512GB统一寻址内存,跑满血DeepSeek-R1,数据全程不出企业内网。含vLLM+Ray多机部署可复现实操与选型建议。

企业级大模型落地第一道坎——买 API 还是自己部署?本文不给口水结论,给可执行方法:把 TCO 拆成"调用量拐点公式 + 报价单外的隐性成本冰山",你代入自己的真实调用量,答案自己浮出来。含三条路线横向对比表、拐点计算四步法,以及厂商官方 TCO 口径(5年降私有云75%/公有云90%)。数值均标注官方出处,真机数据以实测为准。
大模型显存不是"参数量×2"就完了。本文给出权重、KV Cache、总需求三个可背公式,附一个零依赖可直接运行的 Python 计算脚本(支持 GQA、量化、并发、估算卡数)和主流尺寸速查表,并讲清三个最容易翻车的坑:MoE 按总参算、KV Cache 可能比权重大 3 倍、GB 与 GiB 差 7%。
本地部署有一类故障不崩溃、不报错、返回码是 0,唯独输出是坏的——通顺的英文句子里夹着一段乱码,扫一眼容易当成模型答得不好。这篇讲怎么定位:固定所有变量只动一个,把 offload 层数一路降到 0,纯 CPU 那档对了,问题就在加速器那条路径上。附一个零依赖脚本,按五类形态特征把可疑输出捞出来,不需要 GPU。
模型跑起来了、输出也对,就是慢——换更强的卡也没用,因为单请求解码卡住你的是内存带宽不是算力:每吐一个 token 都要把全部权重过一遍。理论上限 = 带宽 ÷ 权重大小,一个除法算完就知道该不该继续折腾。带宽自己就能推:位宽 × 等效频率 ÷ 8。附零依赖脚本 + 带宽档×模型规模速查表,另附一张比值判读表,帮你判断实测偏低到什么程度才值得查。文中 token/s 均为理论值非实测。
容器里 nproc 显示 72 核、free 显示 125 GiB,cgroup 实际只给了 8 核 16 GiB——这两个命令读的是宿主机。更少人知道的是内核为每类限额都备了触顶计数器:cpu.stat 记被掐停多少次,memory.events 记 OOM,pids.events 记 fork 被拒多少次。我这台机器 OOM 是 0,fork 被拒 2143 次,真凶就藏在那个没人打开的文件里
同一台机器,早上起服务等好几分钟,下午再起只要几秒,很多人第一反应是显卡有问题。我用 O_DIRECT 绕开 page cache 量了一遍:冷读 109.30 MiB/s,热读 4.35 GiB/s,差 40.7 倍。又扫了一遍块大小排除测法问题,128KiB 到 16MiB 只差 1.2 倍,说明瓶颈是链路本身。有了这个数,加载时间就是一个除法,7B 到 671B 我做成了速查表;另外讲清楚默
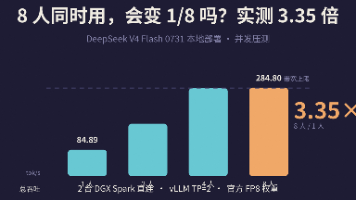
本地部署的大模型,8 个人同时用,速度会变成 1/8 吗?我在 2 台 DGX Spark跑 DeepSeek V4 Flash 0731 上实测:8 并发总吞吐 284.80 tok/s,是 1 并发84.89 的 3.35 倍。不是 1/8(不是分蛋糕),也不是 8 倍(带宽有上限)。decode 是内存带宽 bound,加并发把闲置带宽用上了,所以整体反而更快;过了拐点(≈带宽/单流=3.3
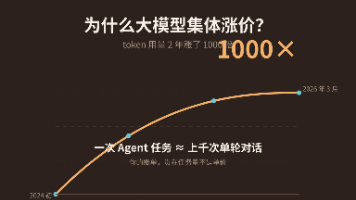
DeepSeek 8 月 6 日拟整体上调 API 定价,但这一轮是集体涨价:Kimi 输出价已到100 元每百万 token,智谱套餐最高涨超 260%。背后是全国日均 token 调用量两年从约 1000 亿涨到 140 万亿,涨了 1000 倍。而你的账单大头往往不是单价,是任务量——一次 Agent 任务等于上千次单轮对话。附零依赖速算工具 + 国产模型定价速查表,算清你的账单贵在哪。(1
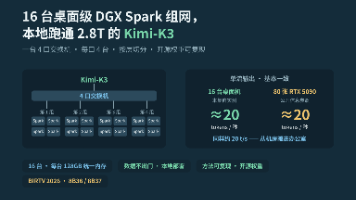
大模型本地部署主流靠堆几十张显卡。我们走了另一条路:用 16 台桌面级 DGX Spark、一台4 口交换机组网,把约 2.8T 总参的开源模型 Kimi-K3 在本地跑通,按层切分到 16 台协同推理,单流输出约 20 tokens/s——与公开信息里 80 张 RTX 5090 的结果基本一致。本文摊开硬件、组网方式、模型切分与实测,并给出一份可复现清单:4 口交换机 + 16 台 + 开源权