
16 台 DGX Spark 组网本地跑通 2.8T 的 Kimi-K3:一台 4 口交换机的组网方法与实测
大模型本地部署,主流做法是堆显卡——一张不够就几十张,然后配机柜、电源、散热、专门的机房。参数量越大,这条路越重。
我们试了另一条路:用 16 台桌面级的 DGX Spark 组网,在本地把约 2.8T 总参的 Kimi-K3 跑了起来。 一台 4 口交换机、16 台设备、公开的开源权重——这套组合任何人都能照着搭。这篇把硬件、组网方式、模型怎么切、以及实测吞吐一起摊开讲清楚,最后给一份可复现清单。
先声明口径:下文的实测数字是我们自己这一组集群的记录,仅代表该环境与该模型版本,不是行业基准;对照用的公开信息也已标注来源。看方法和量级,别当成放之四海皆准的绝对值。
一、这套方案长什么样
先看硬件构成,很简单:
- 算力节点:16 台 DGX Spark。每台是 NVIDIA GB10 Grace Blackwell 平台、128GB 统一内存(CPU 与 GPU 共享同一块内存)、桌面级体积、单台功耗在两百多瓦量级。16 台摞在办公室一角也不占地方。
- 组网:一台 4 口交换机,每个口接 4 台,4 个口一共 16 台。 没有用什么专用高端交换设备,就是一台普通的多口交换机把它们连成一体。
组网拓扑一张图就说清了:
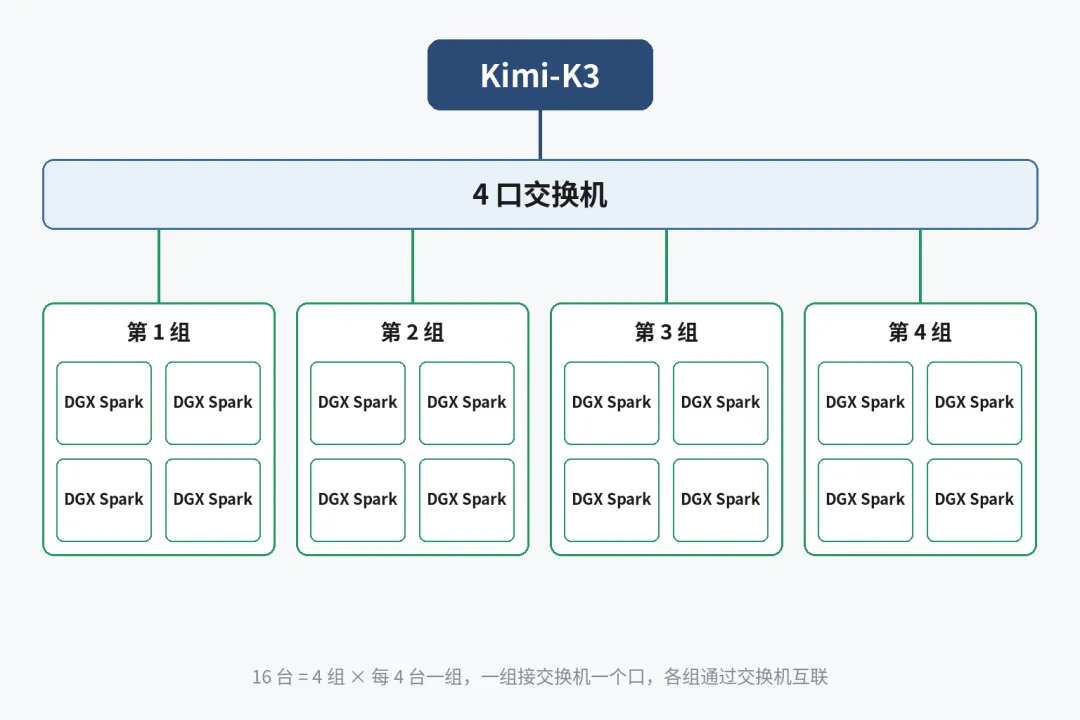
16 台 = 4 组 × 每组 4 台,一组接交换机的一个口,各组之间通过这台交换机互联。节点之间走高速以太网(监控面板里那列 RoCE 就是),推理时层与层之间要传递中间结果,节点间的通信质量直接影响整体吞吐——这是这类组网方案的关键,后面复现清单里会再强调。
二、一个 2.8T 的模型,怎么切到 16 台上
Kimi-K3 是月之暗面开源的 MoE(混合专家)模型,约 2.8T 总参。这个量级的权重,放在单台设备上是跑不动的——所以核心问题是怎么把一个模型拆开、分到 16 台机器上协同跑。
我们用的是按层切分:把模型的各层分配到不同的节点上,每台负责其中一段,前一段算完把中间结果传给下一段,最后拼成一次完整的推理。对外看,就像一台大机器在连续回答问题;实际上是 16 台在流水线式地接力。可以把它想成一支团队分头干活,每人负责一段工序,合起来完成整件事。
这套组网跑起来长什么样,监控面板最直观(主机名与内网 IP 已按安全规范打码):
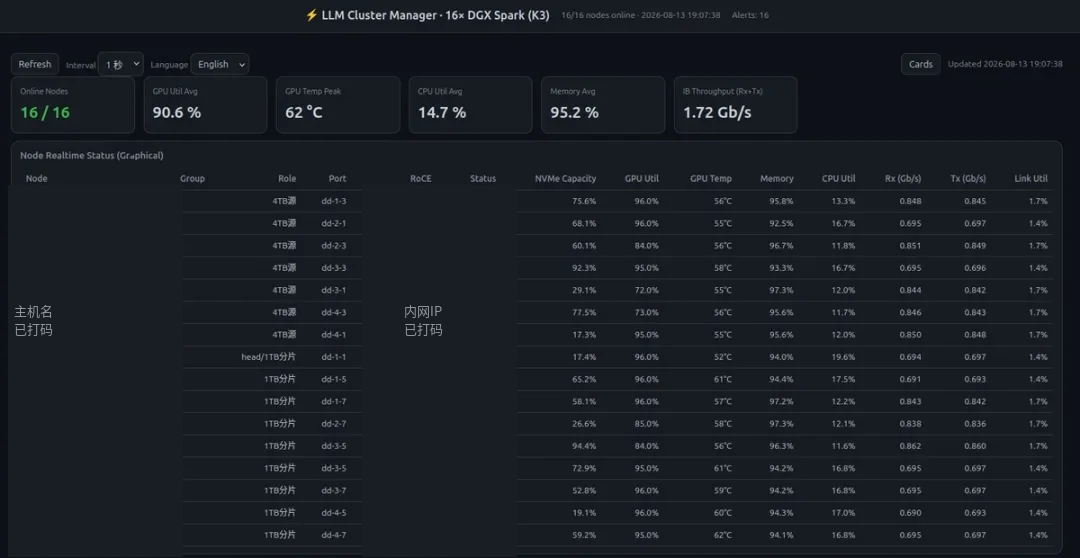
16 个节点全部在线、各自的算力占用和网络吞吐实时在刷——这是一套日常在跑的部署,不是测完就拆的样机。
三、实测:单流输出约 20 tokens/s
跑通只是第一步,能不能用、快不快,得看实测。我们记录了一组数字:
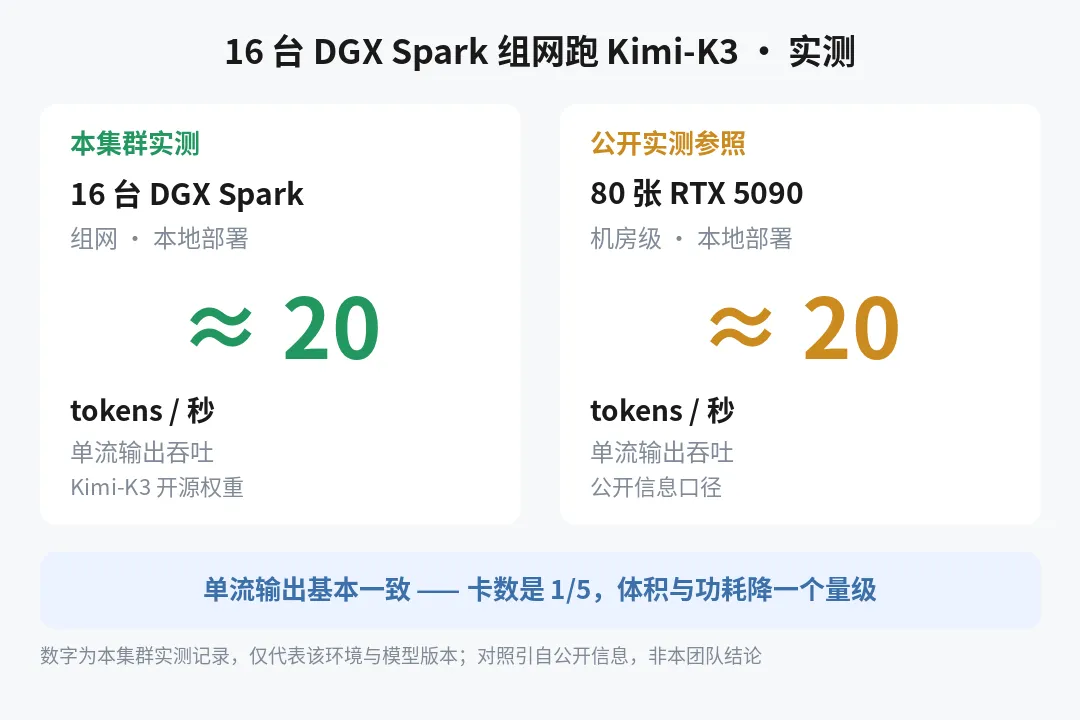
在 16 台 DGX Spark 组网下,Kimi-K3 单流输出约 20 tokens/s。
这是什么水平?给一个公开信息里的参照:有人用 80 张 RTX 5090 本地跑通 Kimi-K3,单流输出也是约 20 tokens/s,和我们这组的结果基本一致。
需要说清楚的是:这只是「单流输出」这一个指标下的对照,不构成「谁比谁强」的结论。 两种方案侧重点不同——80 张显卡在大并发、大规模服务的场景下有它的位置。我们想说明的是另一件事:当模型大到需要几十张专业卡才能跑时,用一组桌面级设备组网,也可以是一个认真考虑的选项。同样约 20 tokens/s 的单流吞吐,设备从一整套机房级系统,变成了摞在办公室的十几台桌面机,体积和功耗降了一个量级,部署地点从机房挪到了工位旁边。
(对照卡底部那句免责——「数字为本集群实测记录,仅代表该环境与模型版本;对照引自公开信息,非本团队结论」——是有意保留的,实测和公开参照的边界得划清楚。)
四、为什么这条路值得看:算力的「落地形态」
对大多数团队来说,用 80 张显卡跑模型,意味着要建机房、要养运维、要付一大笔电费和空间成本。这些不是技术问题,是落地问题。
「能跑大模型」的算力,正在从机房往桌面走;而 16 台组网,又把这个能力从「桌面跑小模型」扩到了「桌面也能跑大模型」。这条路的价值集中在应用层:
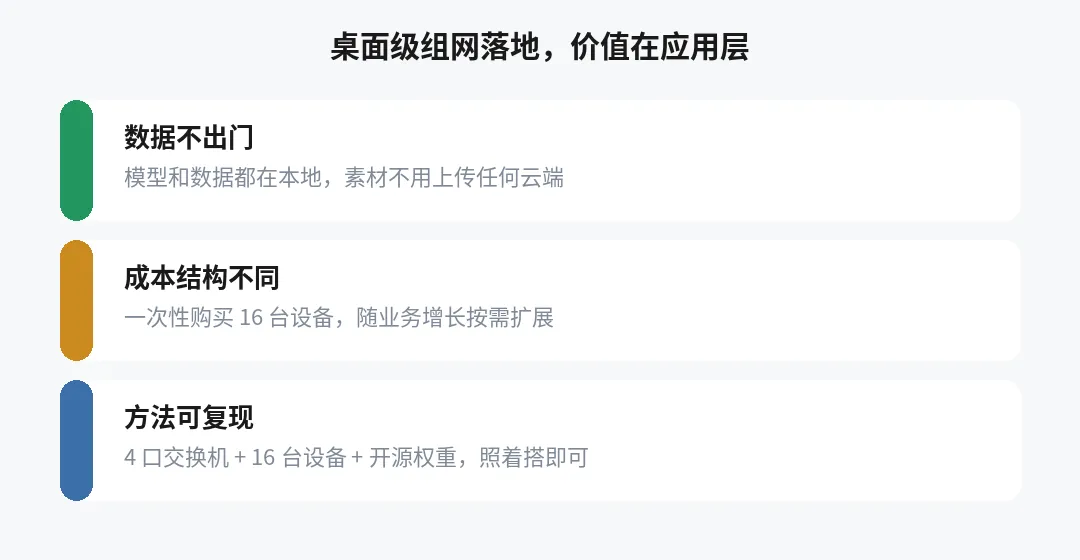
- 数据不出门:模型和数据都在本地,素材不用上传到任何云端。对内容团队、品牌方、以及有合规要求的场景,这是硬需求。
- 成本结构不同:显卡方案是几十张卡的采购加机房投入;桌面级组网是一次性购买十几台设备,随业务增长按需加节点。这里说的是成本结构的差别,划不划算取决于你的规模和用量,得自己算。
- 方法可复现:一台 4 口交换机、16 台设备、公开的开源权重——不是黑箱,任何人都可以照着搭、自己验证。
五、想照着搭?一份可复现清单
这套方案最值钱的一点是它不神秘。如果你也想试,几个要点:
- 算力节点:DGX Spark 这类带大容量统一内存的桌面级设备,数量按你要跑的模型规模定。统一内存是关键——大模型权重按层分摊下去,靠的是每台那块能被 GPU 直接用的大内存。
- 组网:一台多口交换机做星型互联即可,不必上专用高端交换设备。重点在节点间的通信质量:按层切分时,层与层的中间结果要在节点间传递,网络的带宽和延迟会直接压住吞吐上限——组网这一环省不得。
- 模型切分:按层切分,把模型的层均匀分配到各节点,注意负载均衡(别让某几台成为瓶颈)。切分方案和节点数、模型结构相关,需要按你的模型调。
- 模型权重:用开源权重(Kimi-K3 的权重是公开的),这样整套链路才是可复现、可自查的。
- 先压单流、再压并发:先把单流吞吐调稳,再看多路并发下的表现——两种压力对组网和调度的要求不一样。
这几步里,最容易被低估的是第 2 条:很多人把注意力放在「凑够算力」,却忽略了节点间通信才是组网推理的隐形瓶颈。算力堆够了,网络跟不上,一样卡。
六、现场:BIRTV 2026
这套 16 台 DGX Spark 组网跑 Kimi-K3 的方案,我们(芯途异构,与影视系统集成商华汇蓝海联展)作为全球首发带到了 BIRTV 2026 现场:
- 时间:2026 年 8 月 19 日 ~ 22 日
- 地点:中国国际展览中心(朝阳馆)
- 展位:8B36 / 8B37
现场有真机、有实测演示。感兴趣的可以去看看这十几台桌面机是怎么把一个 2.8T 的模型跑起来的。
七、小结与一个留给你的问题
- 大模型本地部署不止「堆显卡」一条路:16 台桌面级 DGX Spark、一台 4 口交换机、按层切分,本地跑通了约 2.8T 的 Kimi-K3;
- 实测单流约 20 tokens/s,与公开信息里 80 张 RTX 5090 的结果基本一致——这不是谁比谁强,是同一个结果换了一种落地形态:从机房搬到办公室,体积功耗降一个量级;
- 这套方法可复现,最容易被低估的坑是节点间通信,不是算力本身;
- 它的价值在应用层:数据不出门、成本结构不同、方法可自查。
最后留个问题给你按自己处境判断:如果你的团队要在本地跑一个几十张卡量级的大模型,你更在意的是「把峰值吞吐拉到最高」,还是「让这套算力能摆进办公室、数据不出门」? 这两个目标指向的方案,往往不是同一套。
数据说明:本文实测(单流约 20 tokens/s)为我们自己这一组 16 台 DGX Spark 集群的记录,仅代表该环境与该模型版本;80 张 RTX 5090 的对照引自公开信息,非本团队结论。配图中监控面板的主机名与内网 IP 已打码。
更多推荐


 9
 0
- 0


 已为社区贡献18条内容

所有评论(0)