- @2501_93731676


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本文介绍了基于Torchaudio库的WAV2VEC2_ASR_BASE_960H模型实现语音特征提取和转文本的完整流程。首先在Bitahub平台创建开发环境,然后详细讲解了数据处理、模型加载、特征提取和可视化等关键步骤。通过调整音频采样率、提取Transformer层特征,并使用贪心解码算法将语音转换为文本。实验成功实现了语音到文本的转换,展示了深度学习在语音处理领域的应用潜力。该方法可广泛应用
本项目基于LLaMAFactory框架,在BitaHub平台上对GLM-4-9B-Chat模型进行LoRA微调,旨在提升广告文案生成能力。通过配置开发环境、添加数据集信息、执行训练命令,使用单卡GPU在1小时内完成训练。训练后进行模型合并,并利用dev数据集测试效果。结果显示,模型能有效实现风格迁移,将商品属性转化为特色文案。后续可考虑使用vllm框架进行部署应用。整个过程验证了LoRA微调方法对

本项目基于Unsloth库在BitaHub平台上对gemma-3-4b-it模型进行微调,以提升其在编程任务和通用对话中的表现。具体包括:1)在Bitahub创建项目环境;2)安装必要库并加载4位量化模型;3)配置PEFT参数进行高效微调;4)处理10万条FineTome数据集并应用聊天模板;5)使用SFTTrainer进行监督微调训练;6)验证模型推理效果。项目实现了模型在代码生成和数学推理等任
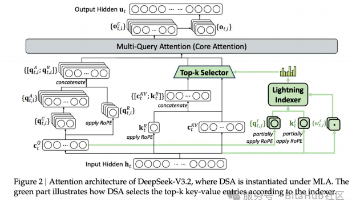
DeepSeek-V3.2系列模型通过三大核心技术突破实现高效推理与智能体支持:1)创新的DeepSeek稀疏注意力(DSA)将长上下文处理复杂度从O(L²)降至近线性,降低50%推理成本;2)超大规模GRPO强化学习投入预训练10%以上算力,通过专家蒸馏策略提升数学、代码等专业领域能力;3)原生智能体协议集成"思考模式",保持工具调用间的推理连续性。在AIME、IMO等顶级测
本文介绍了阿里云Wan2.1文本到视频生成模型的部署和使用教程。主要内容包括:1)环境配置和模型下载;2)运行文本到视频生成的核心参数设置;3)提示词扩展功能的使用。文章重点讲解了轻量级T2V-1.3B版本的操作流程,并提供了优化生成效果的实用技巧。该模型适合轻量化短视频创作,但复杂场景效果仍有提升空间。教程为开发者提供了从环境搭建到参数调优的完整指导方案。

摘要:本教程展示了在BitaHub平台上对Meta的SegmentAnythingModel2(SAM2)进行医学图像微调的全流程。以胸部CT分割为例,详细介绍了从环境配置、数据预处理到模型微调和推理的完整步骤。通过加载预训练模型、创建数据集、定义数据清洗函数,并采用随机采样提示点策略,实现了对SAM2的定制化微调。实验结果显示,经过3000次迭代训练后,模型在测试集上达到了约70%的IoU准确率
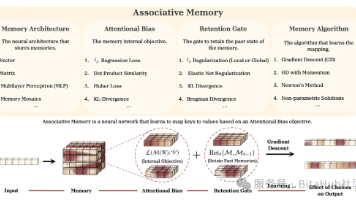
各位 AI 开发者与研究者们,大家好!Google Research 近期提出了两项突破性工作——与,试图为序列模型赋予真正可用的长期记忆,同时保持训练的高并行度与推理的高效率。这不只是对现有技术的小修小补,而是一次对底层建模范式的重塑。当前主流架构在处理长上下文时均面临典型的“两难”局面:① Transformer:强大但太贵依赖注意力机制,可实现强能力的。。即使有 FlashAttention
DeepSeek-V3.2系列模型通过三大核心技术突破实现高效推理与智能体支持:1)创新的DeepSeek稀疏注意力(DSA)将长上下文处理复杂度从O(L²)降至近线性,降低50%推理成本;2)超大规模GRPO强化学习投入预训练10%以上算力,通过专家蒸馏策略提升数学、代码等专业领域能力;3)原生智能体协议集成"思考模式",保持工具调用间的推理连续性。在AIME、IMO等顶级测
本项目基于Unsloth库在BitaHub平台上对gemma-3-4b-it模型进行微调,以提升其在编程任务和通用对话中的表现。具体包括:1)在Bitahub创建项目环境;2)安装必要库并加载4位量化模型;3)配置PEFT参数进行高效微调;4)处理10万条FineTome数据集并应用聊天模板;5)使用SFTTrainer进行监督微调训练;6)验证模型推理效果。项目实现了模型在代码生成和数学推理等任
本项目基于Qwen2-VL多模态大模型,在BitaHub平台上实现数学公式图像到LaTeX代码的智能转换。采用4-bit量化和LoRA技术进行高效微调,使用LaTeX_OCR数据集,通过SFTTrainer完成模型训练。该方案解决了传统OCR处理数学符号的难题,可提升学术文档的公式编辑效率。测试表明模型能准确识别复杂公式并生成对应LaTeX代码,为科研教育领域提供了实用的公式解析工具。