


- @2501_90236157


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
机器学习主要包含三大任务:回归分析(预测连续值)、分类(多类别选择)和结构化学习(处理复杂关联数据)。构建预测模型的三个关键步骤为:1)建立初始假设函数;2)通过损失函数评估参数优劣;3)使用优化算法(如梯度下降)最小化损失函数。其中,梯度下降通过计算偏导数调整参数,寻找损失函数的局部或全局最优解。整个过程从假设模型出发,经参数优化最终实现最佳拟合。
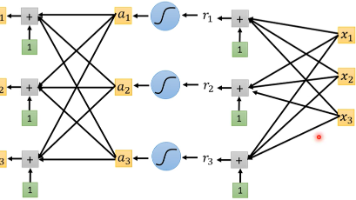
摘要:本文探讨了将分类问题转化为回归问题的方法。通过使用one-hot向量表示类别,并扩展回归输出为多组数值,可以解决分类任务。重点介绍了softmax函数将输出转化为概率分布的原理,并比较了其在二分类时与sigmoid函数的等价性。文章强调交叉熵损失函数比均方误差(MSE)更适合分类任务,因其能避免梯度消失问题,确保模型有效训练。通过实例展示了交叉熵在优化过程中的优势,建议在分类模型中使用交叉熵
Batch Normalization(BN)通过标准化网络各层的输入数据分布,有效缓解了误差曲面崎岖导致的训练困难问题。在训练阶段,BN对每个mini-batch计算均值和方差进行标准化,并引入可学习的γ和β参数保持模型表达能力。测试时采用滑动平均统计量替代实时计算。其核心价值在于:1)通过特征归一化使不同维度的梯度变化更均衡;2)缓解内部协变量偏移问题,确保前层参数更新不会破坏后层已学习到的特

本文介绍了如何使用PyTorch的TensorBoard工具记录和可视化训练数据。首先需要激活PyTorch环境并导入SummaryWriter类,创建日志目录。通过循环调用add_scalar方法记录标量数据(如y=2x函数值),指定标签、数值和步数参数。最后关闭Writer并运行TensorBoard命令查看可视化结果。若遇到模块缺失错误,建议降低setuptools版本至65.5.0。整个过
dropout将一些输出项随机置0来控制模型复杂度常作用在多层感知机的隐藏层输出上丢弃概率p是控制模型复杂度的超参数。
AlexNet比LeNet更深更打来得到更好的精度,那能不能更深和更大?
本文从两个核心原则出发重新思考卷积神经网络设计。首先阐述平移不变性和局部性原则的重要性:前者要求系统对输入位置变化保持稳定,后者强调模型应聚焦局部区域而非全局信息。基于此,作者分析了全连接层的局限性,提出将其权重转换为四维张量以实现空间信息保留。通过约束权重不受输出位置影响(V_i,j,a,b=V_a,b)实现平移不变性,引入邻域限制(Δ范围外权重置零)满足局部性,最终将全连接层转化为卷积层,证明
本文介绍了在Anaconda中创建虚拟环境并安装库的方法。首先通过Anaconda Prompt或Navigator创建新环境(如dllearn_env),然后激活该环境。接着使用pip命令安装所需库(如numpy),可通过清华镜像源加速下载。成功安装后,可用pip list查看已安装的库。这种方法能有效隔离不同项目的依赖环境,便于管理。

Batch Normalization(BN)通过标准化网络各层的输入数据分布,有效缓解了误差曲面崎岖导致的训练困难问题。在训练阶段,BN对每个mini-batch计算均值和方差进行标准化,并引入可学习的γ和β参数保持模型表达能力。测试时采用滑动平均统计量替代实时计算。其核心价值在于:1)通过特征归一化使不同维度的梯度变化更均衡;2)缓解内部协变量偏移问题,确保前层参数更新不会破坏后层已学习到的特
本文介绍了在Anaconda中创建虚拟环境并安装库的方法。首先通过Anaconda Prompt或Navigator创建新环境(如dllearn_env),然后激活该环境。接着使用pip命令安装所需库(如numpy),可通过清华镜像源加速下载。成功安装后,可用pip list查看已安装的库。这种方法能有效隔离不同项目的依赖环境,便于管理。