
机器学习class2——loss可能导致类神经网络训练不起来
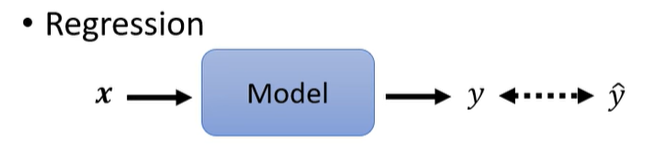
在我们已知regression的情况下,可以把classification当作regression来做
要把数字变成类别
当我们在做分类问题的时候,比较常见的做法是把我们的class用one-hot vector来表示
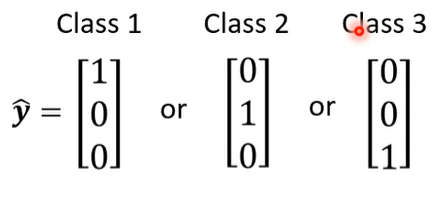
使用这样的方式,就可以避免出现类之间的关系紊乱的情况
由于我们之前做的一直是regression的问题,输出的是一个数值(如下图所示)
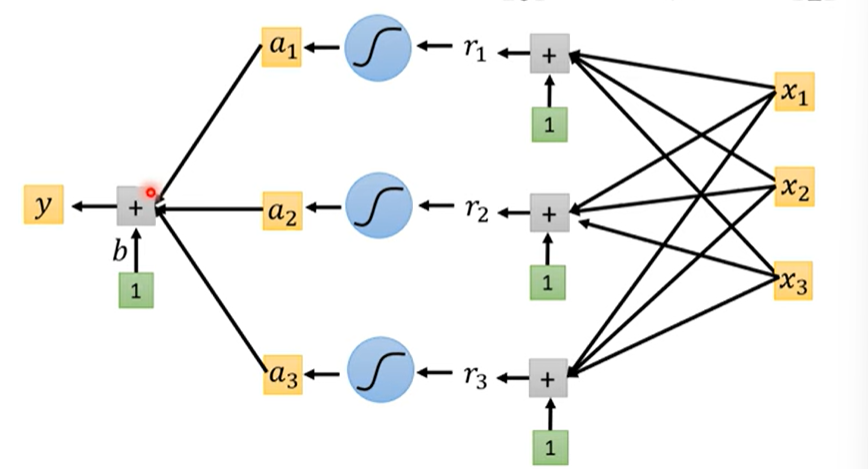
那这里有三个class,我们要如何改成三个输出呢?
我们只需要将原来输出一个数值的方法重复三次,就可以得到输出三组数值
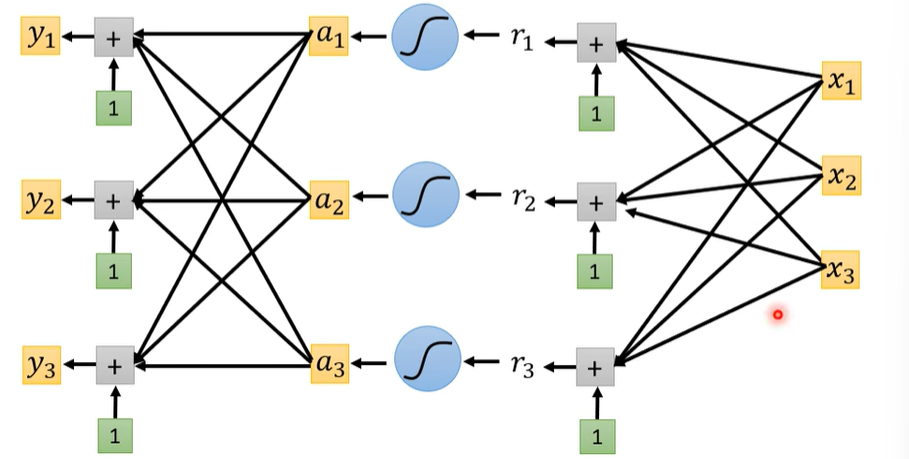
在我们计算regression的时候,直接将计算出来y与y_hat进行比较,但是在classification中,计算出来的y是一个向量,因此我们不能直接将classification中计算得到的y与y_hat进行比较,而是需要让y通过一个softmax function,得到y'再与y_hat进行比较
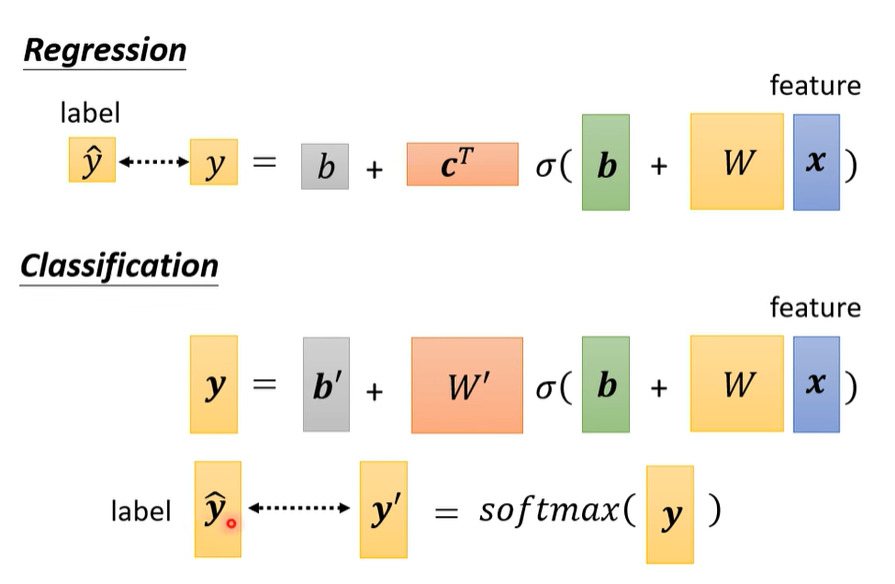
soft-max函数具体如下:
其中且
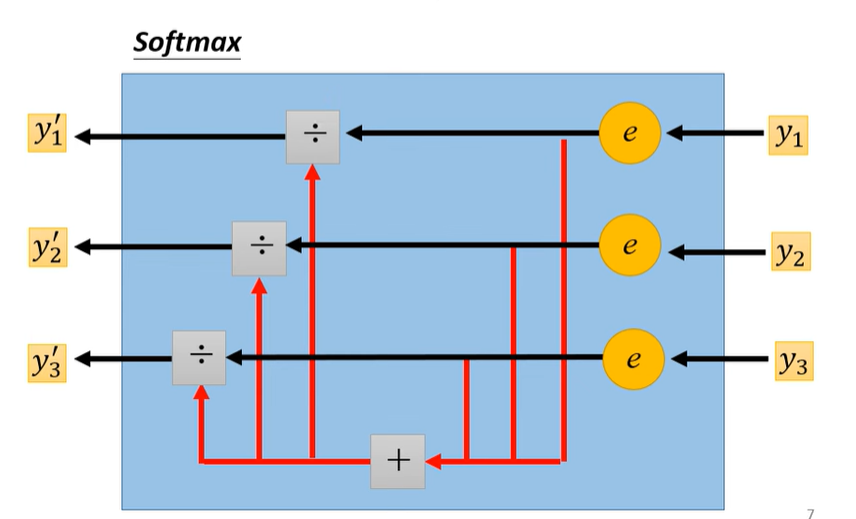
Softmax 函数的作用是将一组任意实数 y_i转换为一个概率分布。在计算过程中,每个 y_i先通过指数函数进行变换,使得所有结果都变为正数。随后再除以所有指数值的总和,从而实现归一化处理。经过这种转换后,每个输出值(y_i)' 都位于0到1之间,并且所有输出值的总和等于1,因此可以将其理解为各类别对应的概率。
当只有两个y的时候,同样可以使用softmax,但是更常见的是使用sigmoid(其实当只有两个y的时候,softmax就等于sigmoid了,具体推导如下)。
假设只有两个值y_1,y_2
上下同时除以e^{y_1},则可以得到
这就是sigmoid函式。
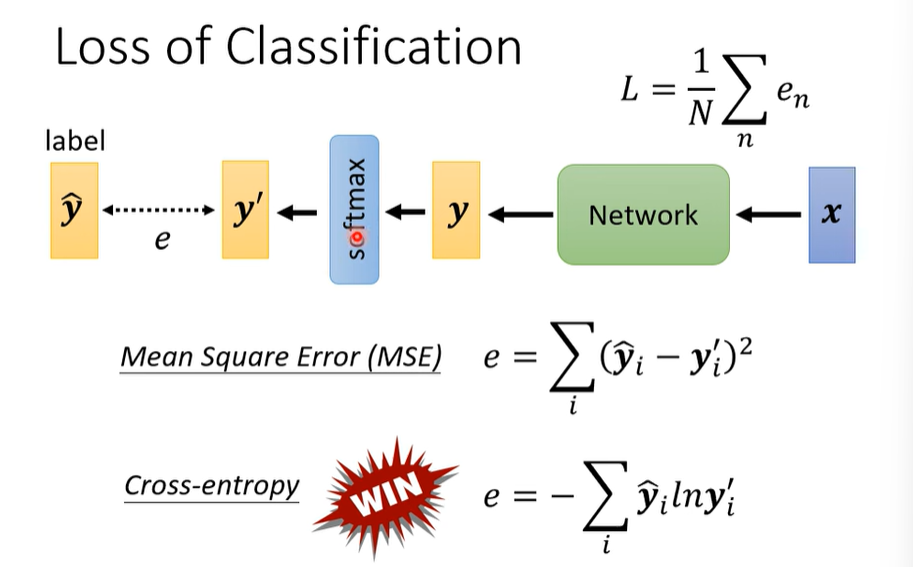
我们前面已经讲过loss函数的求解方法:
这里的e是指预测值与真实值的误差,在前文中讲到过MSE和MAE这两种求解方式,但是有一个更常用的,更适合用在分类任务上的做法——cross-entropy(交叉熵)
minimizing cross-entropy,通过训练模型,使交叉熵损失函数的值尽可能的小
在pytorch中,cross-entropy和softmax是被绑在一起的,这更足以证明cross-entropy适合用在分类任务上
下面用一个实例来说明cross-entropy比MSE更适合
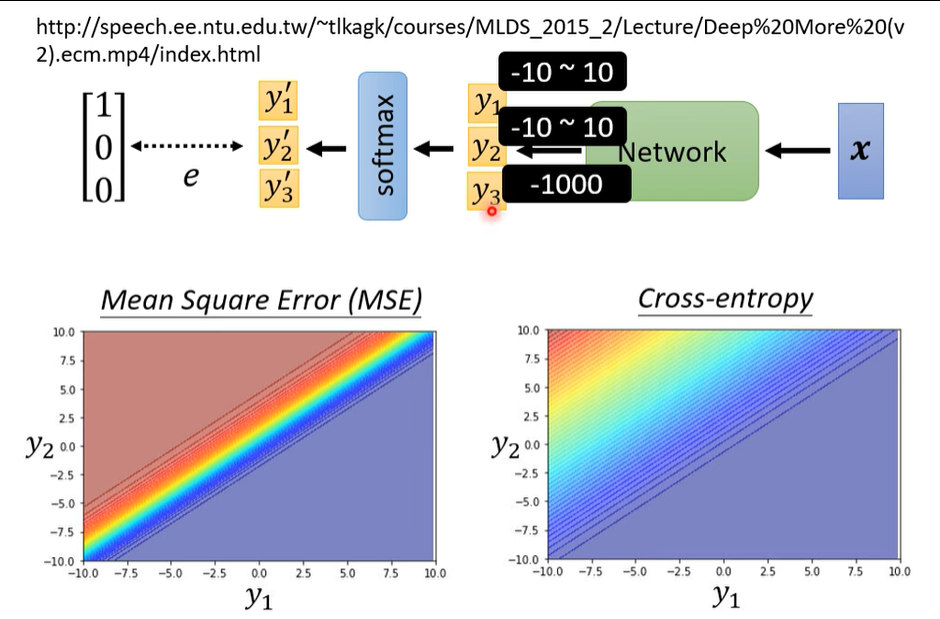
上示来两个图表示在不同情况下y_1与y_2对loss值的影响(红色表示loss大,蓝色表示loss小,目标要走到小,即右下角的蓝色区域)
在使用MSE时,如果我们初始就在loss比较大的地方(左图左上角),那么由于这一块没有斜率or gradiant descent很小,他没有办法走下去,会被卡住。但是在使用cross-entropy的时候就不会出现这样的情况,因为他始终是有斜率的。
所以说,当我们在训练分类模型的时候,如果使用了MSE,那么有很大的可能时训练不起来的,用Adam+MSE会更容易训练起来,但是训练结果可能不够好或者收敛速度很慢。此时,cross-entropy就成为了更好的选择。
更多推荐


 13
 0
- 0


 已为社区贡献3条内容

所有评论(0)