


- @2401_83600008


简介
林间藏好物,码间藏星光 专注分享优质网站、开源项目、小众工具、模型算法 安静攒资源,慢慢变厉害•͈ᴗ⁃͈ ✧
擅长的技术栈
可提供的服务
暂无可提供的服务
本文将从全栈视角出发:首先说清楚 Mock 是什么、为什么用,然后横向对比前后端 Mock 的本质差异与各自工具链,再纵向落地到 Vue 3 + Vite 项目中进行实战演练,最后补充后端的 Mock 示例作为扩展阅读。读完这篇,应能独立完成前端联调,也能看懂后端同事写的 @Mock 单元测试代码。
深度学习入门需要扎实的数学、编程和机器学习基础。数学方面需掌握线性代数(张量运算)、微积分(梯度下降)和概率统计(交叉熵);编程需熟练Python、NumPy和数据处理工具;机器学习要理解数据集划分、过拟合等概念。硬件上入门级电脑即可,推荐使用PyTorch框架和Anaconda环境管理。最重要的是保持实践导向的学习心态,从小项目入手逐步深入。掌握这些预备知识能有效避免80%的入门困难,为后续学习
本文介绍了深度学习中最基础的线性神经网络模型,包括线性回归和softmax回归。线性回归用于预测连续值(如房价),通过最小化平方损失函数来优化模型参数;softmax回归用于分类问题(如图像识别),通过交叉熵损失函数将输出转化为概率分布。文章详细讲解了从零实现和框架简洁实现两种方式,并强调了矢量化计算的重要性。此外,还介绍了Fashion-MNIST数据集的应用,以及softmax运算中的数值稳定

本文介绍了多层感知机(MLP)的基本原理和实现方法。MLP通过添加隐藏层和激活函数,解决了单层神经网络无法处理非线性关系的局限性。文章详细讲解了ReLU等激活函数的作用,并对比了从零实现和PyTorch简洁实现两种方式。针对过拟合问题,重点介绍了权重衰减和Dropout两种正则化技术。最后通过Kaggle房价预测项目,展示了完整的MLP应用流程,包括数据预处理、模型训练和评估等环节。文章还讨论了梯

本文系统介绍了深度学习中的核心组件与工具,包括层、块、参数管理和GPU加速。主要内容包括:1)层与块的概念,如何自定义块和嵌套块;2)参数访问、初始化和绑定方法;3)延后初始化的优势;4)自定义层的实现;5)模型参数的保存与加载;6)GPU加速的使用技巧。文章采用电脑硬件组装的比喻,帮助读者理解深度学习模型的构建过程,从基础使用进阶到高级定制,为后续学习更复杂的神经网络模型奠定基础。

本文介绍了现代卷积神经网络(CNN)从AlexNet到VGG的发展历程,重点分析了AlexNet的创新之处及其对深度学习的重要影响。文章首先指出LeNet在处理复杂图像时的局限性,随后详细阐述了AlexNet的关键改进:更深的网络结构、ReLU激活函数的使用、GPU加速训练以及Dropout防止过拟合。通过对比表格和结构示意图,展示了AlexNet如何通过多层卷积和池化操作逐步提取图像特征,最终实
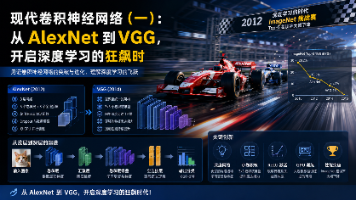
本文系统介绍了神经网络的学习机制与关键组件。
一、选择题 15 道,每题 2 分,共 30 分二、理论题 4 道,每题 8 分,共 32 分三、程序题 3 道,每题 8 分,共 24 分四、综合题 1 道,14 分(分 3 小问:6 分、4 分、4 分)
hadoop 集群,负责资源的管理和调度组件HDFS 操作:使用 hadoop fs 命令查看文件(查看文件名称、文件的大小等)Hive 中数据的存储格式,了解每一种存储格式的适合存储什么样的类型的数据Linux 中权限的设置,如:使用命令给目录或文件赋予可读可写的权限SSH 生成免密登录使用的密钥MapReduce 过程中,map 阶段、reducer 阶段,采用技术 shuffle 的作用是什
从map输出开始,传送map输出到Reduce作为输入的过程,对同一个map中输出的键相同的数据先进行整合,减少传输的数据量,并将数据按键排序。NameNode层面:DataNode向NameNode上报块信息,NameNode更新元数据,返回成功响应给客户端。4)流水线写入完成后,如何知道写入成功(从namenode和datanode两种节点)NameNode:管理文件系统命名空间,存储元数据(