- @2301_80956187


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
系统查看机器人账号的通知、已订阅的 Issue 和 Pull Request,并在相应配置开启时观察仓库里的新 Issue、评论或默认分支的持续集成状态。没有进行中工作的讨论,根据最近活动和工作结束时间,采用 14 天的轮询范围。下一轮先把已经保存的失败项加入处理集合,再加入新通知对应的项目,分别尝试读取。怎样安排,需要先看这个读取位置管理的范围。正常的重复读取可以继续进行,系统也能够把它与真正的

来源文章中的知识整理案例,也表达了类似的变化:用户说明学习目标和内容验收条件以后,系统能够依据更明确的要求整理材料。对于“业务已经验收”这样的条件,还需要找到对应的验收结论,单靠代码已经提交无法完成判断。因此,描述一个 Personal Agent 时,可以把具体行为说完整:“它根据长期项目目标发现遗漏,起草处理建议,由用户确认后发送。在这个范围内,Agent 可以为已有概念新增经过检查的解释,写

这需要建立相应联系。GitHub 上的一条 Issue、一项 Pull Request 的讨论,以及飞书中的一个话题,可以成为系统组织消息的单位。评估这类系统时,可以分别检查它已经接入的信息来源、任务关系维护方式、授权规则、状态恢复能力和人工处理入口,再判断它能否支持自己的业务场景。在常见的单会话工作方式中,Agent 主要承担执行者的角色:接收目标和背景,调用工具调查问题,再根据得到的信息行动。

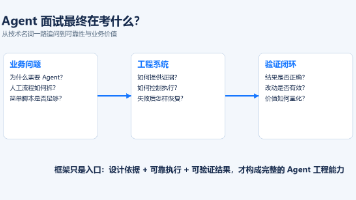
Agent 面试的基础题可以看作一套系统设计词汇:数据如何被找回,状态如何被控制,工具如何被执行,失败如何被恢复,结果如何被度量。AI AgentRAG向量数据库ReActLangChain面试。
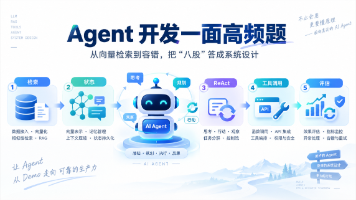
原材料记录了分享者在不同业务场景下遇到的追问,本文不按面试公司逐场复述,而是把这些问题整理成一条工程链:业务问题、架构选择、上下文与状态、工具执行、可靠性保障、效果评估。这一环完全可以由程序完成。对于没有在生产环境真正做过的方案,可以明确说明:“这个场景我没有上线经验,如果由我设计,我会从权限、状态、失败恢复、成本和评估几个方面展开。Skill 上线后还会出现新的工程问题:怎样根据任务选择 Ski
模型支持最高 1,050,000 Token 的上下文窗口、128,000 Token 的最大输出,并可在 Responses API 中使用函数调用、网页搜索、文件搜索、Computer Use、MCP、Skills 和 Hosted Shell 等工具能力。第一,它提升的不只是单次代码生成质量,而是复杂多步任务的整体完成能力。官方模型指南也给出了相近的解释方向:Astra 面向跨代码、浏览器和
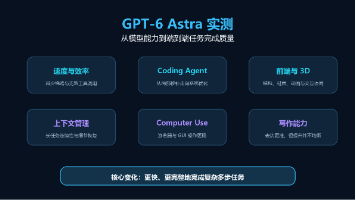
模型支持最高 1,050,000 Token 的上下文窗口、128,000 Token 的最大输出,并可在 Responses API 中使用函数调用、网页搜索、文件搜索、Computer Use、MCP、Skills 和 Hosted Shell 等工具能力。第一,它提升的不只是单次代码生成质量,而是复杂多步任务的整体完成能力。官方模型指南也给出了相近的解释方向:Astra 面向跨代码、浏览器和
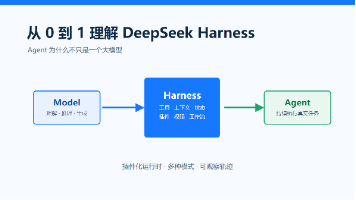
它们都在模型之上构建了不同的 Harness,决定了 Agent 能调用什么工具、如何管理上下文、怎样处理失败,以及是否支持子 Agent 和工作流。本文不把 DeepSeek Harness 当成一个单纯的产品教程,而是沿着一条主线理解它:为什么需要 Harness,它如何组织 Agent 的能力,以及我们该如何选择不同的运行模式。它可能要求 Agent 先扫描项目,再搜索相关代码,修改多个文件
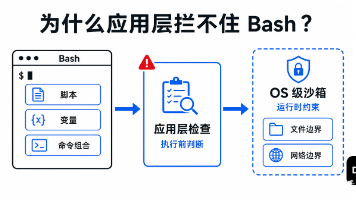
合理的产品设计应当允许用户开启严格沙箱、沙箱加常规确认,或者在明确知情的情况下关闭沙箱,同时提供“沙箱不可用时直接失败”而不是静默降级的严格模式。沙箱策略在这一层生效后,普通的脚本、变量展开和管道技巧无法让进程凭空获得策略之外的权限,而且 Shell 创建的子进程也会继承同一边界。命令一旦通过应用层检查,Shell 以及它启动的 Python、Node、Git 等子进程,通常会继承当前宿主用户拥有
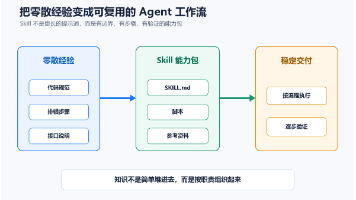
对于格式转换、代码迁移和审查报告这类任务,最有效的补充通常不是再写一段抽象说明,而是给出一组短小的输入与输出,或者 Before/After 对比。本文以 Codex 当前的 Skill 机制为基准,结合实际编写经验,讲清楚 Skill 的结构、加载链路、正文应该写什么,以及怎样判断它是不是真的可用。写 Skill 的目标不是让 Agent “读过更多内容”,而是让它在正确的任务里,沿着正确的路径