


- @2301_77539454


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
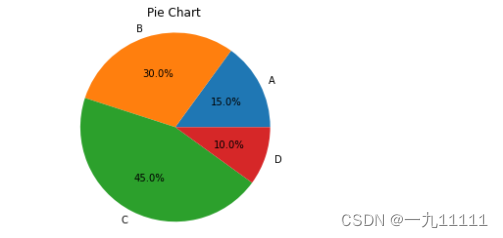
Matplotlib是一个用于绘制图表和可视化数据的Python库,由John D. Hunter于2003年创建。它是一个开源项目,广泛应用于科研、教育和工程等领域。Matplotlib提供了广泛的绘图功能,适用于科学计算、数据分析、机器学习等领域,并且尤其适用于中小规模的数据集和对可视化定制要求较高的场景。广泛的图表类型:支持多种图表类型,包括线图、散点图、柱状图、饼图、等高线图等,适用于不同
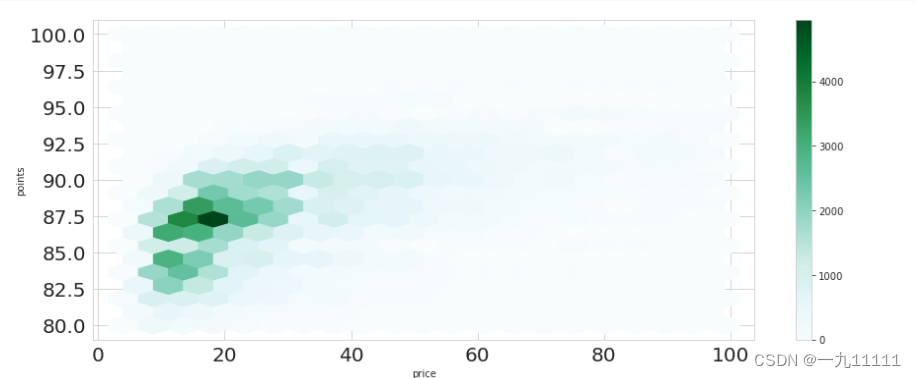
Pandas 自带的可视化功能通过 plot 方法提供了一种便捷的方式来创建各种类型的图表。plot 方法是基于 Matplotlib 库构建的,因此它继承了 Matplotlib 的强大功能和灵活性,同时简化了绘图过程,使得用户无需深入了解 Matplotlib 的所有细节即可快速创建图表。主要特点和优势:集成性:plot 方法直接集成在 Pandas DataFrame 和 Series 对象
NumPy(Numerical Python的简称)是Python中用于进行数值计算的基础库。它提供了高性能的多维数组对象以及用于操作这些数组的工具,使得数值计算任务变得简单而高效。无论你是数据分析师、机器学习工程师,还是科学计算研究者,NumPy都是不可或缺的工具。通过NumPy,你可以轻松创建和操作大型多维数组,执行各种数学运算,如元素级运算、聚合运算和线性代数运算等。这些功能使得NumPy成

Boosting思想是一种强大的机器学习策略,它基于“知错就改”的原则,旨在通过迭代地训练多个弱学习器(如决策树)并将它们组合成一个强学习器,从而提升模型的预测能力。Boosting通过不断调整样本权重,使得先前学习器错误分类的样本在后续迭代中获得更多关注,从而逐步优化模型性能。这种策略不仅提高了模型的泛化能力,还使得模型对复杂问题的处理更加灵活和高效。
Boosting思想是一种强大的机器学习策略,它基于“知错就改”的原则,旨在通过迭代地训练多个弱学习器(如决策树)并将它们组合成一个强学习器,从而提升模型的预测能力。Boosting通过不断调整样本权重,使得先前学习器错误分类的样本在后续迭代中获得更多关注,从而逐步优化模型性能。这种策略不仅提高了模型的泛化能力,还使得模型对复杂问题的处理更加灵活和高效。
机器学习是一门多领域交叉学科,涉及概率论、统计学、逼近论、凸分析、算法复杂度理论等多门学科。它专门研究计算机怎样模拟或实现人类的学习行为,以获取新的知识或技能,并重新组织已有的知识结构,使之不断改善自身的性能。机器学习是人工智能的核心,是使计算机具有智能的根本途径。
经过前几篇的基础语法的学习,您已经掌握了Dataframe的基础操作。在掌握基础操作后,进一步探索其进阶用法能够让你更高效地处理和分析数据。
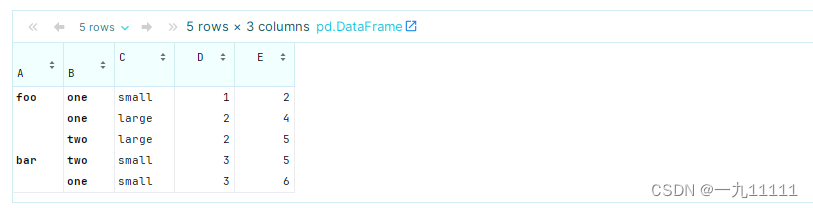
通过合理地关联多个DataFrame,我们可以构建出更加丰富和全面的数据集,为数据分析提供坚实的基础。无论是在学术研究、商业分析还是其他领域,关联多个DataFrame都是数据处理和分析中的关键步骤之一。本篇我们主要介绍Dataframe的数据组合和apply的相关语法。
损失函数(Loss Function),又称为代价函数或目标函数,是衡量模型预测值与真实值之间差异的函数。它为模型训练提供了优化的方向,通过最小化损失函数来调整模型参数。梯度优化方法是深度学习中用于训练神经网络的核心算法,其目的是通过迭代调整网络参数,最小化损失函数,从而提高模型的预测准确性。梯度优化方法的重要性在于它们直接影响到模型的训练效率和最终性能。定义:梯度优化方法利用损失函数对模型参数的
使用DataFrame处理时间序列数据时,你可以轻松地进行时间戳的转换和格式化。Pandas提供了丰富的函数和方法来处理日期和时间,如pd.to_datetime()用于将字符串转换为日期时间对象,.dt访问器用于访问日期时间的各个部分,以及strftime()方法用于将日期时间对象格式化为字符串。这些功能使得在DataFrame中处理时间序列数据变得简单而直观。此外,DataFrame还支持基于
