登录社区云,与社区用户共同成长
邀请您加入社区
基于大模型人工智能泵阀品控溯源管理系统平台软件
基于大模型人工智能的固态储氢材料逆向研发系统平台软件
基于大模型人工智能的四代堆多目标协同优化系统平台软件
2026年,SRM正从被动的记录系统转变为主动的AI辅助编排引擎。AI正全面嵌入供应商全生命周期管理——前端智能寻源、供应商画像、物料成本预测,中端合同条款自动审核、交付风险动态预警,后端供应商绩效持续评估与改善。SRM呈现四条清晰的主线:人工智能深度渗透寻源与风控全流程;行业垂直化方案成为竞争壁垒;底层架构向生态化与iPaaS集成演进;国产替代在政策驱动下的规模化落地。SRM+AI(外挂式)智能
摘要: 未来十年(2025–2035),多模态大模型(MLLM)将向端到端原生、多任务智能体平台演进,核心能力包括原生多模态、任意输入输出、边缘化及合规治理。发展分为三阶段:原生化起步(统一表征)、扩展规模化(多模态智能体)、普适治理化(机器人/公共服务)。北京将聚焦工业质检、政务文档等场景,需解决模态偏差、长尾泛化等挑战,最终实现可规模化、可治理的实体世界智能交互。
本文介绍了一个上门做饭O2O系统的微服务架构设计与实现。系统采用SpringCloudAlibaba生态,包含用户端、厨师端和管理后台三大模块,通过Nacos实现服务注册发现,使用Seata处理分布式事务。核心设计包括:1)领域驱动划分微服务(用户、厨师、订单等7个服务);2)订单状态机管理业务流程;3)分布式事务解决方案。关键技术实现涉及服务通信、状态流转校验和TCC补偿机制。系统支持高并发订单
摘要:本文提出市级政务大数据平台设计方案,构建"聚、管、通、用、安"五位一体体系,通过统一数据湖与数据库归集治理多源政务数据。平台采用分层架构,包含数据管理、治理、开放、安全等子系统,实现数据全生命周期管理。重点解决数据孤岛、标准不一等问题,支撑19个领域专题应用,并通过混合云部署确保安全可控。方案通过组织架构优化和持续迭代机制,推动政务数据共享与城市治理能力提升。(149字)
摘要: 多模态大模型(2015-2025)经历了从特征拼接到原生融合的进化,最终实现全模态理解与物理世界交互。 阶段1(2015-2020):CNN+RNN拼凑架构,模态间存在语义鸿沟(如VQA依赖数据记忆)。 阶段2(2021-2022):CLIP和ViT实现跨模态对齐,Transformer统一文本、图像等处理(如DALL-E 2)。 阶段3(2023-2025):原生多模态(GPT-4o)、
摘要: 云原生模型训练在2015-2025年间经历了三个阶段演进:从早期容器化解决环境一致性问题(2015-2017),到MLOps标准化与分布式算力爆发(2018-2022),最终迈向AI-Native平台工程与内核级性能优化(2025)。2025年的技术突破包括eBPF驱动的零拷贝通信、动态算力池化及跨云热迁移,使云原生平台从通用托管环境升级为智能工厂运行时,支持万亿参数模型的自动化训练调度。
摘要: 深度学习在2015-2025年间经历了三大技术范式演进:从CNN/LSTM主导的监督学习(2015-2018),到Transformer引领的大模型时代(2019-2022),最终发展为具身智能与VLA(视觉-语言-动作)模型(2025)。2025年的突破包括:端到端物理交互、eBPF内核级安全防护、世界模型预测物理演化。技术对比显示,架构从CNN转向VLA,学习方式从人工标注变为自监督+
摘要: 大模型服务化(2015–2025)经历了从基础API封装到高吞吐动态调度的跨越。早期(2015–2018)以RESTful API为主,面临GPU利用率低等问题;中期(2019–2022)通过连续批处理(如vLLM)和显存池化实现工业级稳定性。2025年技术进入“自治程序”阶段:eBPF实现内核级推理监控与微秒级自愈,服务端支持可编程推理逻辑(如LIPs),并通过2.5D路由优化成本。核心
本文深入探讨了Web系统数据中台从设计到落地的完整路径。文章剖析了传统“烟囱式”架构的痛点,阐述了数据中台作为统一数据能力层在降本增效、赋能业务创新方面的核心价值。重点解析了统一数据模型、数据资产目录、数据服务化与数据治理四大核心支柱的设计,并提供了涵盖数据采集、存储计算、任务调度的主流技术选型与实战心法,为构建高效、可用的数据中台提供了关键指引。
服务在独立进程中运行,并通过轻量级、明确定义的机制进行通信以实现业务目标。尽管文献中已识别出诸多优势,但 MSA 的采用仍被视为重大挑战,无论是在开发新系统还是软件现代化方面。关于软件现代化问题,研究表明,组织对采用 MSA 持抵触态度。还有研究表明,向微服务架构的转型绝非单纯的技术决策,必须与系统最初设计的业务目标保持一致。因此,仓促的技术决策可能导致过度拆分,这种做法虽然有利于实现自主性,却往
AI 大模型,完整名称是“人工智能大规模预训练模型”,日常简称 “大模型”。这是基于深度学习架构,在海量多模态数据上通过大规模预训练得到,具备海量参数与通用认知能力,可通过微调、提示等方式适配多场景下游任务的人工智能模型。而我们常说的大模型很多时候特指其中最主流的分支——大语言模型(Large Language Model, LLM)。通俗的说,大模型提供底层的理解、生成、推理能力,我们日常用的聊
摘要: 上门做饭系统采用SpringCloudAlibaba微服务架构,通过Nacos实现服务治理,Seata保障分布式事务。核心模块包括用户、厨师、订单、支付等微服务,使用领域驱动设计划分业务边界。关键技术包含:1)基于状态机的订单流转控制;2)OpenFeign服务调用与Ribbon负载均衡;3)TCC模式分布式事务处理。系统支持高并发订单与实时调度,未来可通过智能推荐、动态定价和物联网集成进
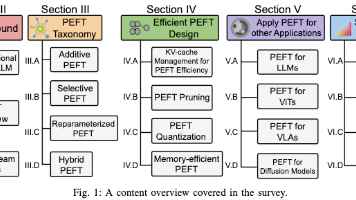
本文全面综述了参数有效微调(PEFT)技术,通过添加少量参数、选择性训练或重新参数化等方式,实现大模型的高效微调。文章系统介绍了PEFT的四大分类及其在不同模型类型中的应用,并探讨了系统设计挑战与优化策略,为研究人员和开发者提供了宝贵的参考资源。
大型语言模型(LLM)是基于Transformer架构的概率语言建模器,通过预测下一个词进行训练。核心原理包括Transformer架构(词嵌入、注意力机制等)、自回归训练和语言建模。推理时采用逐词生成策略,包括贪婪搜索、Top-k采样等方法。LLM的能力来自海量数据训练、注意力机制理解上下文、大量参数的记忆能力以及微调优化。理解这些原理有助于掌握大模型的工作机制和应用方法。
大数据架构设计精华摘要 本文系统解析了Lambda架构的理论与实践,重点剖析了其三层结构(批处理层/速度层/服务层)的设计思想与CAP理论的映射关系。通过技术选型对比表,详细阐述了Web系统各层组件(如LVS负载均衡、DUBBO服务调用、MongoDB存储等)的功能特性与应用场景。同时总结了架构优化策略,包括外网加速(CDN)和内网优化(分布式缓存)等关键技术。特别强调Lambda架构"
系列文章见:学习视频:江山老师。
数字孪生体技术通过物理实体的数字化镜像实现全生命周期管理,其发展历经NASA命名(2009)、军工应用等阶段,核心技术包括建模、仿真及数字线程。云计算按服务模式分为IaaS(高灵活)、PaaS、SaaS(高方便),部署模式涵盖公有云、私有云等。大数据技术以4V特征为核心,支撑精准分析。关键考点涉及数字孪生三维建模(需求/阶段/尺度)、云服务灵活性比较及混合云安全优势。典型应用覆盖智能制造、智慧城市
该命令启动一个与Nacos配置中心集成的微服务,使用主机网络模式,配置了持久化存储和日志管理,并确保服务在异常退出时自动重启。这是一个Docker容器运行命令,用于在后台启动一个服务容器。
本文作为《RDSS 与 RNSS 定位技术深度解析》系列的收官之作,直接聚焦主流定位系统,把不同应用场景的技术适配细节讲透,梳理未来技术演进方向,看完就能懂得技术落地的关键细节,理清两种技术的实战价值~我国高速公路货运车辆全部安装 RNSS 终端,管理中心可实时监控车辆位置、速度,若超速或疲劳驾驶,终端自动报警;遇台风、海盗或设备故障时,渔民可发送 “紧急短报文”(含渔船 ID、位置、灾情),地面
我记得有个CTO朋友跟我说:“我们上了微服务后,每天晚上都要起来处理服务调用超时的问题,比之前单体架构时还累。我记得有个团队花了三个月重构单体架构,结果发现根本不需要拆分成微服务,性能已经足够支撑业务增长。我见过太多团队,日活就几千,却搞了几十个微服务,每天光服务治理就耗费大量精力。因为最终,架构的价值不在于它有多先进,而在于它能否支撑业务持续稳定地发展。有个很好的做法是:先拆一个相对独立的边缘业
云原生架构源于企业IT痛点(资源孤岛、高运维成本)和技术演进(云计算、DevOps),通过容器化、微服务等技术实现业务轻量化与自动化。其核心原则包括服务化、弹性、可观测性等,并需避免反模式(如单体硬拆微服务)。典型架构含容器化、服务网格等,关键价值是降低开发复杂度,提升交付效率。学习需结合企业案例(如快递公司容器化)理解拆分边界与自动化必要性。(150字)
本文系统梳理了云原生架构核心技术,包括容器技术、微服务、Serverless和服务网格。容器技术通过Kubernetes实现标准化交付和弹性调度;微服务强调业务拆分和服务治理;Serverless提供全托管和无服务器化能力;服务网格实现基础设施层治理。文章通过旅行公司改造案例,展示了云原生在资源整合、稳定性提升等方面的实践价值,并指出关键考点和学习建议,为云原生技术应用提供全面指导。
Docker 支持多种日志驱动(json-file、syslog、journald等),主要适用于默认的 json-file 驱动。掌握这些用法可以大大提高容器化应用的运维效率。
传统数据库系统面临高并发、扩容复杂、架构臃肿等问题,催生大数据处理架构。Lambda架构通过批处理层(Hadoop/Spark)和速度层(Storm/Spark Streaming)的融合平衡实时性与准确性,但维护成本高;Kappa架构则简化设计,采用单一流处理引擎(Flink/Kafka),依赖数据重放修正错误。选择依据包括业务需求、数据规模和开发资源。Lambda适合历史数据分析(如奥运平台)
文章系统介绍大模型AI学习路径,涵盖基础认知、技术准备、实践指南和应用场景。强调掌握AI已成必备技能,提供四阶段学习计划:初阶应用(10天)、高阶应用(30天)、模型训练(30天)和商业闭环(20天),帮助读者从零基础成长为专业人才,并提供学习资源。