- @yjh_SE007


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
在大模型的生成过程中,部分原生的大语言模型未经过特殊的对齐训练,往往会“胡说八道”的生成一些敏感词语等用户不想生成的词语,最简单粗暴的方式就是在大模型生成的文本之后,添加敏感词库等规则手段进行敏感词过滤,但是在生成过程中,生成敏感词仍然耗费了时间和算力成本。本文以chatglm2-6B为例,通过自定义,实践大模型在生成过程中控制一些词语的生成。回到正题,如何自定义LogitsProcessor控制
假设文档的存在方向旋转,那么会进一步的干扰VLM进行OCR的性能,下面看一个预处理方案,解决文档旋转干扰OCR问题,并进行一些评估,方法较为简单,快速看一下。旋转分类任务定义:将文档旋转校正转化为。
本文以文本分类为例叙述步骤1、前向传播时,pytorch_pretrained_bert是以下内容_, pooled = self.bert(context, token_type_ids=types,attention_mask=mask,output_all_encoded_layers=False)报错:result = self.forwar
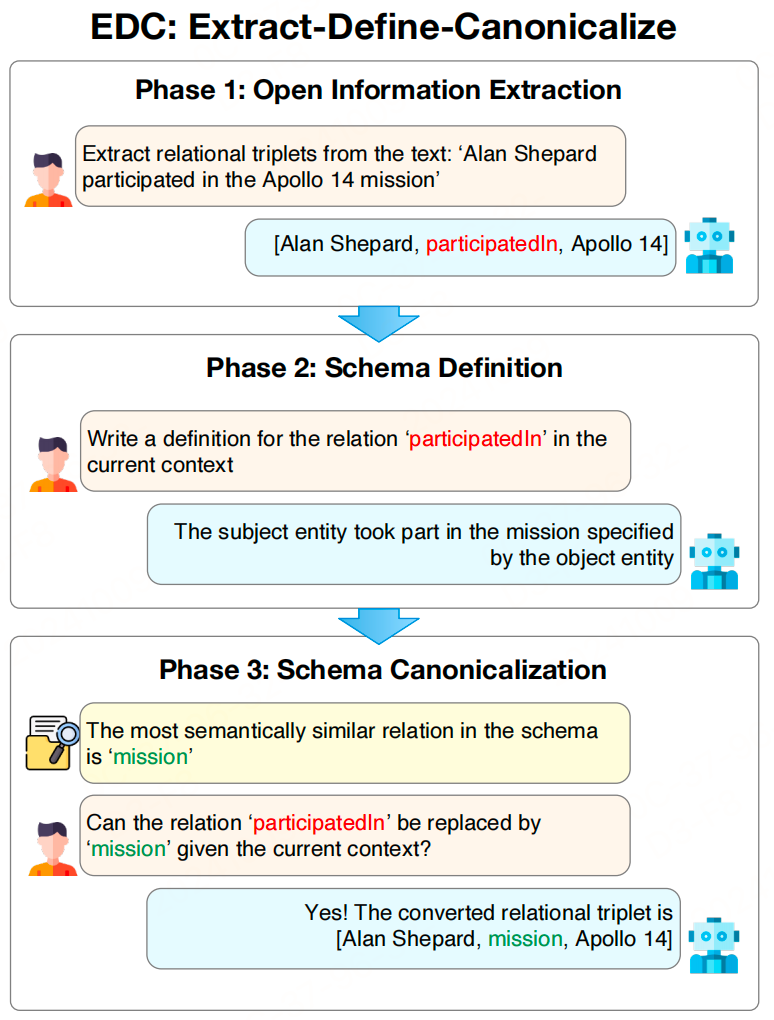
提示LLMs为提取的Schema组件(如实体类型和关系类型)提供自然语言定义。然后将这些定义作为用于规范化的辅助信息传递到下一阶段。
往期文章介绍了《【RAG】混合RAG系统,提升复杂推理任务表现》,本文再来看看KDD CUP2024的CRAG的第三名方案,该方案提出WeKnow-RAG方法,结合了知识图谱和基于Web的RAG技术,通过多阶段检索、自评估机制以及智能平衡框架,提高了信息检索的精度和生成答案的可靠性。WeKnow-RAG方法通过结合知识图谱和Web搜索,设计了一个端到端的检索增强生成系统。该方法通过多阶段检索和自评

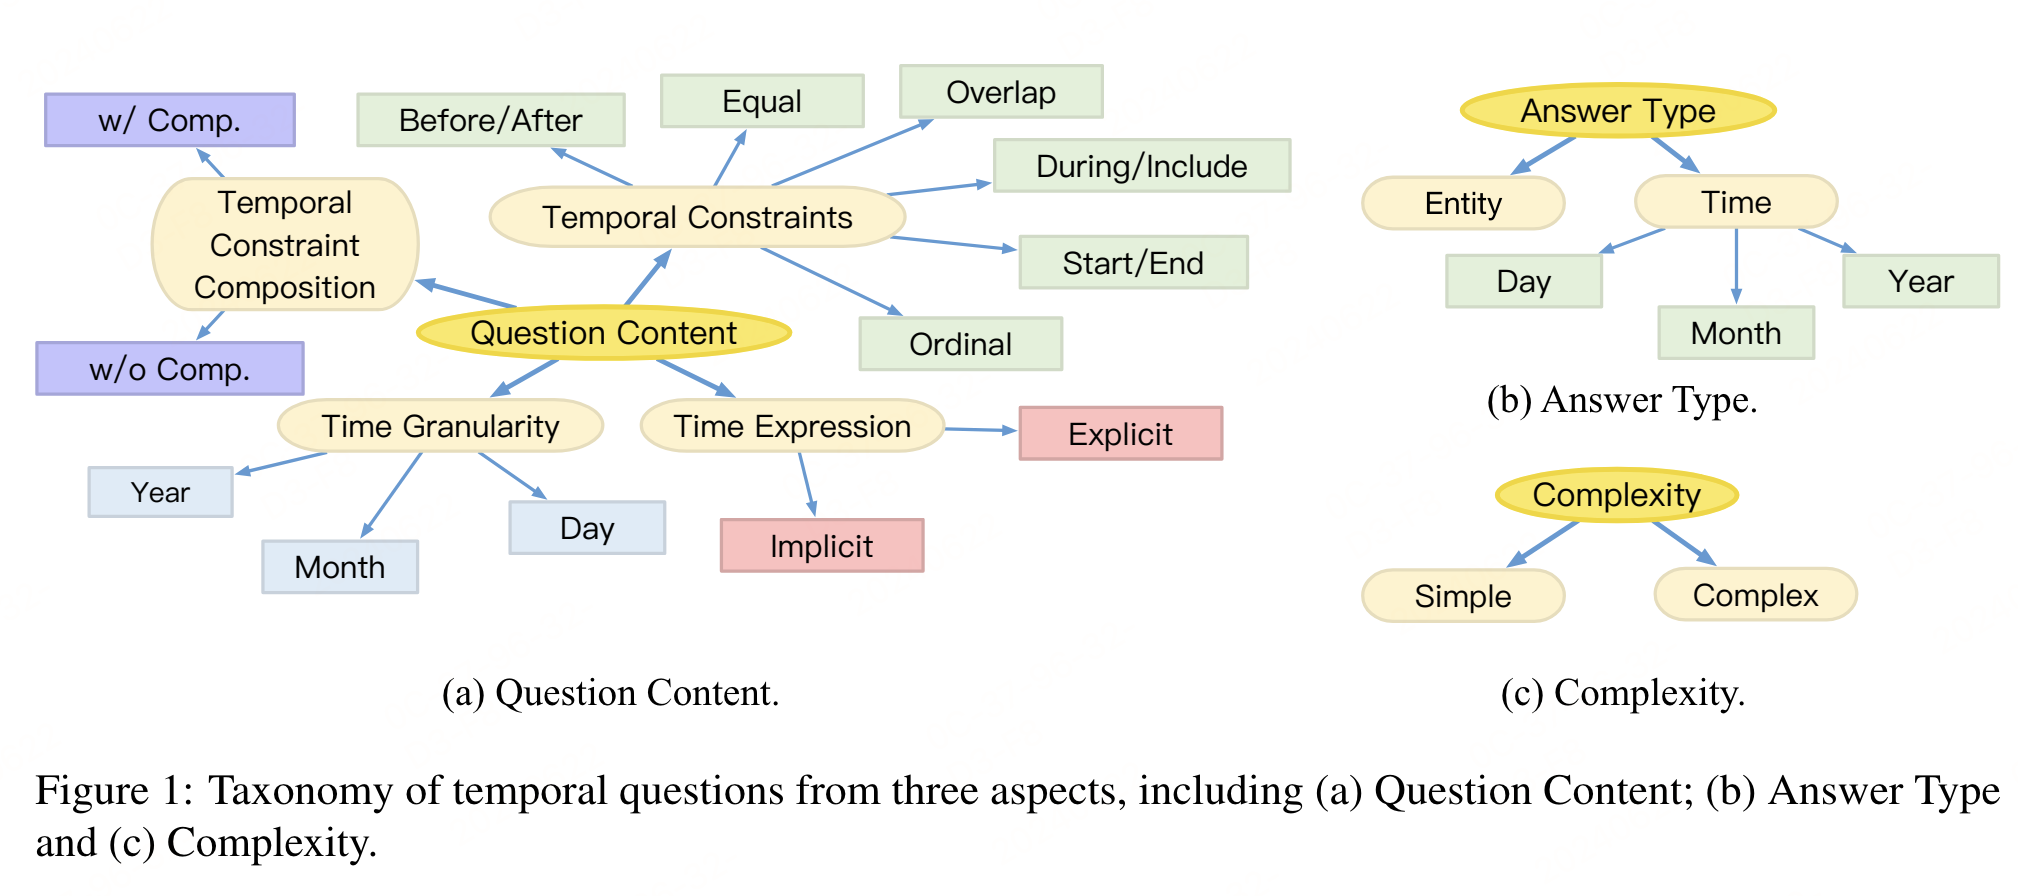
时间知识图谱问答(TKGQA)是KBQA中一个关注时间问题的重要子任务。时间问题包含时间约束、需要时间标记的答案,反映了现实世界事件的动态和演变性质。通常表示为 G = (E, R, T, F),其中 E、R、T 和 F 分别代表实体(entities)、关系(relations)、时间戳(timestamps)和事实(facts)。一个时态事实 f ∈ F 由一个或多个实体、关系和相关的时间戳组
来看一个实验比较扎实的工作,Skywork-R1V3将R1的思路引入多模态大模型,提出:直接将RL技术从仅文本的大语言模型转移到VLMs是不够的,需要开发VLM特定的RL配方。下面来看看如何在VLM中引入COT的RL,供参考。

笔者关注vary和GOT已久,抽空做了下技术思路记录,GOT是Vary的后续,GOT通过三个阶段的训练,模型能够逐步提升其在各种OCR任务上的性能,从基础的纯文本识别到处理更复杂的格式化和通用OCR任务。每个阶段的训练都注重不同的数据类型和任务,确保模型在多样化的应用场景中都能表现出色。笔者在折腾过程中,这个链路的一阶段的数据搞起来太伤身了,可以直接在开源权重上进行post-train,二/三阶段

英伟达的技术报告一般细节都比较多,本次开源的12B的参数模型-Nemotron Nano V2 VL专为文档理解、长视频理解及推理任务而设计。下面来快速过一下。
看到一篇博客,写的不错,原文:A hitchhiker’s guide into LLM post-training,https://tokens-for-thoughts.notion.site/post-training-101本文仅作译记录。本文档旨在作为理解大语言模型(LLM)后训练基础的指南,涵盖了从预训练模型到指令微调模型的完整流程。指南将梳理后训练的全生命周期,探讨以下内容:基础模型