


- @yangyanping20108


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
rabbitmq消息队列学习之进阶死信队列死信队列DLX,全称为Dead-Letter-Exchange,可以称之为私信交换器,也有人称之为死信邮箱。当消息在一个队列中变为死信(dead message) 之后,它能被重新发送到另一个交换器中,这个交换器就是DLX,绑定DLX的队列就称之为死信队列。消息变为死信一般是由于以下几种情况:消息被拒绝( Basic.Reject/Basic.Nack )
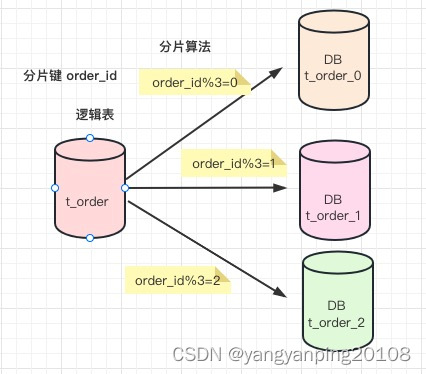
Apache ShardingSphere 是一款分布式的数据库生态系统, 可以将任意数据库转换为分布式数据库,并通过数据分片、弹性伸缩、加密等能力对原有数据库进行增强。
flag是 Go 官方命令行解析库,零依赖-参数名 值传参定义参数必须调用Gin 项目常用它接收:配置路径、环境、端口。
Prometheus是一个开源的系统监控和警报工具包,采用拉取式模型采集时序数据,特别适合云原生环境监控。其核心特性包括多维数据模型、PromQL查询语言、内置时序数据库和服务发现等。主要组件有Prometheus Server、Exporter、PushGateway和Alertmanager。支持多种指标类型如Counter、Gauge和Histogram,常与Grafana可视化工具搭配使用
摘要:积分系统设计采用三张表(总表、流水表、可用明细表)管理积分生命周期。通过定时扫描可用积分表及时清理过期记录,优先使用即将过期积分,不足时拆分记录处理。采用消息队列(MQ)实现5亿用户积分到期提醒,避免全表扫描。该方案有效解决积分时效性、使用优先级和大规模用户提醒问题,兼顾数据准确性与系统性能。(149字)
Flink是一个支持流批一体的分布式数据处理引擎,具有低延迟、高吞吐和精准容错特性。本文介绍了Flink的安装与基本使用方法:首先下载并解压Flink二进制包,检查Java环境;然后通过启动脚本运行本地集群,可通过8081端口访问Web界面;接着演示了如何提交内置的WordCount示例作业,查看执行结果和日志;最后说明了如何监控作业状态和数据流执行计划。该指南帮助用户快速完成Flink的本地环境
Apache Flink 提供了用于构建健壮的有状态流应用程序的 DataStream API。它提供了对状态和时间的细粒度控制,从而能够实现高级的事件驱动系统。在这里,你将学习如何使用 Flink 的 DataStream API 构建有状态流应用程序。
Flink 的 Apache Kafka 连接器支持从 Kafka 主题读取数据以及向主题写入数据
Flink 本质是为「高吞吐、低延迟、精准一次」的实时数据处理而生,尤其适配广告、电商、风控等对实时性和准确性要求高的场景。

即数据变更捕获。它不像传统方式那样去“询问”数据库现在的状态,而是监听数据库的“日志”(对于 MySQL 来说就是 Binlog)。比喻:传统方式是你每隔一小时打电话问朋友:“你现在在干嘛?”(轮询);CDC 是朋友发朋友圈,你立刻就收到了通知(监听日志)。
