


- @xjxijd


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
当AI大模型训练与推理需求呈指数级增长,传统风冷散热体系正遭遇不可逾越的物理极限。从H100的700W到Vera Rubin架构的3700W,四年间AI芯片功耗飙升5倍,风扇转速已无法匹配算力密度的提升,噪音污染与散热效率瓶颈成为数据中心发展的双重枷锁。在此背景下,英伟达NVL72系统以全液冷无风扇架构横空出世,不仅重塑了AI算力基础设施的散热范式,更开启了静音算力革命的新纪元,推动无风扇AI服务
随着生成式AI的爆发,万亿参数大模型训练对算力集群的规模要求直线攀升,万卡级GPU集群已成标配。但很多人没意识到,当集群规模突破千卡迈向万卡,真正的瓶颈从来不是单卡算力,而是节点间的数据通信时延——大量GPU算力被浪费在等待数据传输上,有测试显示AI CV类负载中GPU实际工作时间仅36%。而共封装光学(CPO)技术,正是当前解决万卡互联低时延问题的核心方案。今天我们就从技术原理、架构设计到实际落
算力机房托管是指企业或机构将自身的算力相关设备、数据及业务等,委托给专业的第三方数据中心(IDC)运营商进行管理和运营的服务模式1。企业无需自行建设和维护复杂的机房设施,只需将服务器等算力设备放置在运营商提供的专业机房环境中,由运营商负责提供电力供应、网络连接、安全防护、设备维护等一系列服务,以确保算力设备的稳定运行和数据的安全可靠。
新增SonarQube代码扫描阶段pipeline:stages:actions:。
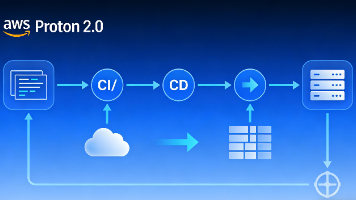
随着 AI 服务(如实时推理、智能推荐)对弹性伸缩和低延迟的双重需求,传统纯 FaaS 架构的冷启动瓶颈、纯容器架构的资源浪费问题日益凸显。Serverless 3.0 的核心突破在于。,通过 “稳定服务 + 弹性扩展” 的混合模式,既保留容器对复杂负载的兼容性,又继承 Serverless 毫秒级伸缩能力,最终实现 AI 服务响应速度 3 倍提升的关键目标。高(按执行计费 + 资源复用)传统 S

大模型训练任务普遍存在计算与显存需求耦合、通信开销占比高的特点,传统调度仅以 GPU 卡数为分配单位,忽略了显存、带宽、CPU 等多维资源的约束,容易出现 “卡数够但显存不足” 的假性争抢。大模型分布式算力调度的核心并非追求绝对的资源最大化利用,而是在业务优先级、资源效率、系统稳定性三者间找到平衡,通过精细化的资源管控与动态调度机制,从根本上缓解多节点资源争抢问题。调度器不再以单卡为调度单位,而是
过去三年,生成式人工智能技术的迭代速度远超行业预期。从大模型参数规模的竞赛到行业场景的规模化落地,整个产业正在经历一场从技术验证向商业投产的深刻转型。而支撑这场转型的底层基石,正是算力基础设施的快速扩张。与此同时,随着监管体系的逐步完善,算力配套合规已经不再是企业发展的可选项,而是进入市场的刚性门槛。

几乎所有商用大模型 API,统一采用 Token 作为计费最小单位,多数开发者只停留在 “输入一段文字扣对应费用” 的表层认知,在 RAG 知识库问答、超长文档解析、多轮长对话场景中,经常出现单次调用费用远超预期的情况。很多人疑惑,只是多粘贴了几千字参考文档,账单成本却出现断崖式上涨,核心根源不在文本字数本身,而是 Token 背后绑定的 GPU 算力、显存、带宽与推理架构成本。
在大模型与 AI 应用全面落地的当下,GPU 已成为企业算力基建中最昂贵的核心资产。然而绝大多数企业在生产环境中都面临着同一个尴尬的现实:采购成本居高不下,但实际 GPU 平均利用率长期徘徊在 30% 以下,大量算力在闲置中被浪费。尤其是在广州、深圳等珠三角科创企业密集的区域,随着 AI 创业公司与传统制造业数字化转型的加速,算力供需矛盾与成本压力愈发凸显。
大模型训练任务普遍存在计算与显存需求耦合、通信开销占比高的特点,传统调度仅以 GPU 卡数为分配单位,忽略了显存、带宽、CPU 等多维资源的约束,容易出现 “卡数够但显存不足” 的假性争抢。大模型分布式算力调度的核心并非追求绝对的资源最大化利用,而是在业务优先级、资源效率、系统稳定性三者间找到平衡,通过精细化的资源管控与动态调度机制,从根本上缓解多节点资源争抢问题。调度器不再以单卡为调度单位,而是