


- @xiaxianba


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
在软件测试领域,单元测试占据了很重要的位置,不管支撑前端的功能测试,还是后端的开发,单元测试在测试领域中占有绝对的关键位置,本文将针对Python环境下的单元测试框架unittest进行深入研究。本文使用的软件环境如下:软件版本PythonPython 2.7.15PyCharmPyCharm 2019.1(Community Edition)unittest...
金融行业的从业人员都清楚,不管做研究还是做分析都离不开一款金融软件–Wind金融终端(这里主要基于Version:18.1.1.67462 [Build 2019-03-25]),最开始接触这款软件是做量化研究的时候,因为感觉确实是一款帮助很大,同时在国内也确实是TOP1,以后可能还会用到,这里把自己的使用经验总结、记录下来,方便初学者或者研究不深的人学习使用。主界面主要按照投资标的:股票、债..
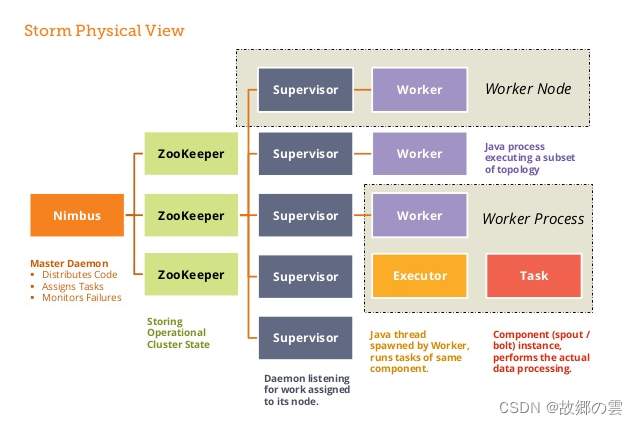
一个完整的 Storm 流处理程序被称为 Storm topology(拓扑)。它是一个是由和通过连接起来的有向无环图,Storm 会保持每个提交到集群的 topology 持续地运行,从而处理源源不断的数据流,直到你将其主动杀死 (kill) 为止。 是 Storm 中的核心概念。一个是一个无界的、以分布式方式并行创建和处理的序列。Tuple 可以包含大多数基本类型以及自定义类型的数据。简单来说
【参考文献】1.kettle 从数据库表将数据写入 hadoop hdfs
自从使用了Kettle工具之后,越来越发现她的强大,上篇文章主要介绍通过Kettle工具在传统数据库之间迁移数据,但很多业务场景是需要放到大数据上去的,如何通过Kettle工具把传统数据库中数据导入到Hive中,这是本文要详细讲解的。一、准备系统版本本地操作系统Windows 10 proETL工具Kettle 7.0.0数据库SQL Server 200...
2015年有幸加入某大厂大数据项目,在此之前从没有接触过大数据这类高大上的技术,进入大厂之后才发现,原来大厂在做研究项目,也就是商业化前的可行性论证,也只有大厂会花这么多人力、物力做这个。当时物色了很多优秀的人才,有海龟博士、国内顶尖计算机专业硕士、资深大数据专家等等。但最终做了两年不到,项目最终被解散,回过头来总结经验,虽然时间隔得有点远,但很有必要。一、业务需求空间更小,速度更快当时做...
一、什么是大数据大数据(big data),指无法在一定时间范围内用常规软件工具进行捕捉、管理和处理的数据集合,是需要新处理模式才能具有更强的决策力、洞察发现力和流程优化能力的海量、高增长率和多样化的信息资产。在维克托·迈尔-舍恩伯格及肯尼斯·库克耶编写的《大数据时代》 中大数据指不用随机分析法(抽样调查)这样捷径,而采用所有数据进行分析处理。IBM提出大数据的5V特点:Volume(大量)、V.
数据分析的基础是统计学,统计学又分描述性统计和推断性统计,其中描述性统计又是统计学的基础,也是推断性统计的前导。其百度百科定义是这样的:描述统计是通过图表或数学方法,对数据资料进行整理、分析,并对数据的分布状态、数字特征和随机变量之间关系进行估计和描述的方法。描述统计分为集中趋势分析和离中趋势分析和相关分析三大部分。一、集中趋势分析平均数:平均数是总和除以总量。中数:中位数是数值大小位于中...
大自然的规律有很多,在人们没发现之前都认为是上帝在操作,当我们发现其真正规律之后,我们往往惊讶于这样的发现,贝叶斯公式(Bayes)就是世界通用型规律。参考文献1.全概率公式、贝叶斯公式...
数据分析的基础是统计学,统计学又分描述性统计和推断性统计,其中描述性统计又是统计学的基础,也是推断性统计的前导。其百度百科定义是这样的:描述统计是通过图表或数学方法,对数据资料进行整理、分析,并对数据的分布状态、数字特征和随机变量之间关系进行估计和描述的方法。描述统计分为集中趋势分析和离中趋势分析和相关分析三大部分。一、集中趋势分析平均数:平均数是总和除以总量。中数:中位数是数值大小位于中...