- @x32sky


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
我首先声明,我有一些标题党的嫌疑,确实没有什么血案发生,顶多是我找BUG 时由于太用力把嘴唇给咬破了。
关键时刻,第一时间送达!机器学习是当前最为火爆的话题之一,机器学习的开源项目也层出不穷,让人目不暇接。本文从受欢迎程度方面,对比以及挑选出了去年发布的30个最火的机器学习项目。下面,让我们一起来看看,2018年究竟有哪些机器学习的开源项目最受开发者的喜爱吧。FastTextGithub代码库:https://github.com/facebookresearch/fastTextGithub给星:
很多人用 llama.cpp 就是 ./llama-server -m model.gguf 一把梭,能用,但在 8GB 这种资源受限板子上,默认参数随时教你做人:上下文溢出、swap 抖动、功耗撞墙。坑 1(实测踩过):漏挂 mmproj,文本问答正常,一发图片请求直接 500。模型:Qwen2.5-3B Q4_K_M、Qwen2.5-VL-3B Q4_K_M + mmproj-f16。资源受限
语音+大模型指挥机器人:LLM Agent × ROS2 端到端实战你对着麦克风说"左转九十度",Gazebo 里的小车真的转了 90°;你问"前面有障碍物吗",机器人用激光雷达的真实数据开口回答你。全程离线,没有一个请求发到云端。这篇文章记录这个系统从零到闭环的完整实战。
两天,九个坑,代码核心逻辑零改动——消息契约和分层设计在这次联调里救了我无数次,每次排查都不用怀疑业务代码,问题全在环境和集成层。分布式就是这样:单机跑通只完成了 30%,剩下 70% 是让两台机器像一台一样工作。下一篇打算写跨机延迟对比数据——Jetson 端推理比 PC 慢了约 5 倍,但指令缓存命中依然 3ms,这个反差很有意思。项目:LLM Agent × ROS2 语音机器人(Day11
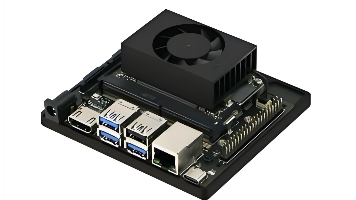
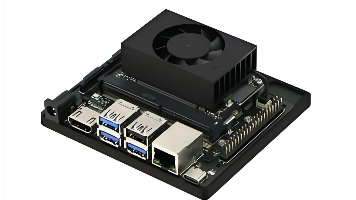
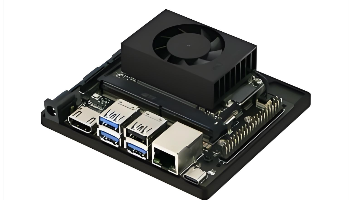
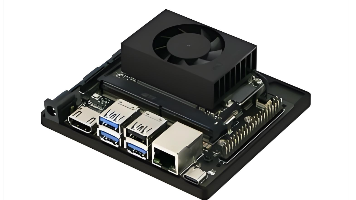
文章摘要: 本文分享了在Jetson Orin 8GB边缘设备上部署Qwen2.5系列大模型的血泪经验与13个推理框架的深度评测。作者通过五次OOM崩溃的教训,对比了编译型(如MLC-LLM、TensorRT-Edge-LLM)和解释型(如llama.cpp)方案的优劣,最终推荐: MLC-LLM为1.5B/3B模型首选,支持交叉编译和量化,峰值内存仅2.5-3GB; TensorRT-Edge-
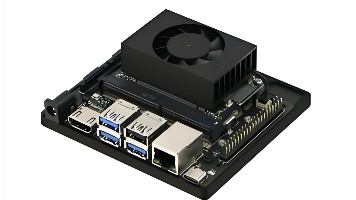
摘要:本文详细记录了在8GB内存的Jetson Orin Nano Super上通过MLC-LLM成功部署Qwen2.5-1.5B和3B模型的全过程。MLC-LLM的编译器路线避免了TensorRT在构建期的内存溢出问题,结合q4f16_1量化将1.5B模型权重压缩至840MB,实测生成速度达60 tok/s,首token延迟仅0.077秒,峰值内存4.44GB。文章从环境配置、模型下载到性能测试
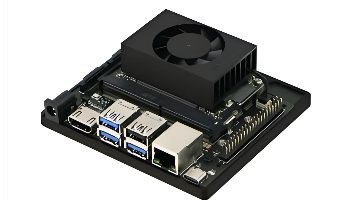
本文分享了在NVIDIA Jetson Orin Nano(8GB内存)边缘设备上部署Qwen2.5-VL-3B视觉语言模型(VLM)的实战经验。作者首先介绍了当前机器人领域的大模型技术概况,包括WAM和VLA模型,并指出由于硬件限制选择了轻量级VLM方案。文章详细记录了从环境配置、模型编译到性能测试的全过程,重点解决了CUDA加速编译、多模态组件缺失等关键问题。测试结果显示,该模型在文本生成(2
本文分享了在NVIDIA Jetson Orin Nano(8GB内存)边缘设备上部署Qwen2.5-VL-3B视觉语言模型(VLM)的实战经验。作者首先介绍了当前机器人领域的大模型技术概况,包括WAM和VLA模型,并指出由于硬件限制选择了轻量级VLM方案。文章详细记录了从环境配置、模型编译到性能测试的全过程,重点解决了CUDA加速编译、多模态组件缺失等关键问题。测试结果显示,该模型在文本生成(2
本文记录了在Jetson Orin 8GB开发板上部署Qwen2.5-1.5B/3B大模型时,从JIT编译转向交叉编译的完整过程。作者通过PC交叉编译模型后直接部署到Jetson设备,成功解决了启动慢(2分钟降至秒级)、内存溢出(编译内存从8GB爆满提升到31GB宽松)和依赖网络(实现离线部署)三大痛点。实测性能显示,3B模型的首次响应速度提升44%且吞吐量保持稳定。文章详细分享了8个关键踩坑点,