


- @wodertianna


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
groupby函数是pandas中用于数据分组和聚合的强大工具。通过它,你可以根据一个或多个列的值将数据划分为不同的组,并对每个组执行各种聚合操作,从而获取有关数据的深入见解。
最近邻算法作为一种基于实例的学习方法,通过距离度量寻找与待分类样本最近的k个训练样本,并根据这些最近邻样本的类别进行分类。最近邻算法(k-Nearest Neighbors,k-NN)是一种简单且直观的分类算法,广泛应用于分类和回归问题。本文将详细介绍最近邻算法的由来、基本原理、构建过程及其优缺点。最近邻算法是一种基于实例的学习方法,其基本思想是根据距离度量寻找与待分类样本最近的k个训练样本,然后
k-最近邻(k-Nearest Neighbors,KNN)算法是一种基本的机器学习分类和回归算法。在分类问题中,KNN通过测量不同特征值之间的距离来进行分类。它的工作原理是:存在一个样本数据集合,也称作训练样本集,并且样本集中每个数据都存在标签,即我们知道样本集中每一数据与所属分类的对应关系。输入没有标签的新数据后,将新数据的每个特征与样本集中数据对应的特征进行比较,然后算法提取样本集中特征最相
随机森林(Random Forest)原理基于集成学习思想,通过构建多棵决策树并集成它们的预测结果来提高模型的准确性和稳定性。具体来说,随机森林首先通过自助法(bootstrap)从原始数据集中随机抽取多个样本子集,并在每个样本子集上随机选择特征子集来构建决策树。这种随机性确保了每棵决策树都是基于不同的数据和特征进行训练的,从而减少了它们之间的相关性。在预测时,随机森林将多棵决策树的预测结果进行投
使用遗传算法,解决排班问题,优化人力资源配置。
乘法季节性分解是一种有效的时间序列分析技术,适用于具有乘法关系和显著季节性模式的数据。通过将时间序列分解成趋势、季节性和随机成分,可以更好地理解数据的内在结构和变化规律。乘法季节性分解是一种时间序列分析技术,用于将时间序列分解成趋势、季节性和随机成分(残差)。库方便地对时间序列进行乘法季节性分解,并结合可视化工具分析各个成分的特征和变化趋势。通过这种方式,乘法季节性分解假设季节性变化和随机波动是相
XGBoost(eXtreme Gradient Boosting)是近年来在数据科学和机器学习领域中广受欢迎的集成学习算法。它在多个数据科学竞赛中表现出色,被广泛应用于各种机器学习任务。本文将详细介绍XGBoost的由来、基本原理、算法细节、优缺点及应用场景。
随机森林(Random Forest)原理基于集成学习思想,通过构建多棵决策树并集成它们的预测结果来提高模型的准确性和稳定性。具体来说,随机森林首先通过自助法(bootstrap)从原始数据集中随机抽取多个样本子集,并在每个样本子集上随机选择特征子集来构建决策树。这种随机性确保了每棵决策树都是基于不同的数据和特征进行训练的,从而减少了它们之间的相关性。在预测时,随机森林将多棵决策树的预测结果进行投
2023亚太杯数学建模竞赛(亚太赛A题12题完整代码与结果)
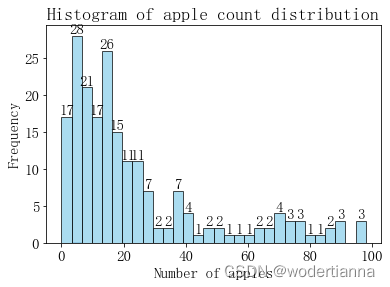
线性回归是一种基础的回归方法,用于建立自变量与因变量之间的线性关系。通过最小化误差平方和来确定最佳拟合直线。