- @weixin_72931638


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
数据标注的工具包括以下几种:LabelImg:一款图形图像标注工具,用Python编写,并将Qt用于其图形界面。可以用于进行目标检测项目的标注工作,支持2D矩形框标注。Labelme:一款开源的图像标注工具,由Visual Geometry Group开发。可以在线和离线使用,支持多边形分割、语义分割、2D框、线标注、点标注。VIA-VGG Image Annotator (VIA):一款开源的图
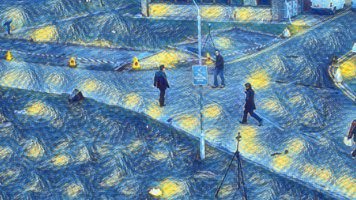
定义: 开源项目OpenCV的深度神经网络模块,主要用于加载和调用已训练好的模型完成预测。特点模块本身仅实现模型推理功能,代码精简。外部依赖性极低,无需复杂的环境部署。提供统一接口(readNet),支持TensorFlow、Caffe、PyTorch等多种框架训练的模型。模型支持多种设备和操作系统。DN模块可用于实现图片的风格迁移,即将图像转化为特定画风。实现流程:加载预训练模型(如星空模型),
处理,支持列名、行索引等结构化操作,适用于金融、股票等领域的Excel数据分析。Pandas底层基于NumPy实现,但功能更丰富(如数据读取、转换、计算等)。Pandas表格数据(数值类型)可直接转换为NumPy数组,两者可互相转化。Pandas的核心功能是将数据以表格形式(
使用 plt.subplot 创建两行两列的子图(共4个),图像大小为10x8(单位未明确)。(如 好评数 > 17000)筛选数据,生成 True/False 序列后提取对应行。Pandas支持多种数据格式,包括CSV、Excel(XLSX/XLS)、TST等。方法筛选数值范围内的数据(如 好评数在15000到17000之间)。index=True(是否导出行索引)。header=True(导出
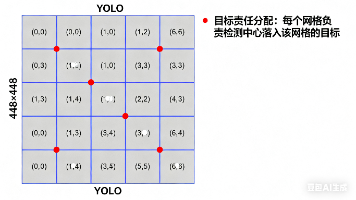
YOLO(You Only Look Once)是一种基于深度学习的目标检测算法,由Joseph Redmon等人于2016年提出。它的核心思想是将目标检测问题转化为一个回归问题,通过一个神经网络直接预测目标的类别和位置。YOLO算法将输入图像分成SxS个网格,每个网格负责预测该网格内是否存在目标以及目标的类别和位置信息。此外,YOLO算法还采用了多尺度特征融合的技术,使得算法能够在不同尺度下对目
TF-IDF用于从文章中提取核心关键词,由两部分组成:TF(词频)和IDF(逆文档频率)。TF(词频):某个词在文章中出现的次数除以文章总词数。例如,若“人工智能”在1000词的文章中出现50次,其TF值为0.05。IDF(逆文档频率):衡量词的区分能力,公式为log(语料库文档总数 / 包含该词的文档数 + 1)。若某词在语料库中罕见,其IDF值较高。TF-IDF 值就是词频与逆文档频率的乘积,
自注意力机制 (Self-Attention Mechanism,当前模型无法处理序列中的词项顺序,因此需要引入自注意力机制来探索单词间的内在联系自注意力机制是Transformer的核心组成部分,旨在捕捉文本中词汇之间的复杂关系,该机制通过计算每个词与其他所有词的关联关系来感知上下文。例如,“it”这个词与其代表的“animal”的关系较重,同时也会关注“because”等其他词的关系。自注意力
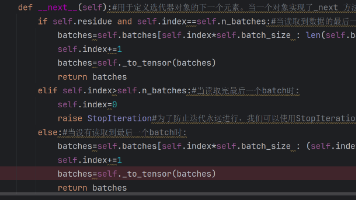
为了再接下来的模型训练过程中我们能够循环迭代的取出数据,所以我们自定义一种数据类型包含__next__()方法--getitem__:是通过索引的方式获取数据对象中的内容。__next__ 是使用 for i in train_iter:迭代获取对象def __next__(self):#用于定义选代器对象的下一个元素。当一个对象实现了_next 方法时,它可以被用于创建迭代器对象。
tqdm用于显示后续for循环进程pkl用于保存后续的词汇表字典文件file_path是微博评论文件地址max_size即为字典最大词汇数min_freq是词的最小出现次数tokenizer是一个函数,用于后续的将评论切割成每个单词vocab_dic用于保存单词的字典。
实际观测值 y 与模型预测值y^之间的差异,即 e = y - y^。线性回归的目标是使所有残差的平方和最小(最小二乘法)