


- @weixin_66005172


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
结构化输出既能约束工具调用参数,也能规定模型最终回复的格式。本文通过同一个联系人案例,梳理 OpenAI、DeepSeek 的接口能力,以及 LangChain 的策略选择、解析校验与实际调用路径。以前,我知道 Function Calling 可以严格规定函数参数,却以为模型最后回复的 text,只能通过提示词要求它“尽量输出 JSON”。后来我发现,从“请按 JSON 回答”到“按 Schem
本文探讨了开源项目ragflow中MCP调用体系的两个关键提示词。高级推理代理提示词通过分解复杂问题为可验证步骤,确保执行精准,其优势在于任务拆解颗粒度精准、工具使用规范明确和结果导向流程设计,但存在缺乏搜索优先级引导、信息足够判断标准不明确等问题。信息提取模块提示词专注于从搜索结果中提取关键信息,优势在于严格限定提取范围、输出格式二元化和目标导向流程设计,但需优化权威来源优先规则、部分相关信息处
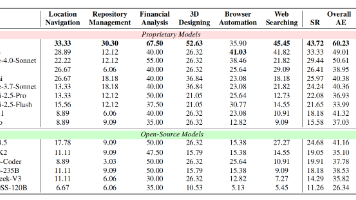
MCP-Universe 就像一面镜子,照出了当前 LLM 工具能力的 “真相”:我们以为的 “会用工具”,只是 “会按按钮”,但真实世界需要的是 “会选工具、会调参数、会处理意外” 的综合能力。论文结尾那句其实很扎心:“即使是 GPT-5 这样的顶级模型,在真实 MCP 环境下的表现,也远没达到实用要求。” 但这不是坏事 —— 只有明确了差距,才能找到前进的方向。毕竟,AI 要帮人类干活,先得在
“调个参而已,怎么比谈恋爱还难?” —— 来自一位深夜跑崩显卡的程序员当你面对一个预训练好的大模型(比如GPT、LLaMA),想让它成为你的专属“打工人”,微调(Fine-tuning)就是必经之路!但微调不是无脑调参,选对方法能让你事半功倍,否则……显卡可能会原地爆炸💥。今天我们就来聊聊:全参数微调 vs PEFT,增量预训练 vs 指令微调,以及如何用HuggingFace的工具优雅“偷懒”
根据任务选预训练模型(
摘要: 传统AI存在“灾难性遗忘”问题,学习新知识时会覆盖旧知识。嵌套学习(NestedLearning)通过分层记忆机制解决这一难题,将AI模型分为快、中、慢多层,分别处理即时信息、短期经验和核心知识。基于此理论的Hope架构进一步引入连续记忆系统(CMS),使AI能动态调整学习策略,显著提升性能。实验显示,Hope在长文本理解和持续学习任务中表现远超传统模型,遗忘率仅7%。这一技术有望推动个人
这一篇就来拆这条日志本身。它是整个系统里——模型看到的历史、界面上的气泡、排错用的时间线、崩溃后的恢复、子 Agent 的分叉,全都从它长出来。
这是真正把"随机行为"变成"确定行为"的关键。入口前置条件(precondition):开工需要的输入满足什么?不满足就立刻 fail-fast,并把错误归因到正确的上游——而不是带着烂输入往下跑,让 pivot 去莫名其妙填 NaN。失败时的契约行为(failure behavior):产不出正常输出时,固定做什么?停、降级、返回标记过的空、还是用上次缓存顶上?这件事必须写死。出口后置条件(po
大多数团队在做这类系统时,往往会埋头堆 Skills、堆 Tool Call,直到某一天 Token 爆炸、或者主 Agent 在长任务中后期开始出现幻觉——即:用静态 Agent 解决 80% 的确定性工作流,仅在遇到无法覆盖的边际场景时,允许主 Agent 尝试"动态组装"并输出一个。的板块(如:数据抓取、财务建模、合规审查)直接封装成固定的 Sub-Agent,主 Agent 仅作为路由进行
约 3500 字 · 阅读需 8 分钟。