


- @weixin_52319505


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
BossNAS是一种新型无监督神经架构搜索方法,通过分块自监督学习解决权重共享空间过大和监督偏差导致的问题。该方法将搜索空间分解为多个块,采用"集成自引导"训练方案:先独立训练每个块,再整体搜索最优架构。研究人员还设计了HyTra混合CNN-Transformer搜索空间,搜索得到的BossNet-T模型在ImageNet上达到82.5%准确率,超越EfficientNet 2
在这过程中,当程序开始现实connecting,要先按下boot按钮,长按,同时按一下en按钮,按完它后,才能松开boot按钮。搜索esp32,然后选择最新版Install(一定要是最新版,哪怕你下载的不是最新版的压缩包,也要选择最新版)注意,串口一般是最新的那个,编号的话则是最大的那个(如我选择的COM5)。如果无法下载,请选择ctrl+click链接,开始手动下载。然后插入esp32-wroo

然后再把export PATH="$HOME/esp/xtensa-esp32-elf/bin:$PATH"加到文件的最后。然后到达该文件被下载的文件夹内(一般是/home/xxx/Download)再解压该文件。如果不知道自己的xtensa-esp32-elf-gcc在哪里,可以直接下载一个。发现输出中并未出现xtensa-esp32-elf-gcc的路径。问题根源:xtensa-esp32-e

本文介绍了SWE-Gym,这是一个创新的软件工程训练环境,包含2,438个真实Python任务实例,每个都配有可执行环境、单元测试和自然语言描述。研究通过SWE-Gym训练语言模型智能体,在SWE-Bench基准测试上取得了最高19%的性能提升。结合验证器模型,系统最终在SWE-Bench Verified和Lite测试集上分别达到32.0%和26.0%的解决率,创下开放权重系统的新记录。该研究突
本文介绍了SWE-Gym,这是一个创新的软件工程训练环境,包含2,438个真实Python任务实例,每个都配有可执行环境、单元测试和自然语言描述。研究通过SWE-Gym训练语言模型智能体,在SWE-Bench基准测试上取得了最高19%的性能提升。结合验证器模型,系统最终在SWE-Bench Verified和Lite测试集上分别达到32.0%和26.0%的解决率,创下开放权重系统的新记录。该研究突
摘要:本文提出SWE-smith工具包,用于自动化生成大规模软件工程训练数据。针对现有数据集规模小、构建成本高的问题,SWE-smith通过四种自动缺陷生成策略(语言模型重写、AST修改、PR撤销、缺陷组合),在128个Python代码库中生成5万条任务实例,规模比现有工作大一个数量级。该工具仅需20小时人工投入,显著降低了数据收集成本。基于SWE-smith数据训练的32B参数模型SWE-age
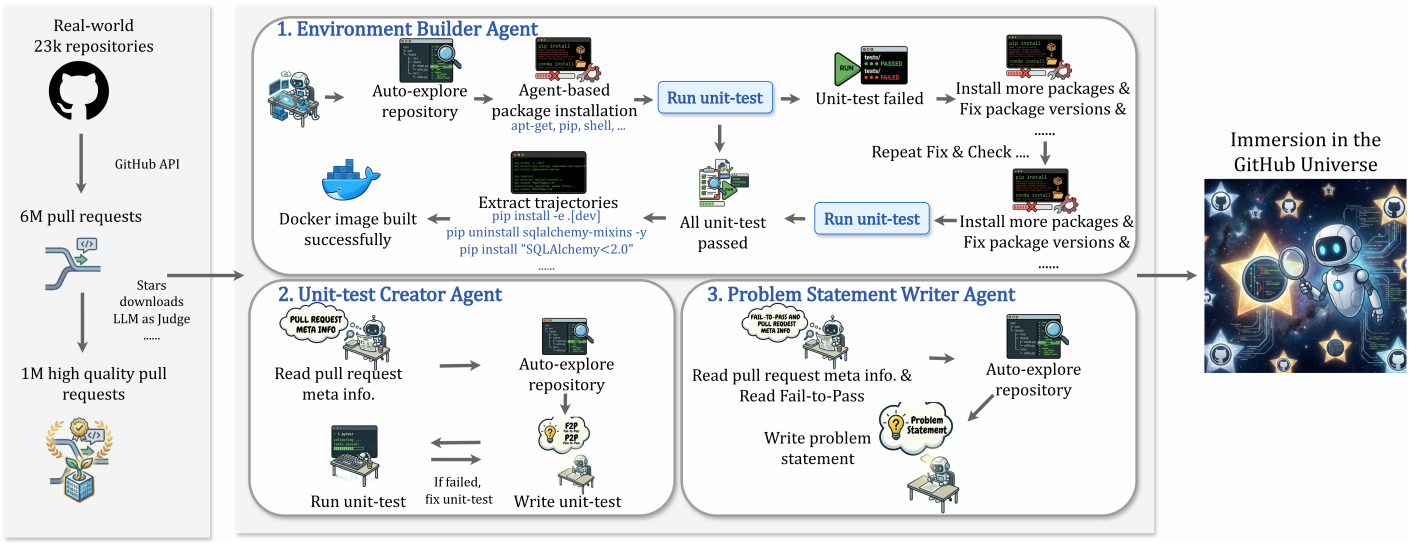
我们将 EBA 的核心功能定义为:将初始的通用 Docker 环境转化为针对特定代码仓库定制的专用运行时容器。该过程可形式化表示为:其中,R 表示智能体用于推断依赖关系和配置逻辑的输入代码仓库,Dinit 为基础 Docker 镜像,Dfinal 为最终生成的功能完备、可直接使用的容器镜像。
查看终端,这里有更详细的报错信息。
优化生产系统中的大语言模型(LLM)推理正变得越来越困难,因为实际负载具有动态变化性,系统又需要满足严格的延迟与吞吐目标,同时可选配置空间也在快速扩大。这种复杂性不仅体现在分布式并行策略上,例如张量并行、流水线并行和专家并行【distributed parallelism strategies (tensor/pipeline/expert)】,也体现在复杂的框架特定运行时参数上。
基于强化学习(RL)的大语言模型(LLM)后训练【post-training】计算成本很高,因为它会生成大量 rollout 序列,而这些序列经常可能共享很长的 token 前缀。现有的 RL 框架通常会独立处理这些序列,在策略模型训练的前向传播和反向传播过程【forward and backward passes】中反复重新计算相同的前缀,从而造成大量计算和内存使用上的低效。