- @weixin_47748259


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
AnyDoor就是“任意门”算法,它可以将任意目标传送到指定场景的指定位置,无需微调,被传送的目标会自动对新的场景进行姿态、角度、动作等方面的调整,确保生成图像的多样性以及和谐度。AnyDoor方法的核心思想在于将目标表征成“ID相关”和“细节相关”的特征,然后将他们组合到与背景场景的交互中。IP-adapter包含编码器和适配器两个部分,将图像特征通过Image Encoder、线性层和LN得到
新建一个python文件(如取名为train),保存以下代码,将对应的模型路径、prompt内容和图片名进行修改即可。新建一个python文件(如取名为train),保存以下代码,将对应的模型路径、prompt内容和图片名进行修改即可。–pretrained_model_name_or_path:Hub 上模型的名称或预训练模型的本地路径。–instance_data_dir:包含训练数据集的文件

一些更“朴素”的滑动窗口方法会为每个查询像素都计算一个以其为中心的局部窗口。Swin Transformer 块保留了标准 Transformer 块的核心骨架,但将其核心的“全局自注意力”机制替换成了专为图像设计的“基于移位窗口的自注意力”机制。原始 Transformer的自注意力计算复杂度是图像大小的二次方,因此无法直接处理高分辨率的图像,限制了其在密集预测任务(如目标检测、语义分
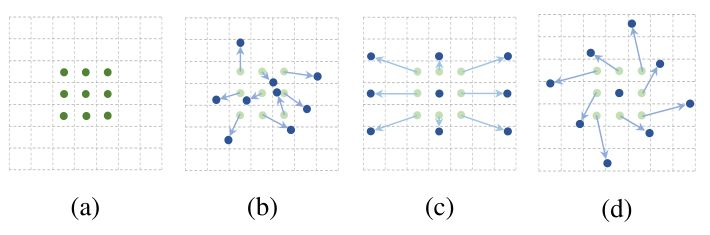
右侧的可变形卷积因为感受野的每一个点都有偏移量,造成卷积核在图片上滑动时对应的感受野的点不会重复选择,这意味着会采样9 x 9=81个采样点,比传统卷积更多。对感受野上的每一个点加一个偏移量 ,偏移的大小是通过学习得到的 ,偏移后感受野不再是个正方形,而是和物体的实际形状相匹配。传统卷积核在卷积过程中由于会存在重叠,最终输出后的感受野范围小,而可变性卷积中因为有偏移,不会有重叠,从而感受野范围更大
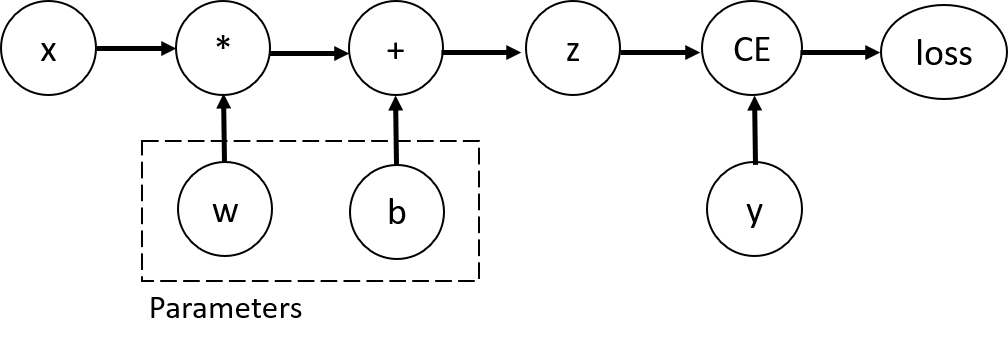
epoch的次数——在数据上迭代的次数;batch Size——在参数更新之前通过网络传播的数据样本的数量;learning Rate——在每个batch/epoch更新模型参数的次数。epochs = 5优化器一般至少有两个参数:需要更新的模型的参数、学习率需要先调用optimizer.zero_grad(),对模型参数的梯度进行重置在pytorch中,参数的梯度会默认进行累计,了防止重复计数,
博主在跌跌撞撞跟随人工智能发展的脚步过程中,越来越发现数学基础的重要性,然而AI领域的迭代速度实在太快,难以沉下心来深耕纯粹的数理知识。学校里的课程知识要么过于枯燥要么难以理解找不到和自己想做的工作之间的关系。所以计划和大模型进行沟通,梳理出自己认为学习LLM,VLM和Agent相关的数学知识,方便自己随时回顾。

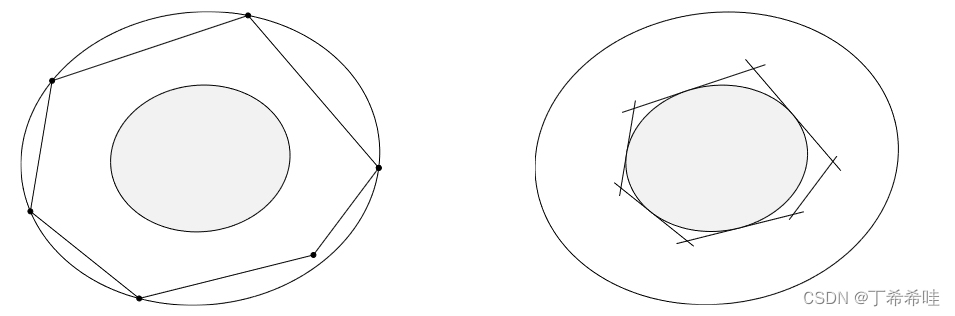
另外,需要注意的是,两组不等式可能描述相同的集合,但其解析中心可能是不同的,这取决于不等式约束的具体形式和约束集合的几何性质。它的作用是通过惩罚违反不等式约束来寻找在约束集内部的点,其中对于任何违反不等式约束的点,其目标函数值会趋于无穷大,因此最小化该目标函数将导致寻找在不等式约束下尽可能远离违规区域的点。在设施选址和布置问题中,我们通常需要在平面或三维空间中放置若干个点,并且这些点之间的某些位置
注意,Fc的维度与UNet降噪器的编码器中的中间特征Fenc = {Fe1nc, Fe2nc, Fe3nc, Fe4nc}相同。在第一阶段,SD 训练了一个自动编码器,它可以将图像 X0 转换为潜在空间,然后重建它们。扩散模型中的时间嵌入是采样的重要条件。T2I-Adapter 具有良好的泛化性,可以支持各种结构控制,包括草图、深度图、语义分割图和关键姿势。因此,为了加强adapter的训练,采用

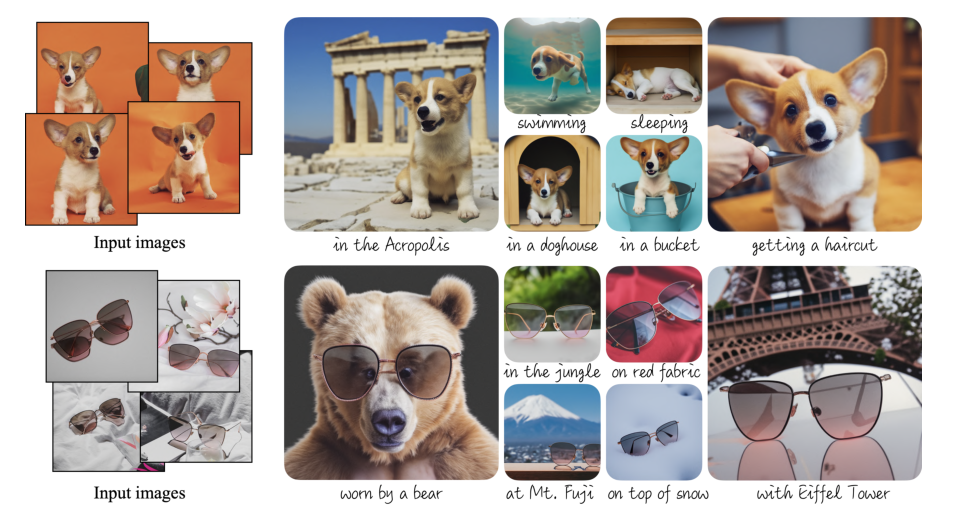
DreamBooth是一种微调文生图扩散模型的方法,最大的特点是Subject-Driven,针对某一个特定的主体,生成在不同的场景、姿势和视角中的该主体上下文图像;DreamBooth的两个主要贡献是:主题驱动生成。给定一些随意捕获的主题图像,目标是在不同的背景下合成主题的新颖再现,同时保持其关键视觉特征的高保真度。用于在少量镜头设置中微调文本到图像的扩散模型,同时保留模型在主题类上的语义知识。