


- @weixin_44369324


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
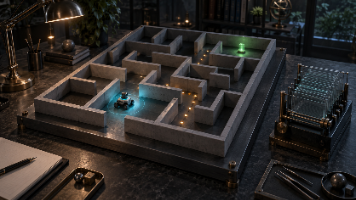
一个智能体没有撞墙,却始终到不了目标,究竟是感知错误、记忆缺失,还是预算太短?本文把具身导航缩小为可逐步审计的迷宫实验:固定局部观测与动作接口,只改变是否保留探索记忆,再用全图规划作为诊断参照。本次实际运行三百六十个回合,保存每一步状态变化,并独立复算成功率、路径效率和奖励。目标是复现交互与评测机制,而非宣称复现真实机器人或论文训练成绩。
学生模型越来越像教师,是否意味着越来越正确?本文围绕这个问题,阅读经典知识蒸馏、序列级蒸馏与 MiniLLM 的论文和官方实现,实际训练一个小型教师与四组学生。复现目标是辨认监督信息、温度和评测口径如何改变结论。实验保留了一个不漂亮但有价值的结果:软目标降低负对数似然,却没有超过真实标签基线的准确率;教师错误也被学生继承。这里验证损失机制与实验协议,不宣称复现大语言模型论文成绩。
2026-04-16 AI论文精选:突破系统瓶颈的4项创新研究 本期论文聚焦AI系统的实际瓶颈问题,而非单纯追求模型规模: 长视频压缩(arXiv:2604.14149)提出LP-Comp和QC-Comp方法,实现每帧仅保留1个关键token,在LVBench上准确率提升3.3%的同时处理帧数翻倍。 预训练空间强化学习(arXiv:2604.14142)突破传统RL局限,通过NSR-PreRL直接
通过医学指令微调、专家反馈和安全对齐,让大模型在医学问答任务上显著提升。证明“通用大模型 + 医疗对齐”是可行路线,但必须叠加安全约束与拒答机制。面对复杂多病共存、指南冲突、罕见病时仍有幻觉风险。AI+医疗的竞争正在从“模型SOTA”转向“系统工程与临床协同”。未来胜出的团队,不是参数最多的团队,而是最懂临床流程、安全边界与持续优化机制的团队。本文仅用于技术学习与交流,不构成医疗建议或诊疗依据。
如果你问我,Med-PaLM 最大的价值是什么。它让我们第一次比较系统地看到,医疗大模型的潜力和风险会同时放大。更强的知识组织能力更灵活的问答与总结能力更统一的基础模型底座更流畅的幻觉更难察觉的错误自信更复杂的责任边界所以真正成熟的 AI+医疗路线,注定不会是“把一个大模型直接丢进医院”。把大模型作为能力核心,再用检索、规则、审计、拒答和人工复核把它圈进可控系统里。从这个意义上说,Med-PaLM
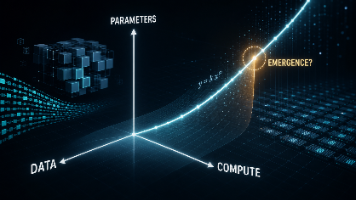
Scaling Laws 不是一句“模型越大越好”,而是一套用小规模实验预测大规模行为的研究方法。Kaplan 等人在 2020 年把语言模型 loss 与参数量、数据量、训练计算量之间的幂律关系系统化;DeepMind 的 Chinchilla 工作在 2022 年把问题改写为“给定 compute budget,参数和 token 应该如何分配”;随后数据受限、多模态、多语言、post-tra
本文给出一套七层阅读法:模型身份、开放范围、许可证、训练数据、训练方法、评测证据、限制与复现资产。案例覆盖 Llama 4、Qwen3、DeepSeek、Gemma、gpt-oss、OLMo 和 Nemotron。目标不是替某个模型背书,而是训练你把模型报告读成一条可核验的证据链。
AI研究正从"泛能力堆高"转向"系统瓶颈拆解"。5篇新论文聚焦关键问题:1)个性化奖励模型仅75.94%准确率,揭示通用与个性化对齐差异;2)Android Agent在线训练通过单状态多动作采样提升1.4倍效率;3)视频生成需解耦物体/相机运动与因果关系;4)病理WSI的MoE路由需显式约束防失衡;5)LLM难以稳定执行语法规则转导,低资源翻译需谨慎。这些
结果上,它在 AndroidLab 和 AndroidWorld 上,相比 UI-TARS-1.5-7B 拿到了 7.5% / 8.3% 的成功率提升,并在同等成功率下实现 1.4x 的训练效率提升。作者指出,很多现有方法默认采用的是 Single State / Single Action,也就是每拿到一个在线状态,只采一个动作样本来更新策略。这篇论文真正值得记住的,不只是 Android Ag
AI研究正转向解决现实约束:5篇新论文揭示关键趋势 Agent世界模型:提出分层框架(预测器/模拟器/演化器)解决不同环境下的动态建模问题,强调环境预测能力比工具调用更重要。 低成本Scaling Law:通过主动实验选择策略,仅用10%预算即可准确预测模型扩展规律,解决传统方法实验成本过高问题。 多图理解:提出CGC方法解决跨图对象混淆问题,通过组合对比训练增强多图归因能力,避免注意力泄漏。 长