- @weixin_38291577


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
深度学习是机器学习的一个重要分支,它通过构建多层神经网络来模拟人脑的学习过程。通过层次化的特征转换,让机器自动从数据中学习复杂的特征表示。深度学习通过多层次的特征学习,在计算机视觉、自然语言处理等领域取得了突破性进展。MLP是基础:全连接网络是深度学习的起点CNN擅长图像:卷积操作有效提取空间特征RNN处理序列:循环连接赋予网络记忆能力LSTM解决长依赖:门控机制精准控制信息流未来发展方向:自监督

对于任意向量u\mathbf{u}uv\mathbf{v}v和标量ccc,变换TTT可加性TuvTuTvTuvTuTv齐次性TcucTuTcucTu假设有一个线性变换TTTA2003A2003对向量v12v12TvA⋅v2003⋅122×10×20×13×226TvA⋅v2003⋅122×10。

支持向量机(SVM)是一种强大的监督学习算法,通过寻找最优决策边界实现分类和回归。其核心思想是最大化两类数据点到边界的距离,关键概念包括超平面、间隔和支持向量。SVM通过数学优化求解,使用拉格朗日对偶问题处理线性可分情况,并引入软间隔和核技巧(如RBF核)应对线性不可分问题。Python实现中,Scikit-learn的SVC模块可快速构建SVM模型,多核函数比较显示不同核的适用场景和性能差异。S

想象你面前有一大堆没有标签的水果,你的任务是根据它们的特征(颜色、形状、大小)自动分成几组。这个过程就是无监督学习的核心思想——让机器在没有明确指导(标签)的情况下,自主发现数据中的内在结构和规律。无监督学习让机器具备了自主探索数据世界的能力。从层次聚类构建的数据家族树,到K-means的高效划分,再到K-medoids的稳健中心点选择,每种方法都有其独特的价值和适用场景。无监督学习的核心是发现数

摘要: 机器学习模型性能的微小差异需通过科学的实验设计和统计检验验证其显著性。关键步骤包括:1)规范划分训练集、验证集和测试集,避免数据泄露;2)采用交叉验证提高评估稳定性;3)基于假设检验(如z检验、t检验)量化差异的统计显著性,区分随机波动与真实提升。实践中需注意效应量、业务价值及常见陷阱(如多次比较、数据泄露)。案例表明,仅凭数值差异可能得出错误结论,需结合统计检验与业务需求综合决策。(15

模型性能评估不是简单的数字比较,而是对不确定性的科学管理。通过深入理解二项分布、置信区间和中心极限定理,数据科学家能够像“侦探”一样,从有限的测试数据中提取最大信息量,为业务决策提供坚实依据。在机器学习日益深入关键决策的今天,掌握这些统计工具不仅是一种技术能力,更是一种职业责任。唯有科学评估模型性能,才能确保AI应用既创新又可靠。本文基于统计学习理论,结合实际业务场景,提供了模型评估的实用框架。文

在机器学习的世界里,有一种方法与众不同——它不构建复杂的数学模型,而是像人类一样通过记忆和类比进行推理。这就是**基于实例的学习**,今天我们就来深入解析这一直观而强大的学习方法
集成学习通过组合多个弱学习器构建强学习器,提升机器学习性能。其有效性源于:1)克服单一经验法则局限;2)解决假设空间多解性;3)避免局部最优;4)逼近真实假设空间。主要方法包括:1)加权多数算法,通过动态调整基学习器权重进行投票;2)Bagging,采用自助采样训练多个基学习器后投票或平均。Python实现显示,Bagging集成50棵决策树比单棵决策树准确率提升显著(如从0.86提升至0.92)
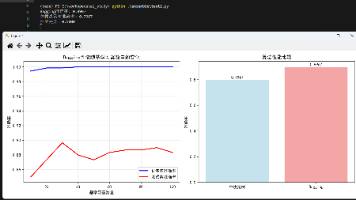
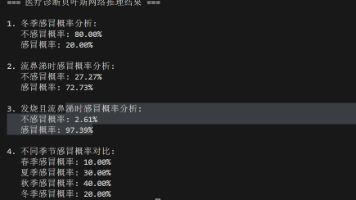
概率论是研究不确定性的数学工具,在AI和深度学习中发挥着核心作用。文章系统介绍了概率论的基本概念体系,包括三大公理、不同概率解释视角(古典、频率、主观),以及条件概率、贝叶斯定理等核心理论。重点阐述了概率分布在AI中的应用,如朴素贝叶斯分类器、概率图模型等,并通过Python代码示例展示了贝叶斯推理在垃圾邮件过滤和天气预报中的实际应用。概率论不仅为深度学习提供了数学基础,也是构建智能系统处理不确定
摘要:优化算法是深度学习的核心,通过高效调整模型参数来最小化损失函数。本文介绍了梯度下降和随机梯度下降(SGD)两种基础算法:梯度下降通过计算整体数据梯度逐步逼近最优解,适合小规模数据;SGD则利用单个样本梯度实现高效训练,能有效避免局部最优但收敛不稳定。通过代码示例展示了算法实现过程,并可视化损失下降曲线和参数收敛路径,帮助理解不同优化方法的特点与应用场景。