


- @u012374012


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
self.names = ["face", "person","car","bicycle"]##换成自己模型对应的类名即可。index = scores.argsort()[::-1]# 对检测框按照置信度进行从高到低的排序,并获取索引。对输入的图片进行目标检测,返回对应的类别的检测框,并可视化输出。x[:, :4]表示box(从二维看第0,1,2,3列):param iou_thresh: I

在(二)的基础上需要勾选 BUILD_opencv_python3选项,然后再生产的lib里面有cv2.cp38-win_amd64.pyd文件即可。需要勾选camke里面和cuda相关的选项,以及注意第三次配置的时候的gpu计算能力,否则可能会报错。Linux平台最好用命令行的方式编译。选中world选项,输入opencv_contrib_module路径。勾选WITH_CUDA、OPENCV_

也是闲着,看到我伦的qq音乐的收听量居然才520万,伤心。就抓下其他歌手的收听量,做个对比。用到HtmlAgilityPack,Newtonsoft.Json 1. [代码][C#]代码 //设置listview的相关属性listView1.GridLines= true;listView1.View= View.Details;
add_perm = False # 如果设置成True,则将模型输入layout修改成NHWC。
1.配置easydarwin-ini里面的端口,打开easydarwin.exe 查看端口号是否成功,若不成功,则需要修改。5.在Demo中输入 rtsp://localhost:551/test,则显示视频。推流后需要推一段时间再打开Demo.exe。3.用ffmpeg打开视频。4.在网页端查看推流信息。2.在web网页打开。

转 gguf / turbomind 等格式部署(视情况选择)。LoRA Rank 一般 32/64 起步,结合资源调整。控制单图分辨率上限,别设太大容易炸显存。微调后权重合并:swift export。数据集可用 JSONL,一行一个样本。会自动识别视觉编码器。
代码中示例为320,从原始大图变成320*320,加上letterbox和坐标变换。

import osimport cv2continuecontinue= ""]

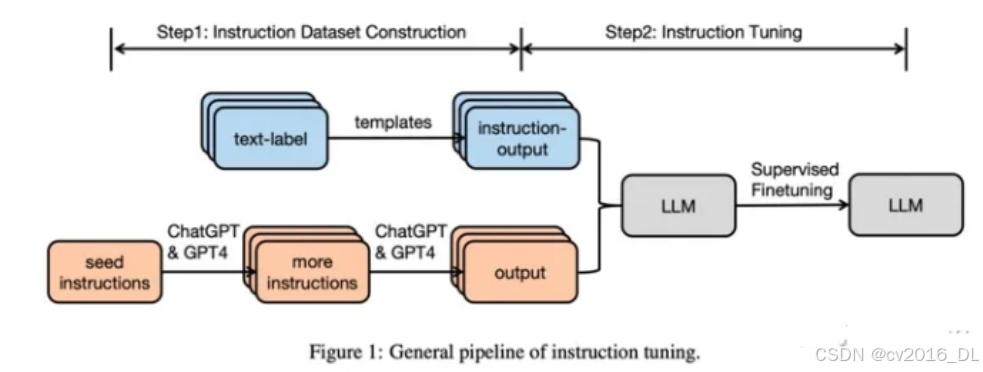
Self-Instruct(https://arxiv.org/abs/2212.10560):一个通过预训练语言模型自己引导自己来提高 的指令遵循能力的框架。回译在传统的机器学习中是一种数据增强方法,比如从中文翻译成英文,再从英文翻译会中文,这 样生成的中文与原来的中文在语义上是一致的,但是文本不同;
机器人视觉的基本概念1.摄像机标定(Camera Calibration):对摄像机的内部参数、外部参数进行求取的过程。2.视觉系统标定(Vision System Calibration):对摄像机和机器人之间关系的确定。3.手眼系统(Hand-Eye System):又摄像机和机械手构成的机器人视觉系统。4.Eye-in-Hand:摄像机安装在机械手末端并随机械