- @submarineas


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本篇主要想关于openvino针对于yolov5的一些转换流程,以及会带有查阅资料了解到的openvino的相关demo与一些需要注意到的点进行总结。关于openvino,有人说是基于CPU上最快的模型加速套件,这当然是显而易见的,因为在我印象里除了Intel本尊,没有啥企业会做这种事情了,emmm。。。openvino相较于传统的cv pipeline,它具有的优势如下:不过这对比的对象就有点老
::info💡在一文中介绍了目前未开源的sora模型可能涉及到的技术点,包括介绍了Vision Transformer,作为transformer正式用于图像的一种范式,为本文中将提到的内容打下基础,同时一文对diffusion model的数学原理推导,也为后来模型的演化提供更加完整的认识。而本文将要介绍的是后来的ViViT与DiT两种模型架构,并对其进行了更进一步的源码分析。
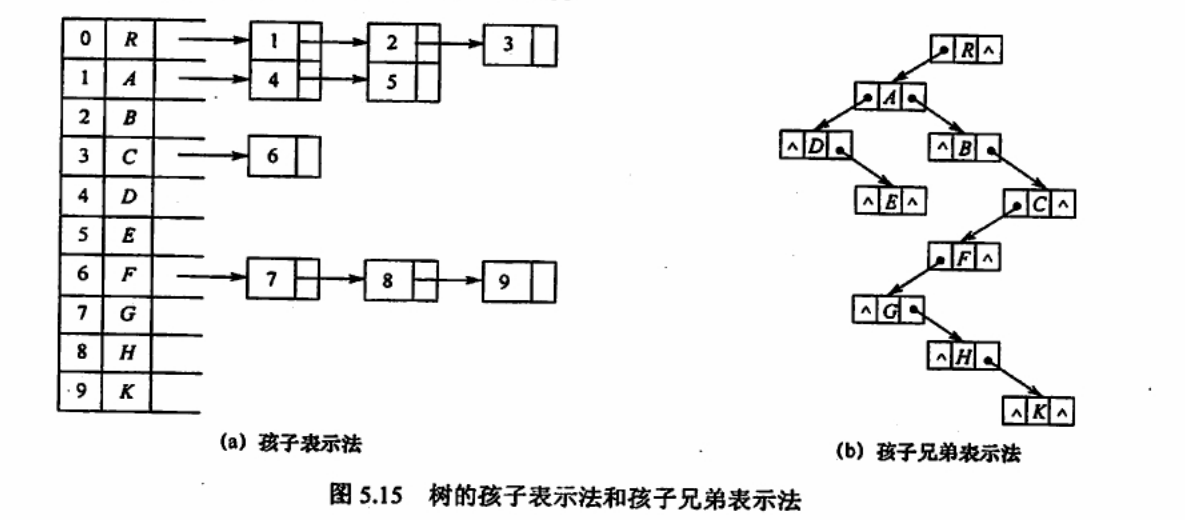
数据结构非代码题总结
源码地址libx264 http://download.videolan.org/x264/snapshots/ 最新版yasm http://yasm.tortall.net/Download.html 版本为yasm-1.3.0(yasm是汇编编译器,因为ffmpeg中为了提高效率用到了汇编指令)ffmpeg http://www.ffmpeg.org/download.html 版本为ffm
引言关于数组numpy的含义以及优劣势引言很久没有更文了,最近正在找工作。那么话不多说,让我们进入正题。关于数组数组应该是数据结构里用得最频繁的,也是构建其它复杂类型的结构,这里我就不再过多说明了,只想提一点,因为我的博客主要是以python为主,但python的基础模块中是没有数组这种数据结构的,用了列表来代替。如果我们需要用数组的话,需要导入数据分析的模块,没错,就是numpy,下面...
检索增强生成(RAG)是指对大型语言模型输出进行优化,使其能够在生成响应之前引用训练数据来源之外的权威知识库。大型语言模型(LLM)用海量数据进行训练,使用数十亿个参数为回答问题、翻译语言和完成句子等任务生成原始输出。在 LLM 本就强大的功能基础上,RAG 将其扩展为能访问特定领域或组织的内部知识库,所有这些都无需重新训练模型。这是一种经济高效地改进 LLM 输出的方法,让它在各种情境下都能保持
引言本篇想大概记录一下在这之前所遇到的一些问题,主要是从一些安装过程,还有一些不当方式进行总结。docker中安装ssh首先需要在docker里面安装ssh,一般跟宿主机一样,在docker里的操作为:root@xxxxx:/# apt-get updateroot@xxxxx:/# apt-get upgraderoot@xxxxx:/# apt-get install vimroot@xxxx
赛题数据赛题来源自Google街景图像中的门牌号数据集(The Street View House Numbers Dataset, SVHN),并根据一定方式采样得到比赛数据集。FieldDescriptiontop左上角坐标Yheight字符高度left左上角坐标Xwidth字符宽度label字符编码评价标准为准确率,选手提交结果与实际图片的编码进行对比,以编码整体识别准确率为评价指标,结果越
引言最近刚在实验楼做了这个关于知识图谱的课程,想总结点什么,也勾起了我的一点回忆,因为最早我写博客就是为了记录一些我对web与nlp还有爬虫的笔记,博客标签上就是标的这些。结果最后发现这三者我都没有在继续做下去了,而是工作于视频图像,有够戏剧化的,所以这里,想找回一点当年那种感觉。知识图谱架构根据一文揭秘!自底向上构建知识图谱全过程,构建知识图谱一般分为3个部分,分别为:信息抽取:从各种类型的数据
DeepWalk可以说给大家带来了全新的思路,其意义远不止实验结果那么简单。理论上,对于任何图数据,或者是由关系型数据抽象出来的图数据,都可以利用DeepWalk得到Embedding,而且算法简单,易于扩展到大规模数据上;更为重要的,这启发了后续的研究者进行了更加深入的研究。node2vec的作者针对DeepWalk不能用到带权图上的问题,提出了概率游走的策略,并使用AliasSampling进