


- @sdlcjx


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
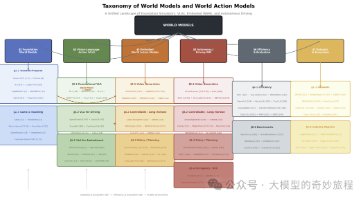
本文综述了具身世界动作模型(WAM)的最新进展,系统梳理了六大技术支柱:基础世界模型、视觉-语言-动作(VLA)模型、具身WAM、自动驾驶世界模型、效率与评测、数据集与生态。研究显示,世界模型正从被动视频预测器演进为可交互的物理仿真器,而VLA模型则建立了连接语义意图与运动控制的桥梁。二者的融合催生了WAM这一新型架构,使智能体能够通过"想象"未来状态来规划动作。文章重点分析了
具身智能系统对三维内容的需求正从"视觉逼真"转向"仿真就绪"。香港科技大学领衔的研究团队系统梳理了面向具身智能与机器人仿真的三维生成技术,提出以"数据生成器—仿真环境—Sim2Real桥接"为核心的三角色分类体系,涵盖从仿真就绪资产生产、可交互世界构建到虚实迁移闭环的完整技术链路。
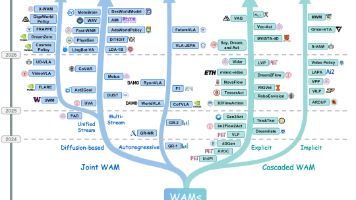
视觉-语言-动作(VLA)模型与世界动作模型(WAMs)的融合正在推动机器人学习从反应式控制向预见性推理转变。VLA模型虽在语义泛化方面表现优异,但其反应式特性限制了长程任务的执行能力。WAMs通过联合建模未来状态与动作的联合分布,为机器人提供预测性推理能力。本文系统梳理了WAMs的架构分类(级联式与联合式)、技术路线、数据生态与评估体系,揭示了这一快速演进领域的发展趋势。级联式WAM保持预测与执
北京人形机器人创新中心发布全球首个统一具身智能模型Pelican-Unify 1.0,实现了理解、推理、想象与行动的闭环融合。该模型突破传统模块化架构局限,通过共享语义空间、语言锚定思维链和联合去噪生成三大创新设计,将多模态认知统一整合。测试显示,该模型在视觉理解、运动控制和世界预测三项专业能力上均表现优异,其中多模态基准测试得分64.7分,显著超越同类模型。这一突破为具身智能发展提供了新范式,使
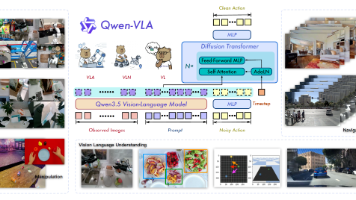
摘要: Qwen Team提出统一视觉-语言-动作基础模型Qwen-VLA,突破传统具身智能研究中任务、环境与机器人本体割裂的局限。该模型采用"认知主干+运动专家"双模块架构,通过四阶段渐进训练策略(文本到动作预训练、持续预训练、监督微调、强化学习),在涵盖操作、导航、轨迹预测等异质任务的大规模数据集上实现统一建模。核心创新包括:1)将不同具身任务统一为条件预测框架;2)本体感知提示条件机制实现跨
本文介绍了Ant Group研究团队开发的LingBot-Video模型,这是一个基于扩散Transformer(DiT)和稀疏混合专家(MoE)架构的面向具身智能的视频生成模型。该模型通过统一的任务处理框架和MoE设计,在保持高效推理的同时提升了模型容量,显著改善了视频生成的物理合理性和任务完成度。研究团队还构建了专门的多模态数据集,并设计了数据画像引擎和结构化标注方法优化训练数据。实验表明,M

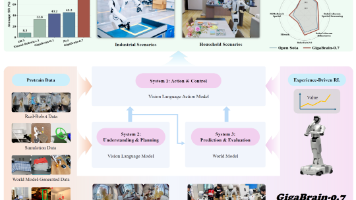
GigaBrain-0.7 通过三系统架构与大规模异构数据预训练,为具身基础模型的发展提供了一条可扩展的技术路径。其在理解、预测与执行层面的深度协同,不仅提升了模型在单一任务上的执行精度,更重要的是赋予了模型跨本体、跨任务与跨场景的通用性与适应性。从 37000 小时异构数据中的预训练,到世界模型驱动的后训练,再到基于 rollout 经验的持续强化,GigaBrain-0.7 展示了一个具身智能
WRC2026是具身智能产业发展的一个重要里程碑。具身智能的"试用期"正在结束,行业正从技术验证期进入产品化落地期。工业搬运、零售拣选、餐饮服务等场景已具备小批量商用条件;具身大模型、灵巧手、数据采集等底层技术快速迭代;轮式人形成为落地首选形态。但同时也要清醒地看到,当前的"能干活"更多是在半结构化、预定义场景中的有限能力。真正的通用具身智能——能够在任意非结构化环境中自主理解任务、规划多步骤操作
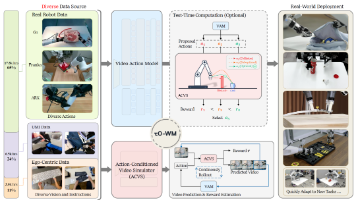
上海人工智能实验室与AGIBOT Finch团队提出的τ0-World Model(τ0-WM)创新性地整合了视频预测、动作生成与评估功能,通过共享视频扩散骨干网络实现了多源异构数据的联合训练。该模型在27,300小时的机器人遥操作、UMI式演示和人体交互视频数据上进行训练,采用统一监督掩码机制处理不同数据源的差异。τ0-WM包含视频动作模型(VAM)和动作条件化视频模拟器(ACVS)双分支,分别
盘古5.0的STCG技术,正在从三个维度重塑自动驾驶开发范式:表格维度传统模式盘古STCG模式数据成本百万公里路测,人力物力高昂云端大规模并行生成,边际成本趋近于零场景覆盖依赖自然采集,长尾场景稀疏按需生成极端场景,实现"场景自由"标注精度人工标注存在误差与成本瓶颈生成过程自带完美标注(3D框、轨迹、语义分割)更重要的是,由于STCG生成的视频在几何一致性、物理合理性与视觉逼真度上均达到工业标准,